
zettabrain-rag
ZettaBrain RAG es un asistente de documentos privado y auto-alojado que permite consultar archivos locales mediante una pipeline RAG completa sin claves API ni nube. Incluye plataforma Skills con 21 generadores predefinidos para documentos empresariales, soporte multi-LLM (Ollama, Claude, Gemini, Op
Ficha actualizada 28 sept 2026, 15:50 · upstream 28 sept 2026, 15:33 · release v0.5.28
Qué es zettabrain-rag
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
ZettaBrain RAG es un asistente de inteligencia artificial auto-alojado diseñado para consultar documentos corporativos mediante una pipeline RAG (Retrieval-Augmented Generation) completamente local. El sistema permite interactuar con archivos en lenguaje natural a través de interfaz web o terminal, sin que los datos abandonen el equipo del usuario.
La plataforma incluye 21 Skills predefinidos organizados por categorías: Business (resúmenes ejecutivos, propuestas de proyecto, informes de estado), Technical (documentación API, registros de decisiones), Operations (procedimientos SOP, runbooks, notas de versión), Compliance (auditorías) y HR/Training. Los usuarios pueden crear Skills personalizados añadiendo archivos Markdown al directorio correspondiente.
El sistema utiliza una pipeline de recuperación híbrida de cinco etapas: chunking adaptativo por tipo de documento, búsqueda semántica MMR vía ChromaDB, búsqueda BM25 por keywords, fusión y deduplicación por hash de contenido, y re-ranking con cross-encoder FlashRank. Soporta múltiples proveedores de LLM incluyendo modo Trial con 25 peticiones gratuitas sin claves API.
- Consultar políticas corporativas y procedimientos internos mediante preguntas en lenguaje natural sobre documentos almacenados localmente
- Generar documentos empresariales precisos como propuestas, respuestas a RFPs, informes de cumplimiento y contratos basados en el corpus documental propio
- Evaluar sistemas RAG alternativos con datasets de prueba realistas para servicios financieros y sanitarios antes de usar datos sensibles
- Operar sin dependencia de APIs externas mediante modelos locales Ollama o probar funcionalidades con el modo Trial sin configuración inicial
- Pipeline RAG híbrida de cinco etapas con re-ranking FlashRank para recuperación precisa de chunks relevantes
- Plataforma Skills con 21 generadores predefinidos más capacidad para crear Skills personalizados vía Markdown
- Soporte multi-LLM nativo: Ollama local, Claude, Gemini y cualquier API compatible con OpenAI
- Procesamiento nativo de múltiples formatos: PDF, DOCX, TXT, Markdown y Excel sin conversión externa
- Modo Trial con 25 peticiones gratuitas para evaluación inmediata sin claves API ni descarga de modelos
- Integración OneDrive para Microsoft 365 y soporte NFS/SMB para almacenamiento distribuido
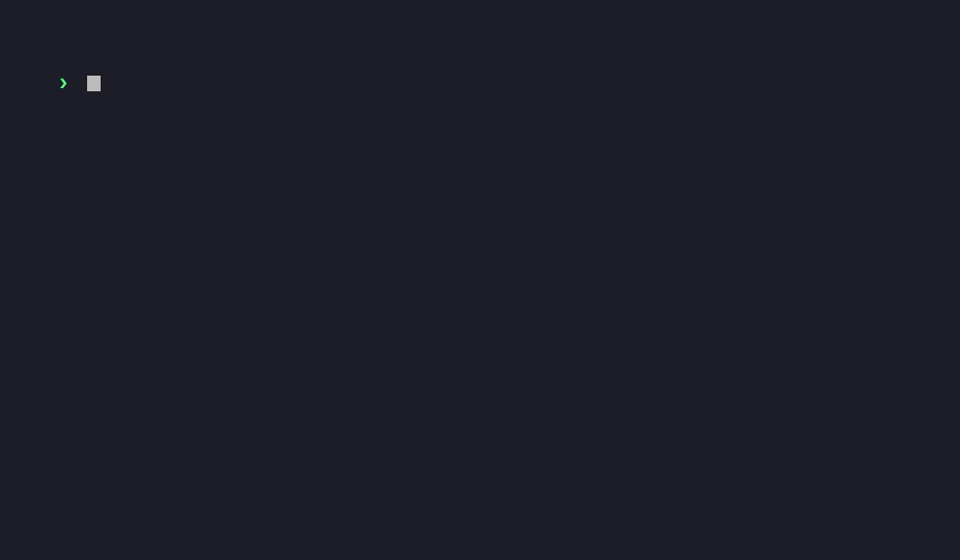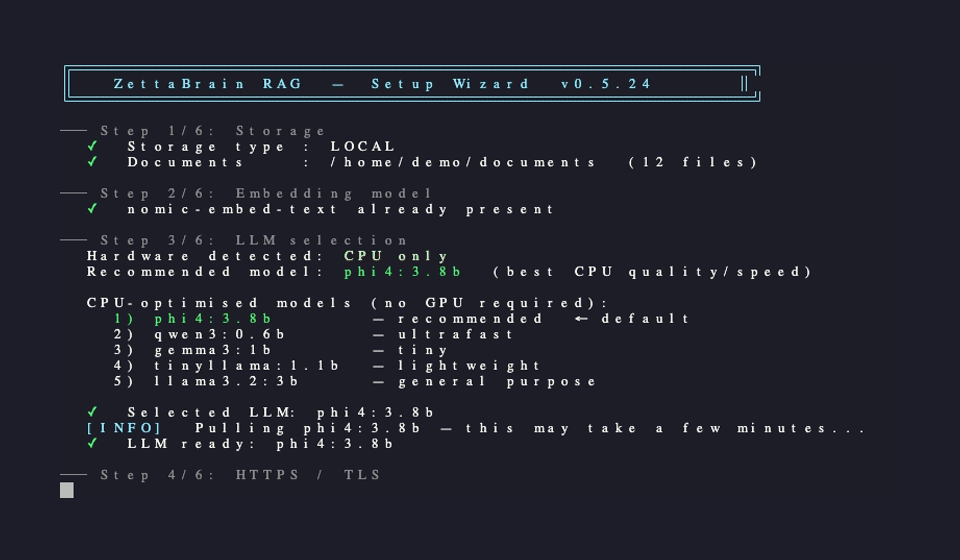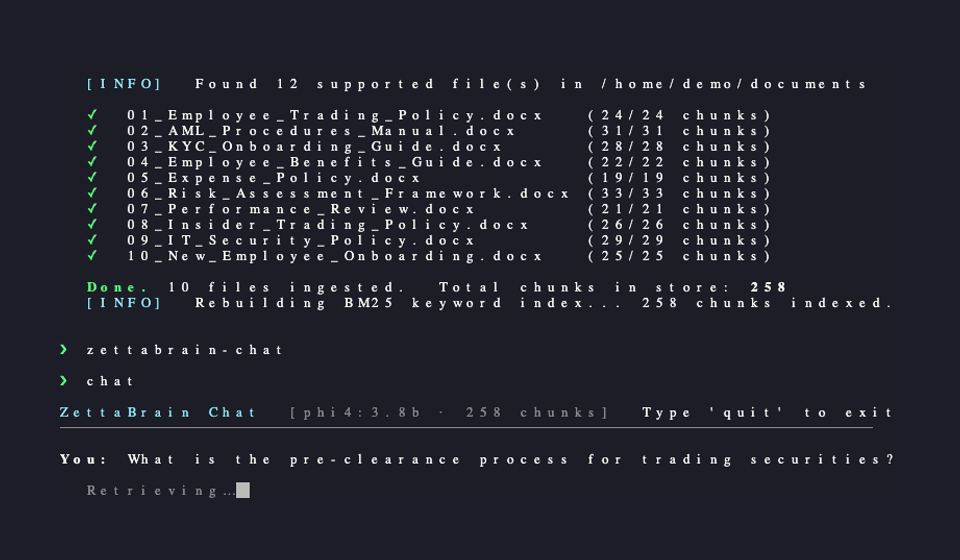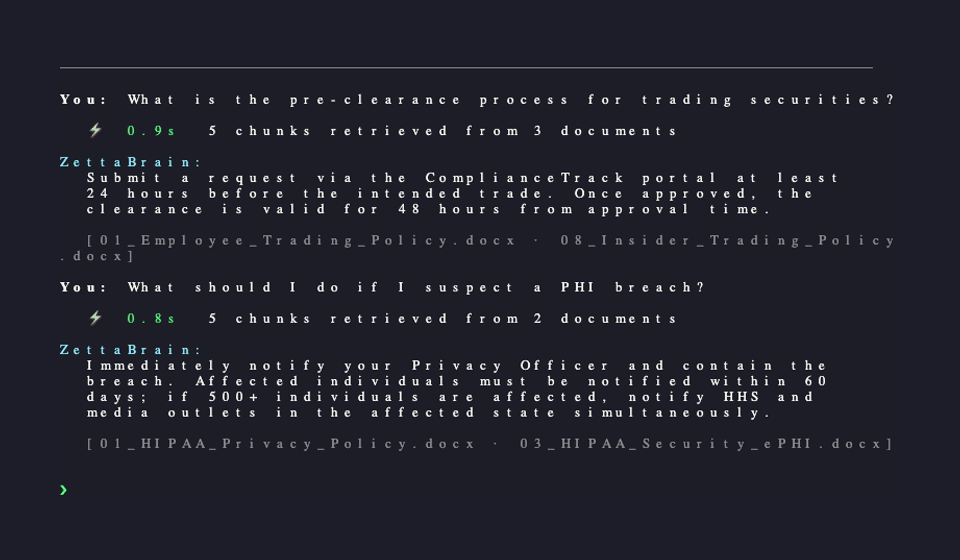
- Requiere Python 3.10+ y Ollama con modelo nomic-embed-text para embeddings por defecto
- El modo Trial no incluye modelos descargados; requiere configuración manual de LLM para producción
- Dependencia de ChromaDB como almacén vectorial local sin soporte nativo de bases externas
- Recomienda 8 GB RAM mínimo (CPU) o 16+ GB para GPU según modelos seleccionados
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Instalar vía pipx o script oficial. Ejecutar sudo zettabrain-setup para configurar almacenamiento, modelo y TLS. Lanzar con zettabrain-server (puerto 7860), zettabrain-chat para terminal o zettabrain-ingest para procesar documentos. Editar /opt/zettabrain/src/zettabrain.env para cambiar proveedor LLM o modelos.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.