
wendao
Wendao es una herramienta auto-alojada para transcripción de reuniones y medios con diarización de hablantes y resúmenes IA. Prioriza la privacidad, ejecuta modelos Whisper en GPU local y usa Ollama para minutos IA sin enviar datos externos.
Ficha actualizada 28 sept 2026, 13:46 · upstream 28 sept 2026, 13:40 · release sin release detectada
Qué es wendao
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Wendao es una plataforma auto-alojada diseñada para transcripción de audio y video con diarización de hablantes y generación de resúmenes mediante IA. La arquitectura se basa en Next.js 16 para el frontend, Fastify + tRPC para la API backend, Python FastAPI para el servicio ASR, PostgreSQL como base de datos y Ollama para modelos locales de LLM. El sistema procesa archivos subidos a través de un estado máquina: transcoding con ffmpeg, transcripción con WhisperX/faster-whisper, diarización con DiariZen/pyannote y segmentación.
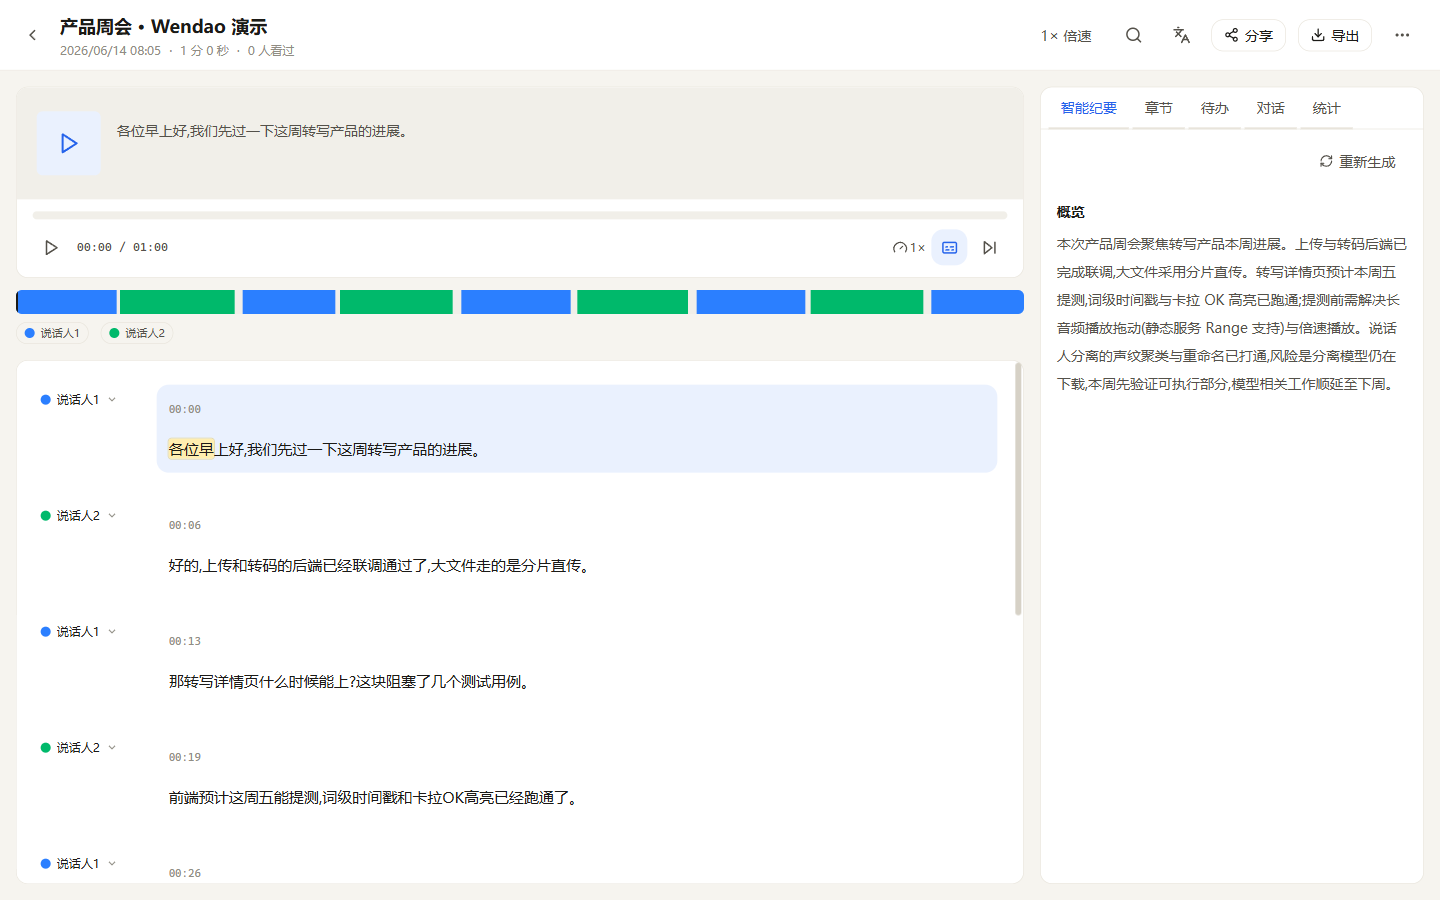
La herramienta destaca por su enfoque en la privacidad, manteniendo todos los datos en servidores locales sin enviar audio o contenido a servicios externos. Los minutos IA se generan bajo demanda mediante modelos locales como qwen3:30b-a3b, permitiendo resúmenes, puntos clave, riesgos y extracción de tareas con citas al texto original. La transcripción incluye resaltado karaoke por palabra, reproducción sincronizada y traducción a chino/japonés/inglés.
El proyecto utiliza Turborepo para monorepo con pnpm, compartiendo esquemas Zod entre paquetes. Incluye Docker Compose para despliegue rápido con PostgreSQL incluido. El servicio ASR requiere GPU CUDA para rendimiento práctico, aunque funciona en CPU con menor velocidad. La autenticación es mínima (x-user-id header), recomendando capa de auth real antes de exponer públicamente.
- Transcripción automática de reuniones internas con identificación de hablantes por huella vocal
- Generación de resúmenes ejecutivos con citas al texto original para auditoría
- Análisis de contenido con chat contextualizado en la transcripción grabada
- Traducción de transcripciones a múltiples idiomas con versión bilingüe
- Exportación de transcripciones a formatos SRT/TXT/DOCX para uso externo
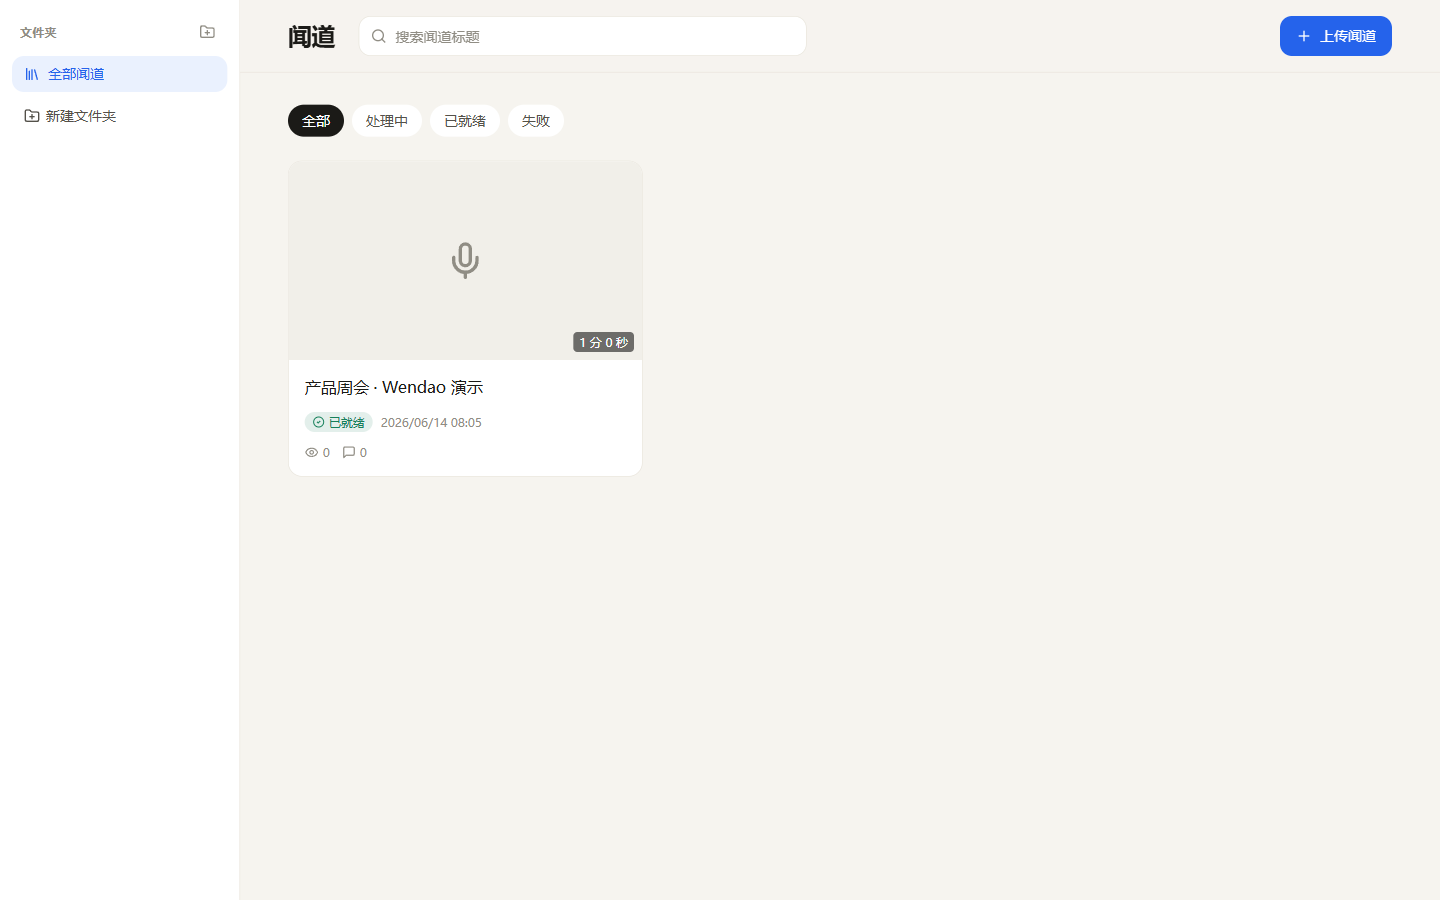
- Organización de archivos por carpetas con búsqueda full-text y estadísticas por hablante
- Arquitectura modular con microservicios separados (ASR, API, Web) escalables
- Privacidad total: todos los datos procesan localmente sin salir del servidor
- Diarización de hablantes con modelos MIT y opción no comercial clara documentada
- Generación de minutos IA bajo demanda sin bloquear la disponibilidad de transcripción
- Integración nativa con Ollama para LLM locales sin dependencia de APIs externas
- Exportación multi-formato (SRT, TXT, DOCX, Markdown) con etiquetas opcionales
- Autenticación mínima por header x-user-id, requiere capa adicional antes de exposición pública
- Interfaz actual solo en chino simplificado, sin soporte i18n implementado
- Servicio ASR requiere GPU CUDA para rendimiento práctico, CPU es lento
- Modelos DiariZen opcionales tienen licencia CC-BY-NC-4.0 no comercial
- Comentarios de código mixtos chino-inglés por origen del equipo
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.

Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Requiere Node ≥20, pnpm ≥9, PostgreSQL 16, ffmpeg/ffprobe en PATH y Ollama con modelo qwen3:30b-a3b. Para ASR se necesita Python 3.11/3.12 y GPU CUDA. Usar docker compose up -d postgres api worker web para stack Node; activar perfil asr opcionalmente con --profile asr. Crear .env desde .env.example antes de ejecutar migraciones.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.