
trawl
Motor de scraping auto-alojado que resuelve desafíos JS y captchas (Cloudflare, Turnstile). Reemplaza FlareSolverr para stacks *arr. Soporte MCP para agentes IA con extracción estructurada y screenshots.
Ficha actualizada 28 sept 2026, 2:27 · upstream 28 sept 2026, 2:17 · release v1.7.0
Qué es trawl
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
TRAWL es un motor de web scraping auto-alojado diseñado para automatización y agentes de inteligencia artificial. Utiliza una arquitectura de ejecución en cuatro niveles, escalando desde peticiones HTTP simples hasta sesiones de navegador cacheadas o proxies residenciales cuando se detectan protecciones anti-bot. Está construido sobre Next.js y Node.js, gestionando estado en Redis.
Ofrece compatibilidad drop-in con FlareSolverr para integrarse directamente en ecosistemas *arr como Prowlarr, Sonarr o Jackett. Además, expone herramientas MCP nativas que permiten a los agentes leer páginas como Markdown, extraer datos JSON y diagnosticar actividad del navegador sin necesidad de búsqueda web.
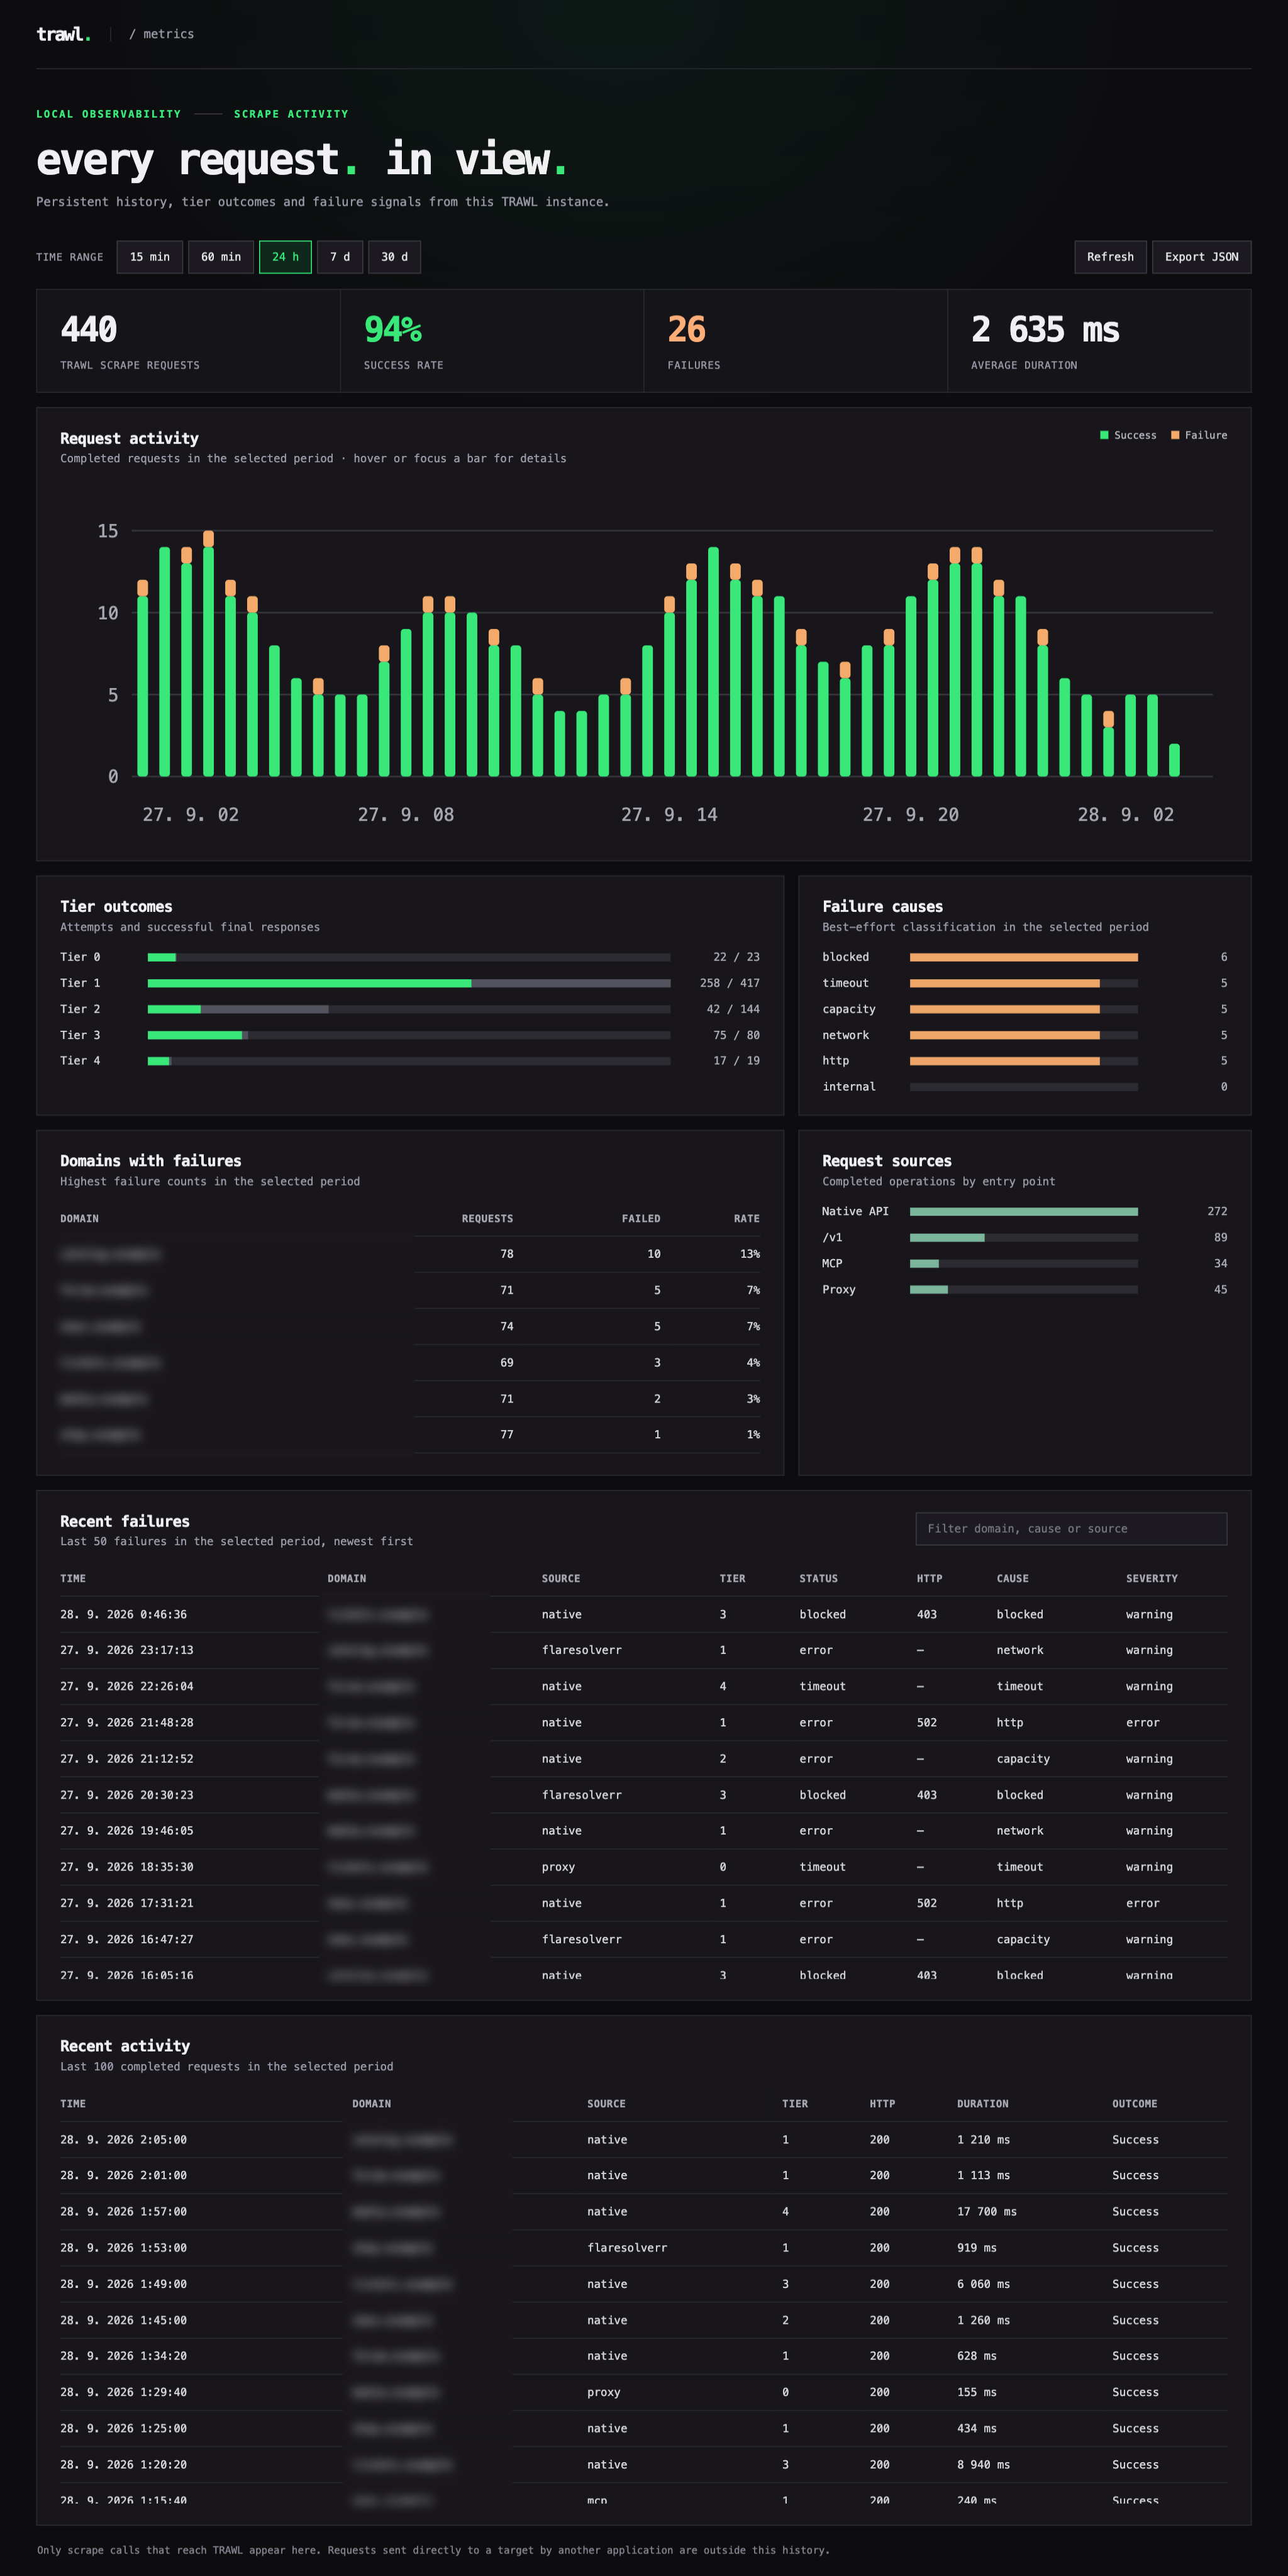
El sistema incluye un proxy MITM integrado para manejar certificados SSL en clientes externos y un panel local de métricas para monitorizar el historial de peticiones, tiempos de respuesta y causas de fallo. Soporta resolución nativa de captchas como reCAPTCHA v2, hCaptcha y GeeTest mediante servicios gratuitos o locales.
- Integración en stacks *arr (Prowlarr, Sonarr) para scraping de indexadores
- Extracción de datos estructurados y screenshots para agentes IA vía MCP
- Bypass de protecciones WAF como Cloudflare y Akamai en peticiones HTTP/HTTPS
- Monitorización local de métricas de scraping con dashboard persistente
- Captura de sesiones de navegador cacheadas para reducir latencia en solicitudes repetidas
- Resuelve captchas nativos (Cloudflare, Turnstile, reCAPTCHA, hCaptcha) sin API de pago
- Reemplazo drop-in compatible con FlareSolverr y Byparr para *arr
- Soporte MCP nativo para agentes IA con herramientas de lectura y extracción
- Proxy MITM integrado para manejar certificados SSL en clientes externos
- Dashboard local persistente para métricas, tiempos y causas de fallo
- Navegador Camoufox patcheado a nivel C++/Juggler para reducir señales de automatización
- Requiere instalación manual del certificado raíz CA en el cliente externo para usar HTTPS con proxy MITM
- No proporciona funcionalidad de búsqueda web ni ranking, solo scraping de URLs conocidas
- Latencia inicial de 15-30 segundos al arranque por calentamiento del pool de navegadores
- Cookies no portables directamente para indexadores que re-fetchean sin usar el proxy MITM
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Desplegar con Docker Compose. Persistir volumen /data/proxy-ca para certificados MITM. Exponer puerto 8191 (API) y 6379 (Redis). Instalar CA raíz en clientes externos antes de usar proxy HTTPS. Configurar MITM_ENABLED=true solo en redes privadas o localhost. Usar MITM_MAX_TIER=4 para limitar escalado a proxies residenciales si es necesario.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.