
tensors-router
Router para IA local que presenta múltiples máquinas como un único punto de acceso API, gestionando modelos de texto, imagen, embeddings, voz y música con backends como KoboldCpp, llama.cpp y vLLM.
Ficha actualizada 23 sept 2026, 19:19 · upstream 23 sept 2026, 19:09 · release v0.7.0
Qué es tensors-router
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
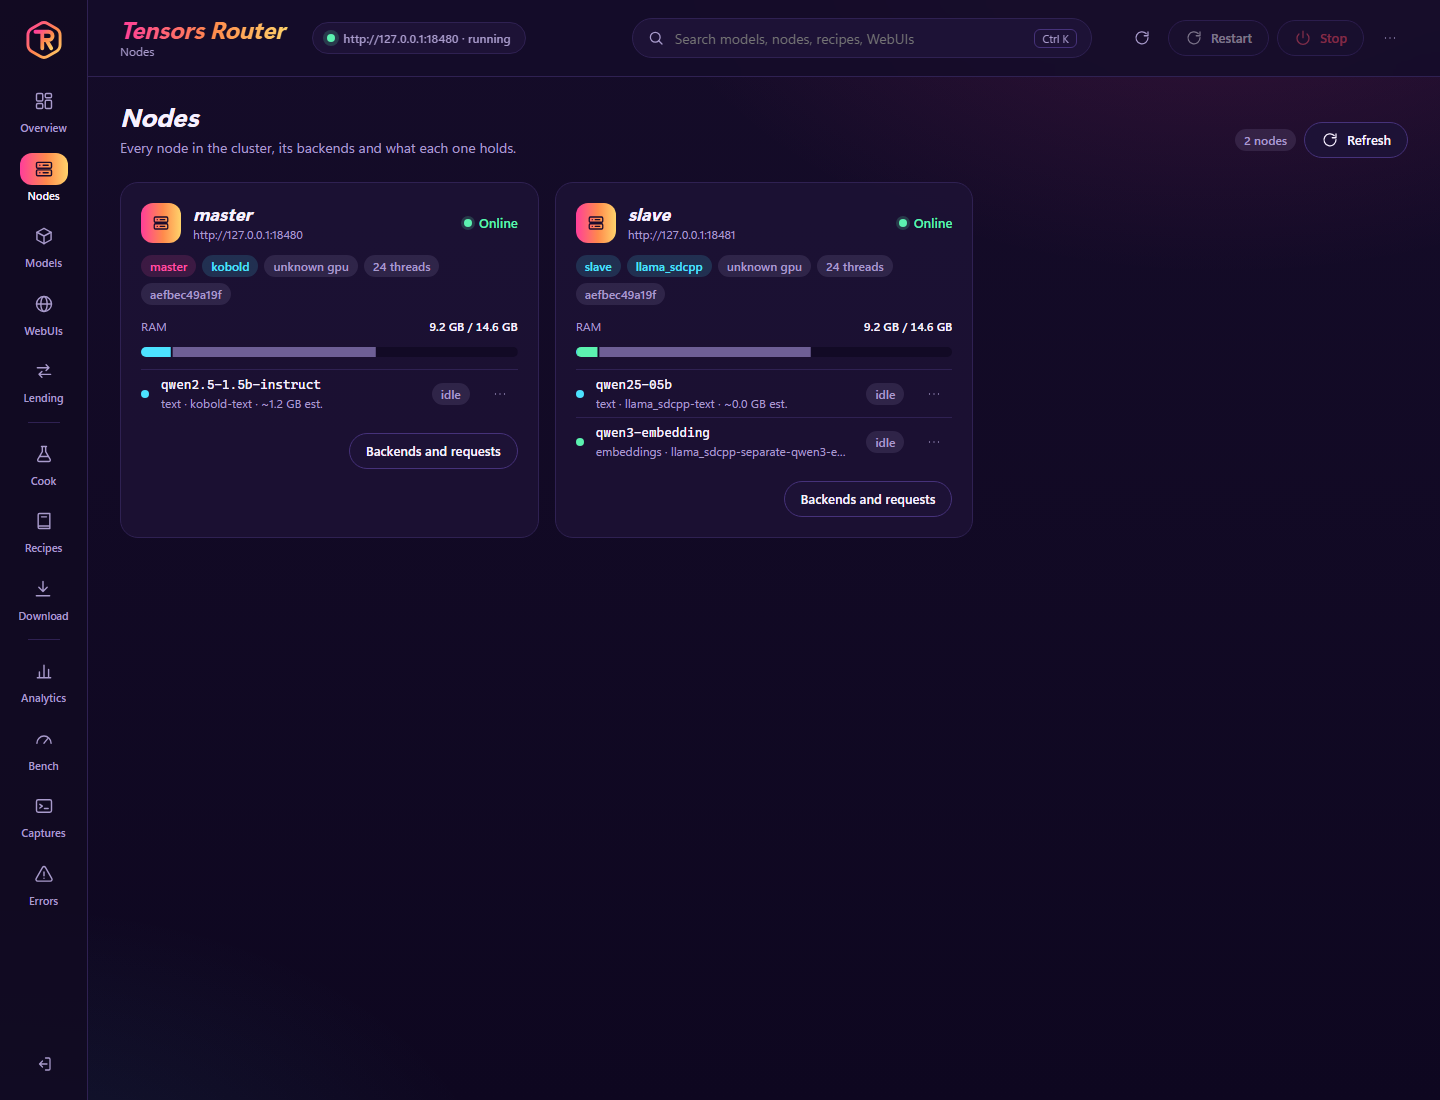
tensors-router es una herramienta de gestión de inferencia local que permite presentar múltiples nodos o máquinas como un único proveedor de servicios de IA. El router gestiona automáticamente el ciclo de vida de los modelos: carga, conmutación, drenaje y descarga según la demanda, eliminando la necesidad de administrar procesos backend manualmente.
Soporta tres topologías de ejecución: standalone headless (solo router sin interfaz), standalone con WebUI (gestión visual del router) y routing-only master (sin modelos locales, delegando toda la inferencia en nodos de cluster). Cada nodo detecta automáticamente su hardware GPU (CUDA, ROCm, Vulkan, Metal o CPU) e instala builds backend correspondientes.
El sistema implementa capacidades avanzadas como VRAM awareness, políticas de evicción de modelos, recuperación automática tras fallos, carga única de modelos compartida entre múltiples configuraciones y conmutación concurrente sin interrupciones. Los backends soportados incluyen KoboldCpp (procesos unificados), llama.cpp con stable-diffusion.cpp (procesos separados) y vLLM (con runtime explícito para Linux y Apple Silicon).
- Centralizar múltiples instancias de modelos de IA en una única URL API para clientes externos
- Gestionar clusters heterogéneos con diferentes tipos de GPU y sistemas operativos
- Optimizar uso de VRAM mediante políticas de evicción automática de modelos no utilizados
- Proveer servicios de inferencia local sin exponer directamente a internet público
- Conmutar entre modelos de texto, imagen, embeddings, voz o música según demanda
- Gestión automática de carga/descarga de modelos con políticas de evicción basadas en VRAM
- Recuperación automática tras fallos de nodos o backends sin intervención manual
- Soporte para hardware heterogéneo (CUDA, ROCm, Vulkan, Metal, CPU) en un mismo cluster
- Carga única de modelos compartida entre múltiples configuraciones con jinja_kwargs
- Seguridad mediante autenticación por IP range y claves separadas para inferencia/admin/cluster
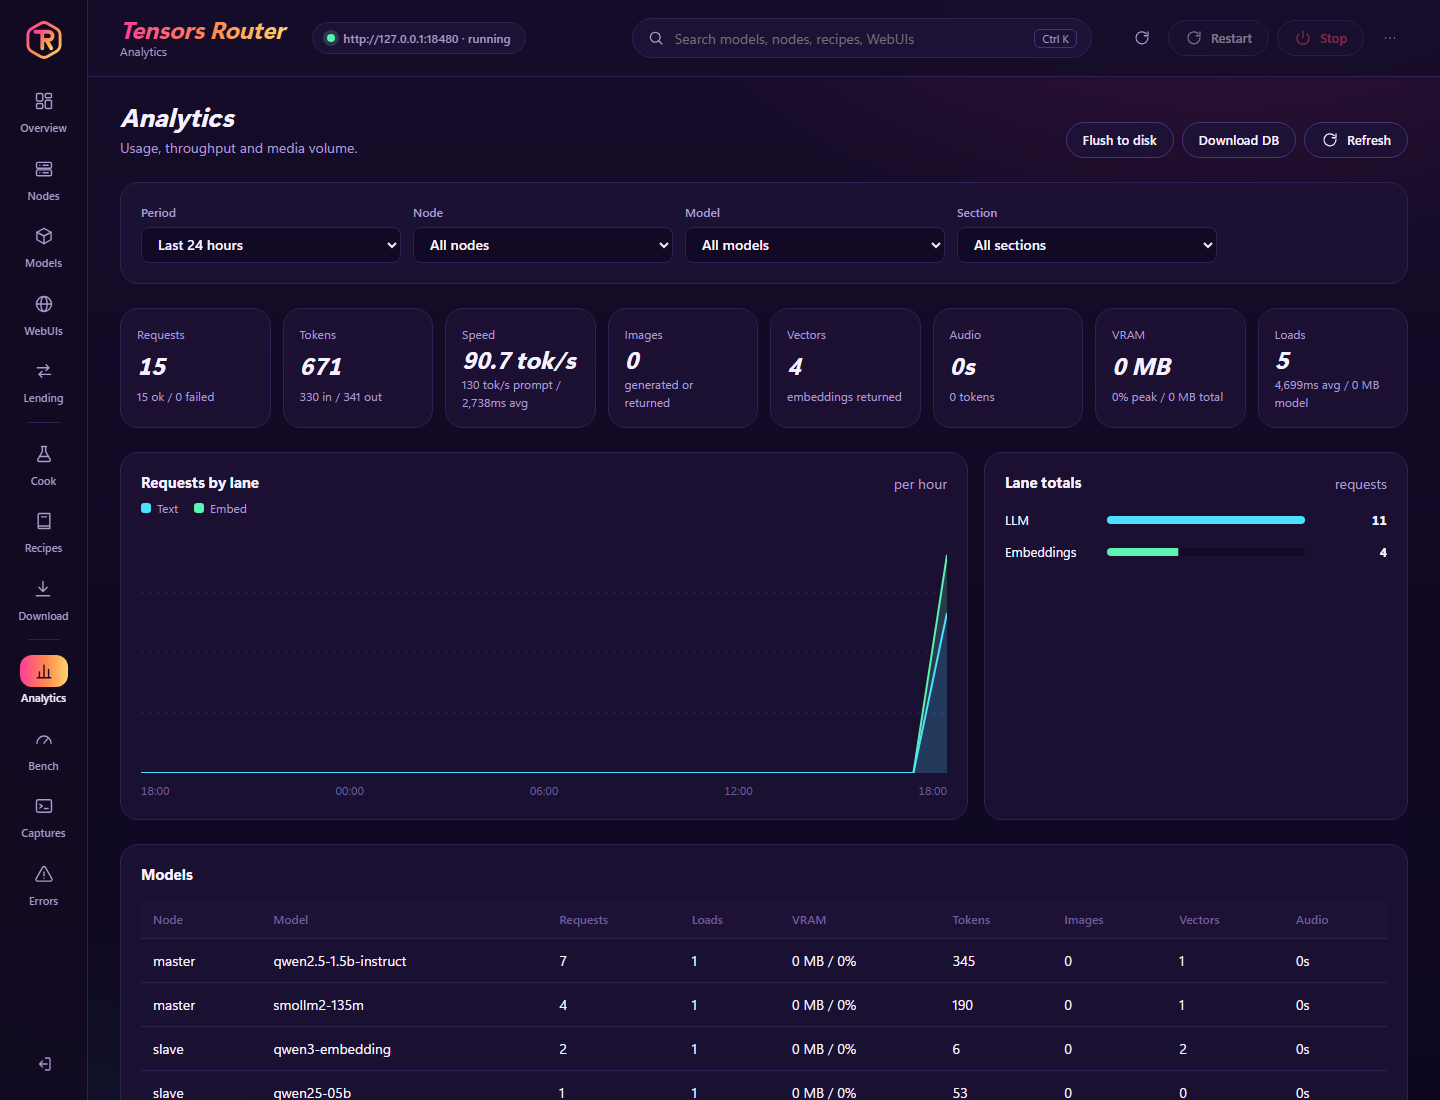
- Métricas y observabilidad opcionales con persistencia en SQLite
- No incluye Docker ni Dockerfile según análisis técnico del repositorio
- vLLM solo disponible en Linux y Apple Silicon con instalación explícita
- Intendido para intranet; no exponer directamente a internet público
- Requiere configuración manual de backends (no one-click deployment)
- Dependencia de proyectos externos: KoboldCpp, llama.cpp, stable-diffusion.cpp
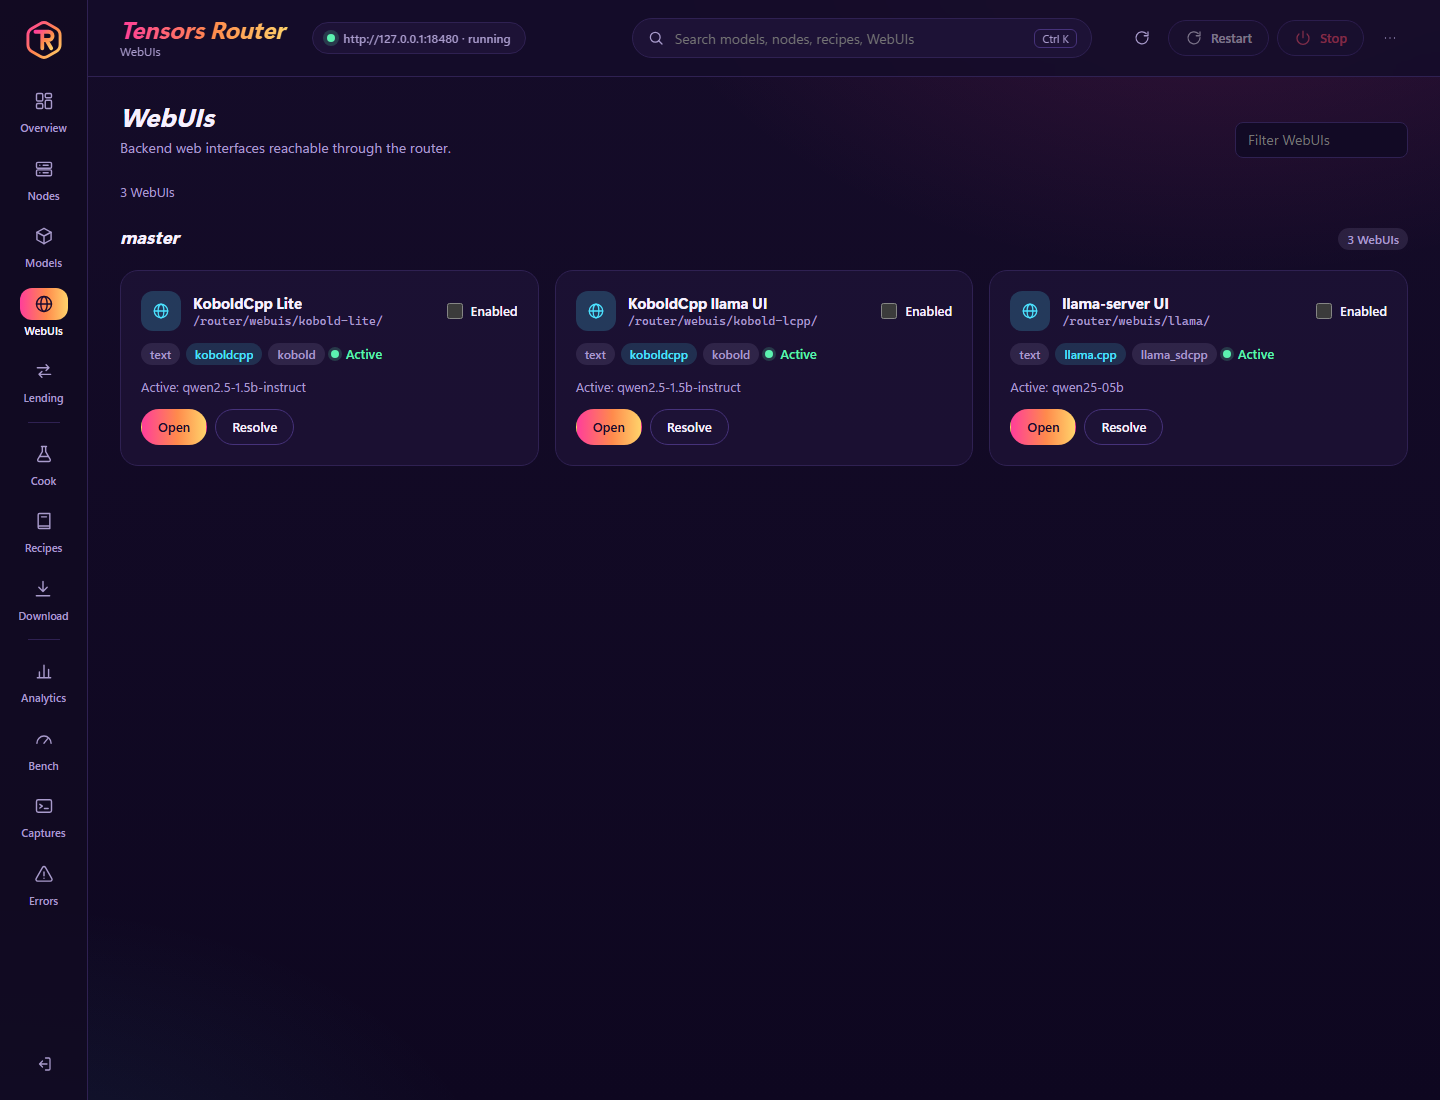
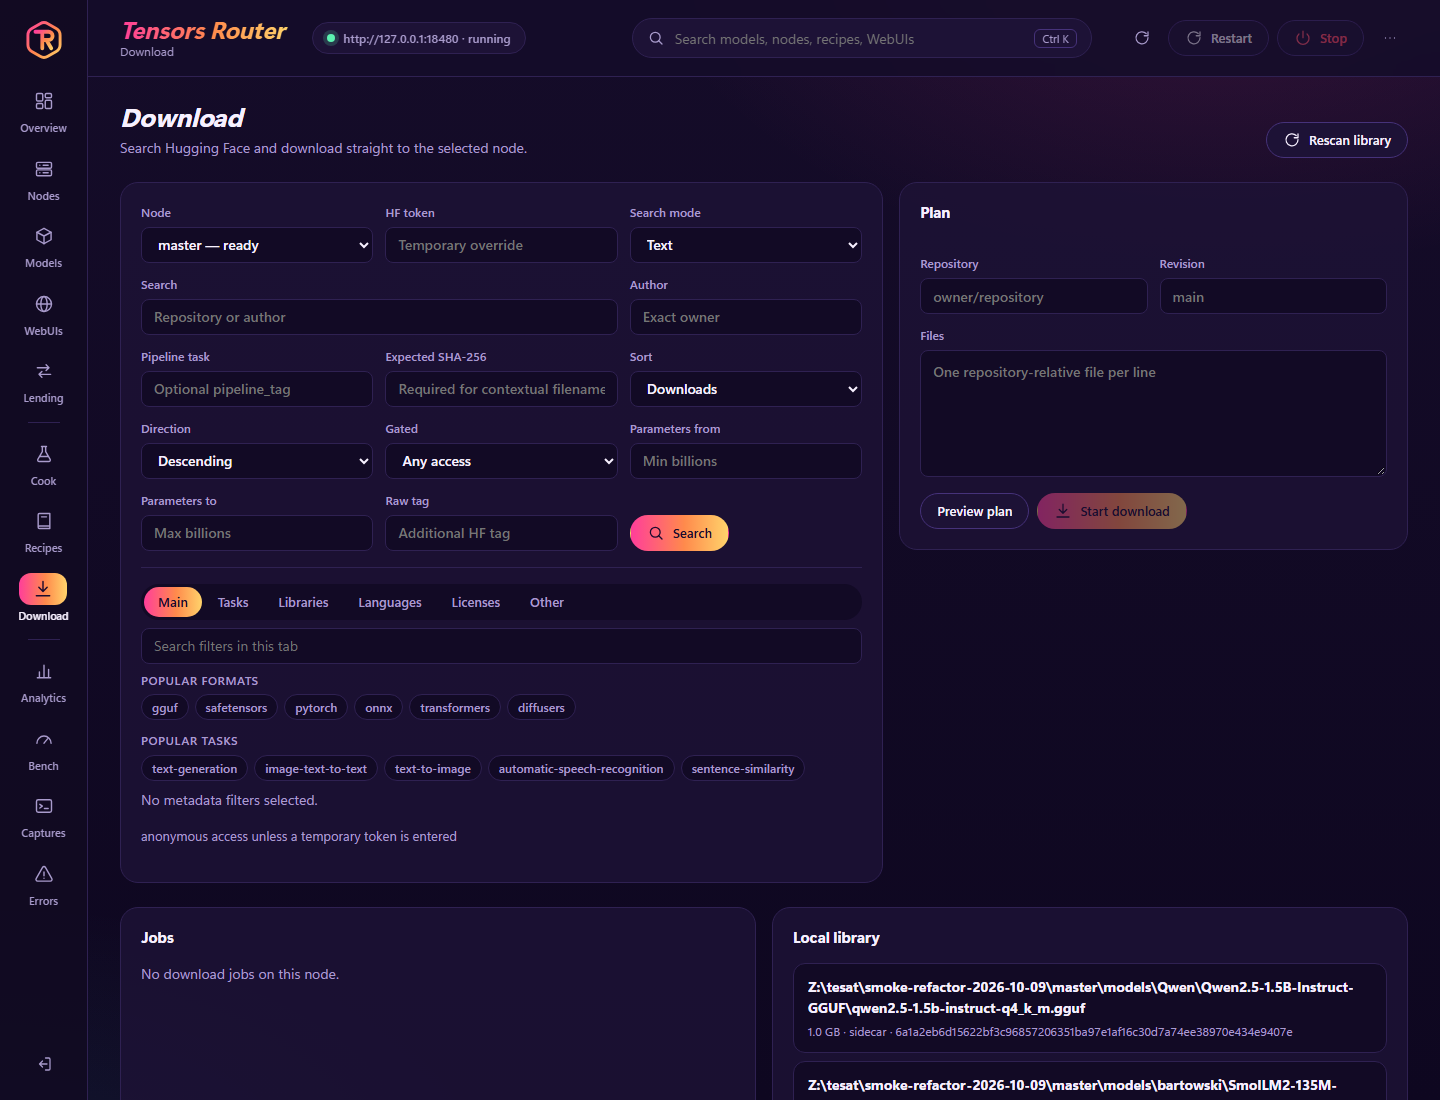
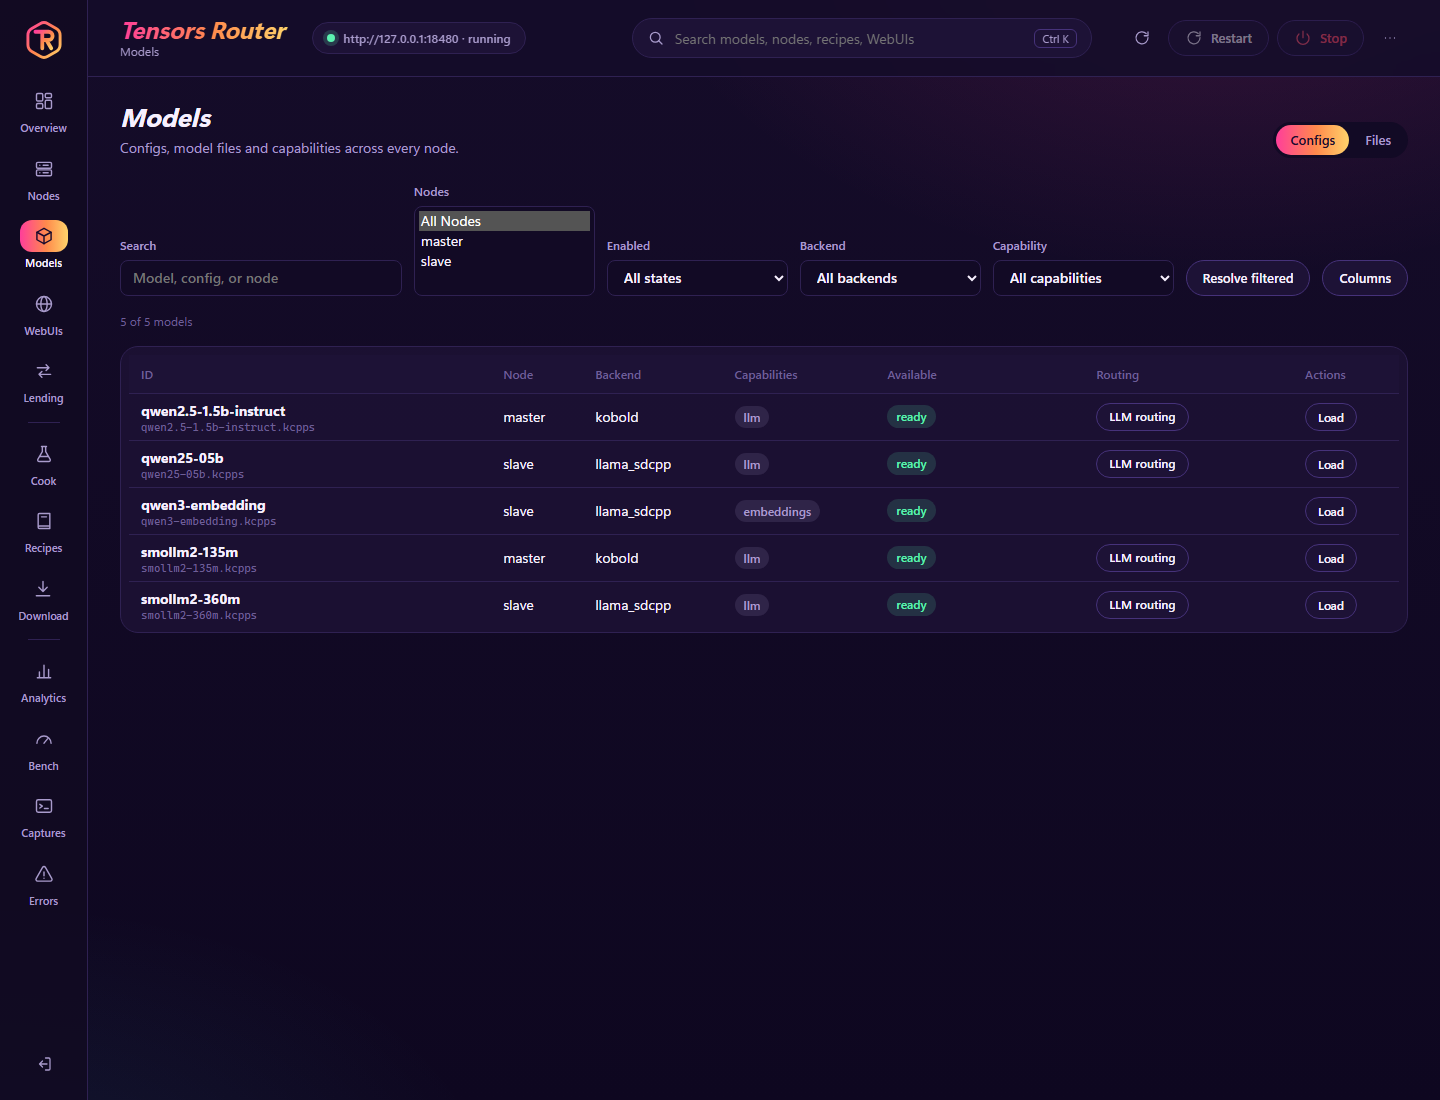
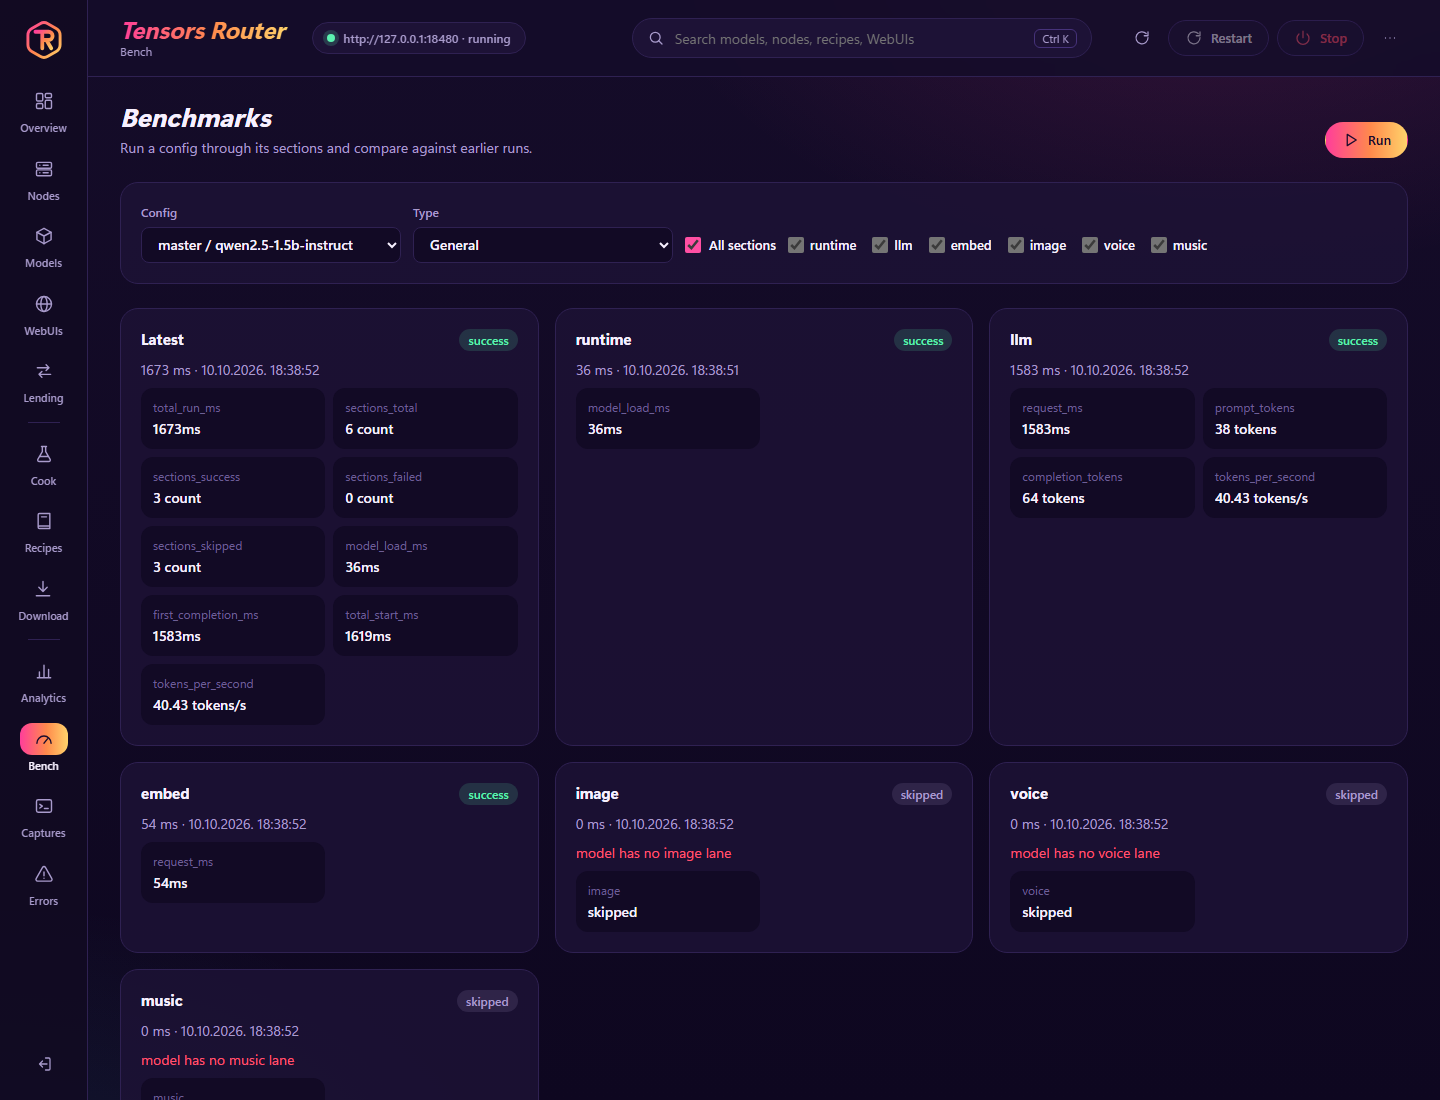
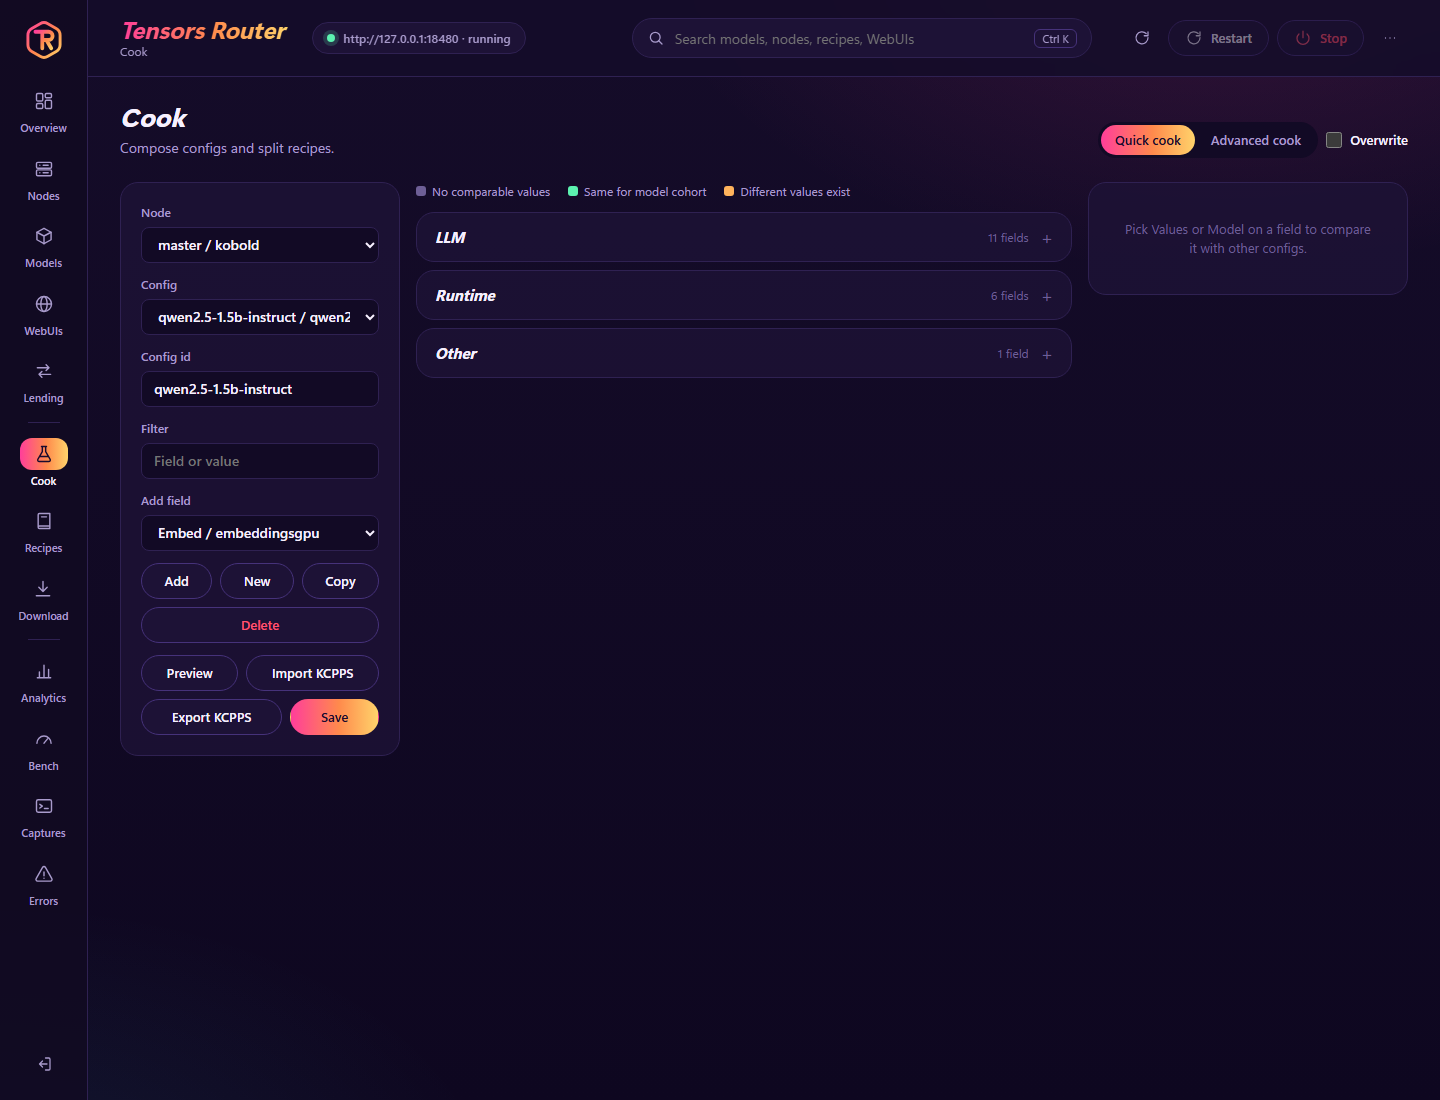
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.

Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Desplegar en entorno intranet. Bind al localhost o interfaz privada. Restringir server.allowed_cidrs y usar reverse proxy o VPN para acceso remoto. Configurar autenticación por IP range y claves separadas para inferencia, admin y cluster traffic. Verificar compatibilidad de backend con hardware GPU local (CUDA/ROCm/Vulkan/Metal/CPU). Para vLLM, instalar runtime explícitamente en Linux o Apple Silicon.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.