
syslog-flow
syslog-flow es un servidor syslog ligero basado en rsyslog que ingiere logs desde routers, switches, firewalls y servidores Linux mediante UDP/TCP 514, almacenándolos como texto plano organizado por fecha y dispositivo, con una interfaz web moderna para visualización en tiempo real, búsqueda global,
Ficha actualizada 29 sept 2026, 1:25 · upstream 29 sept 2026, 0:55 · release v1.2.0
Qué es syslog-flow
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
syslog-flow es un servidor syslog autocontenido diseñado para simplificar la centralización de logs sin complejidad innecesaria. Utiliza rsyslog como motor de ingestión confiable, parseando mensajes desde múltiples fuentes y almacenándolos como archivos de texto plano en una estructura lógica por fecha (logs/año/mes/día/). Esto permite mover los logs libremente sin romper esquemas propietarios, a diferencia de soluciones basadas en bases de datos cerradas.
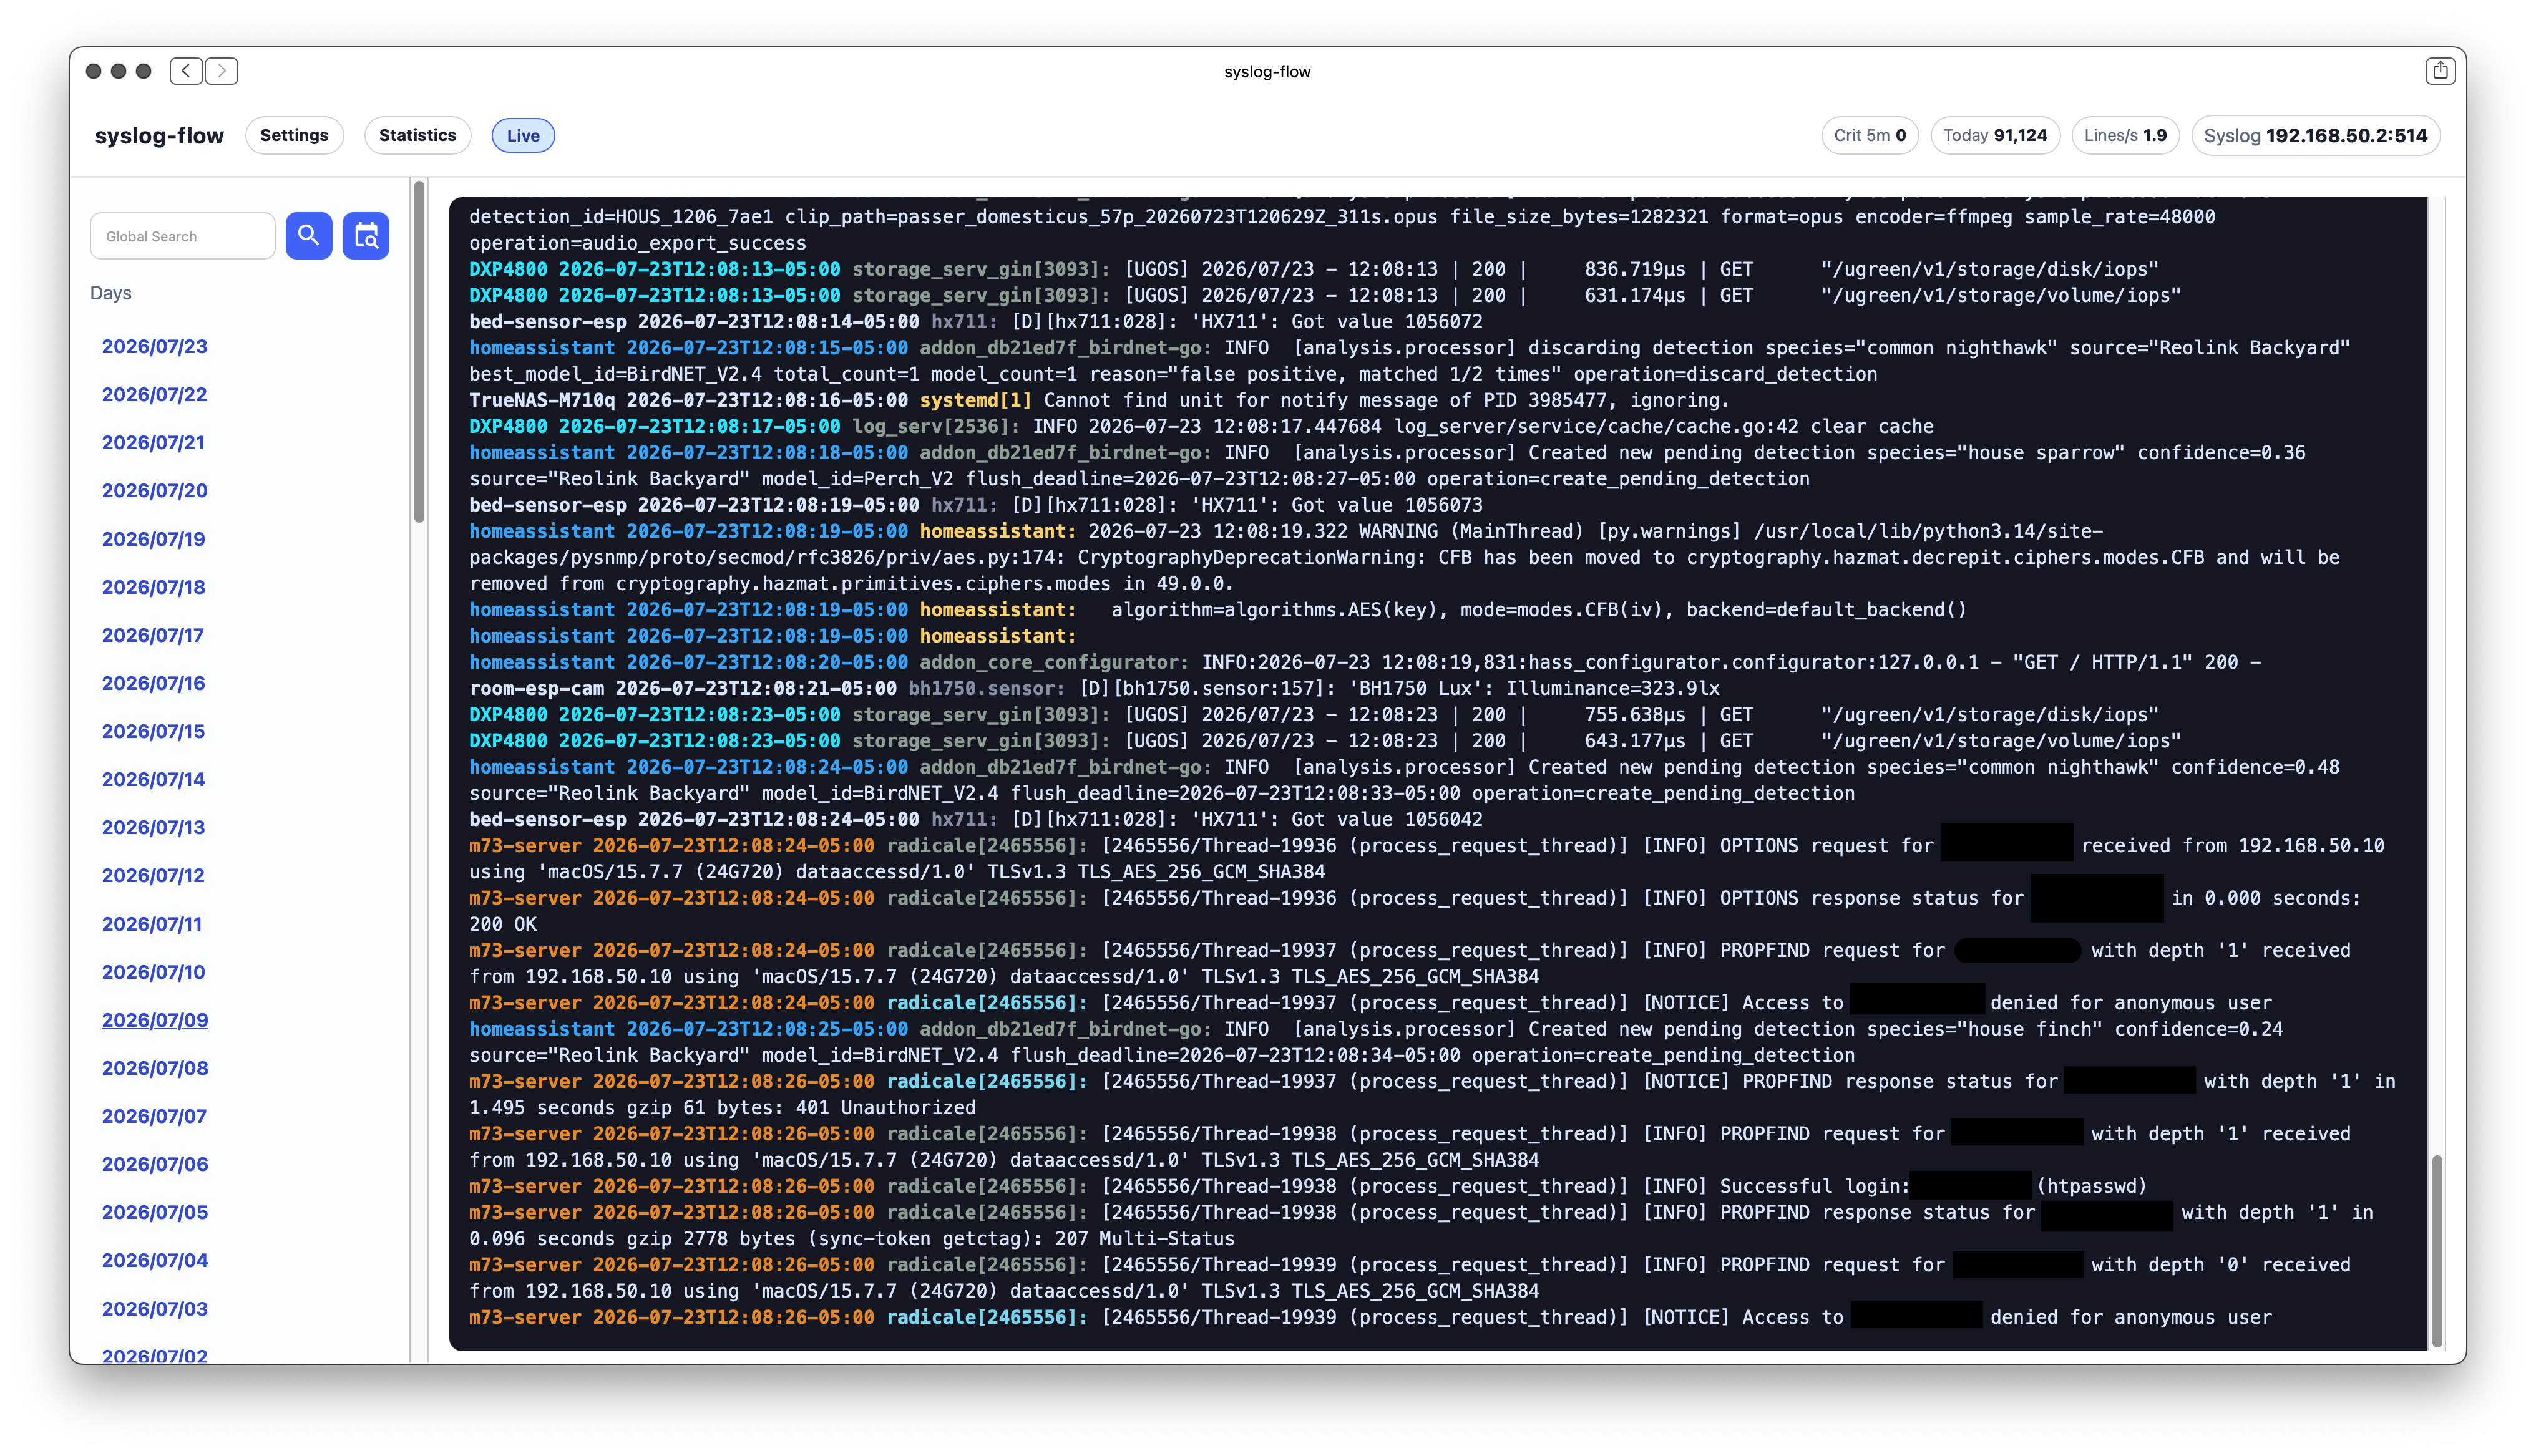
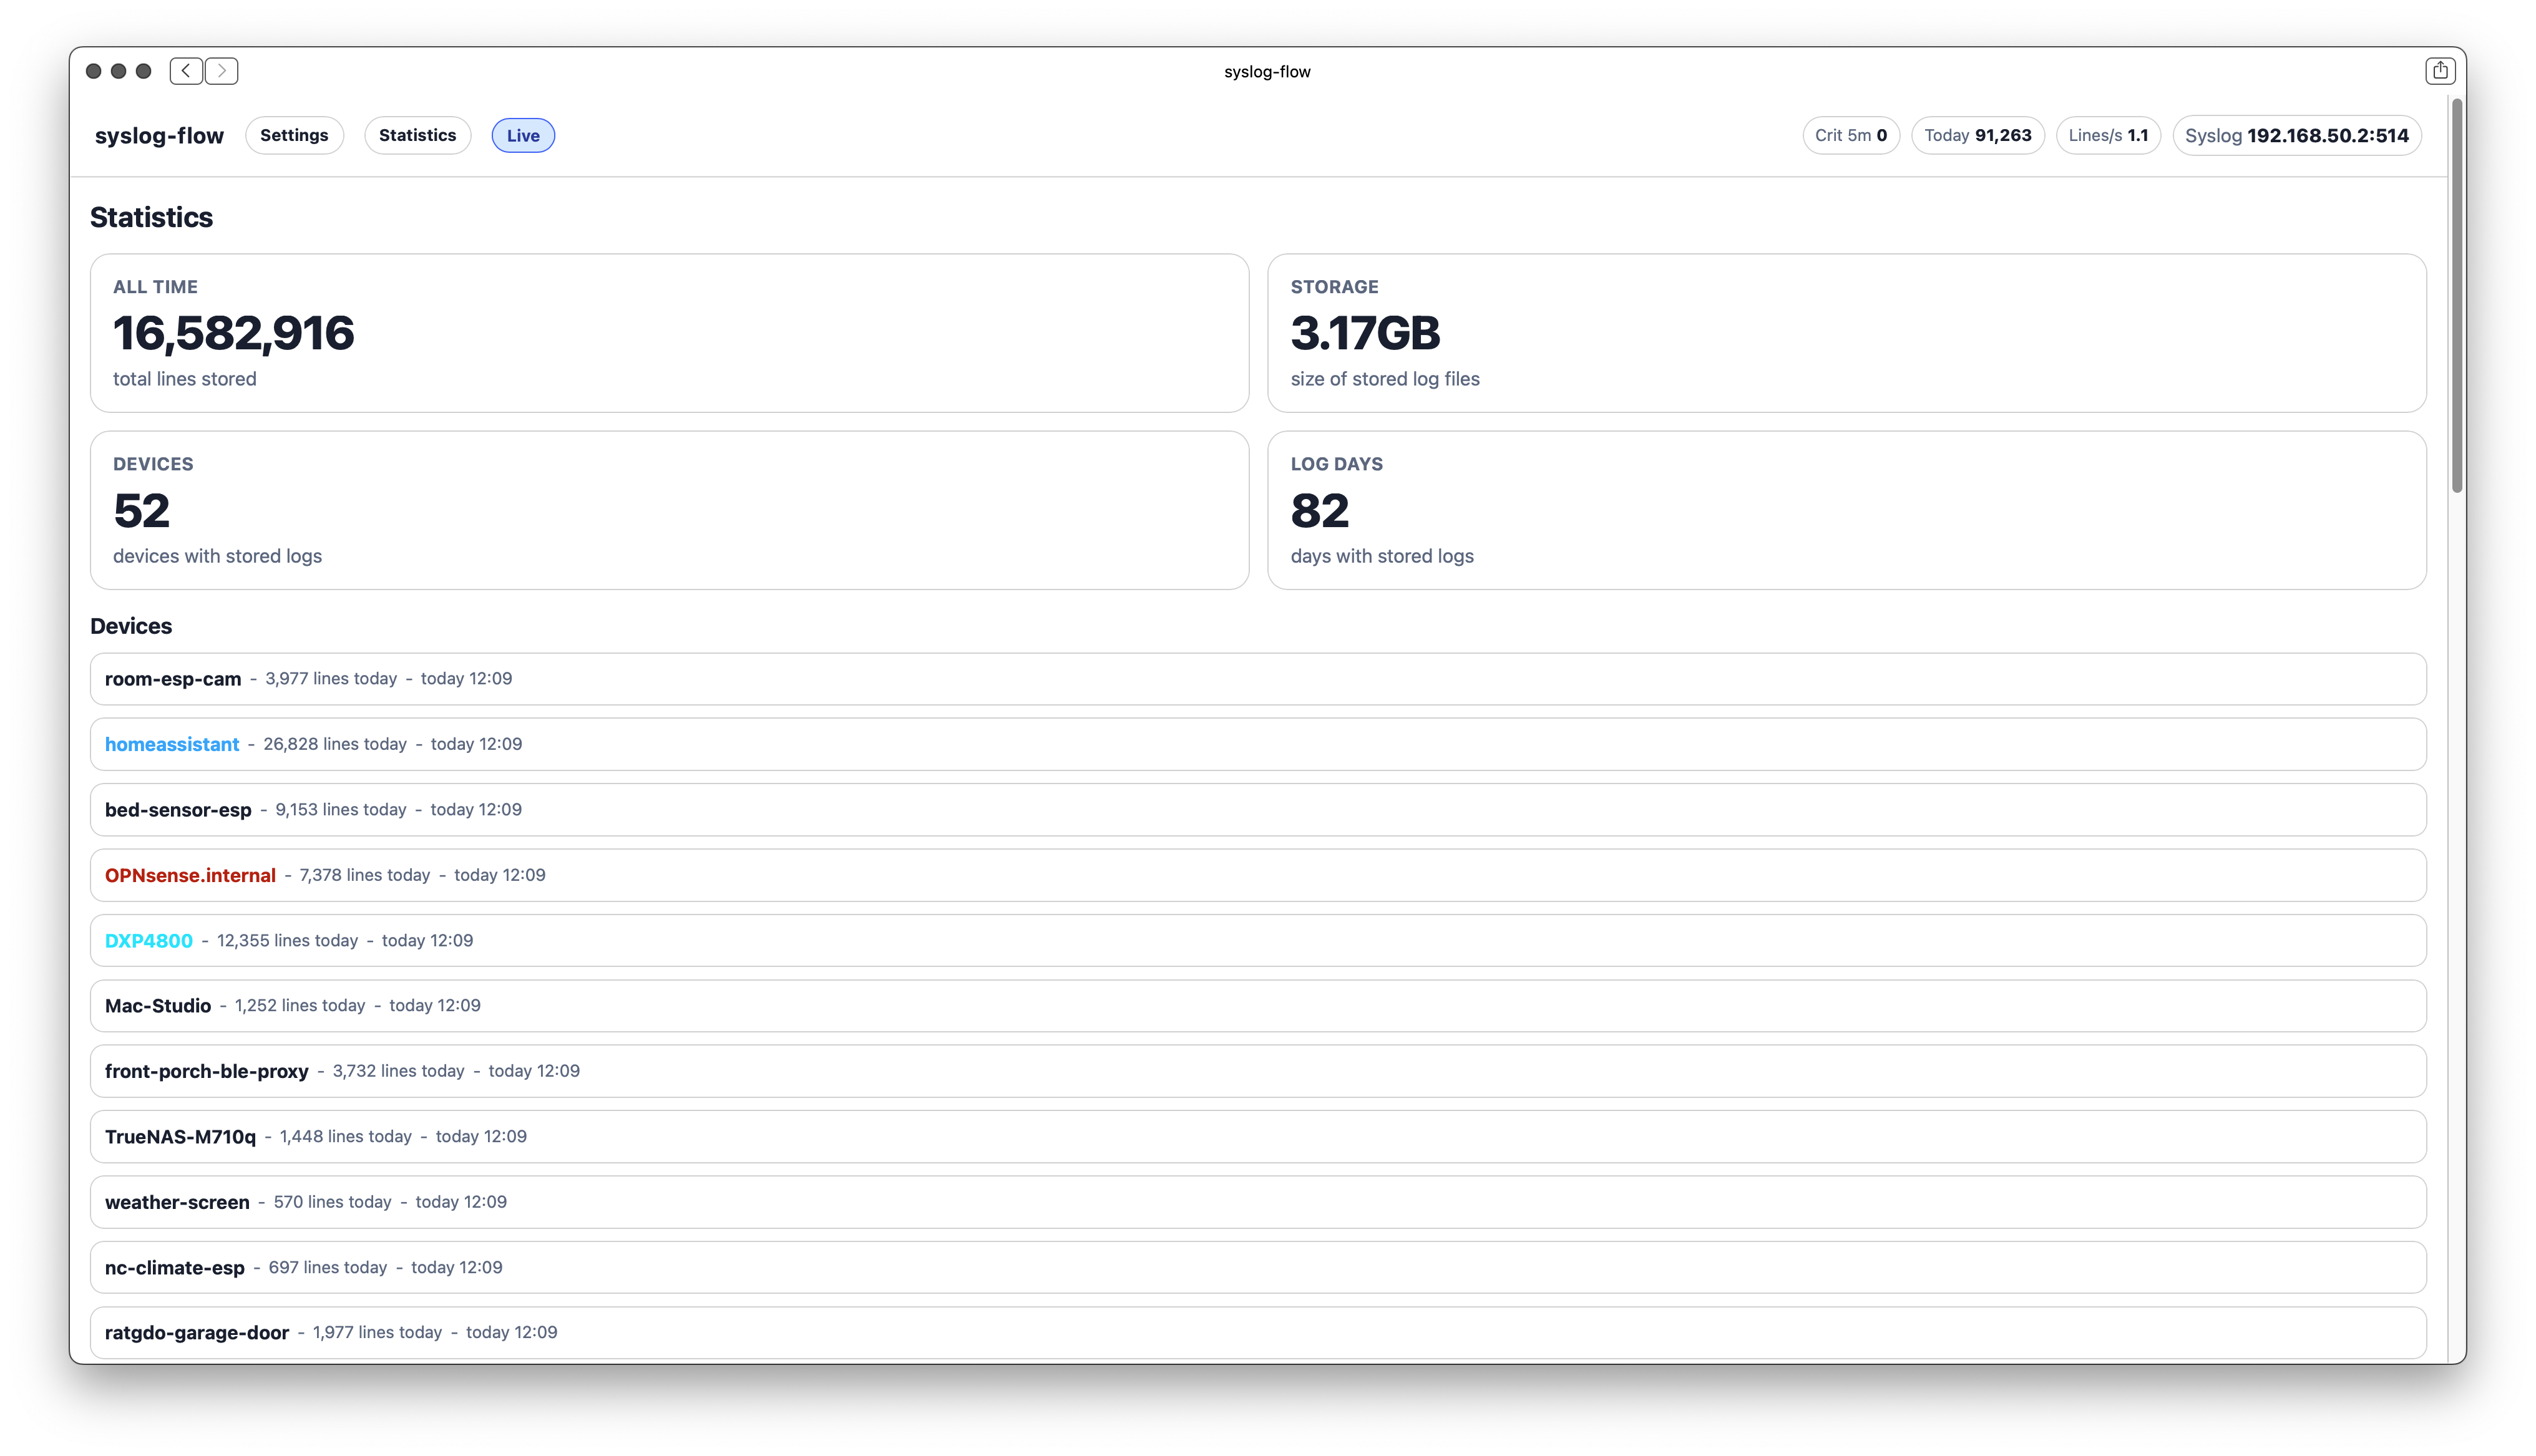
La interfaz web ofrece visualización en tiempo real con actualización automática, vista por dispositivo, búsqueda global y filtros por severidad. Incluye una API REST simple en /api/stats que expone métricas como líneas recibidas hoy/todas, bytes totales, dispositivos activos y alertas críticas de los últimos 5 minutos. La interfaz también soporta personalización mediante archivos JSON para colores de dispositivos, interfaces y niveles de severidad.
El contenedor ejecuta dos procesos: rsyslogd en el puerto 514 para ingestión y syslog-flow en el puerto 2200 para la UI y API. Incluye un sistema de caché JSON por día para arranque rápido y rendimiento óptimo. Soporta configuración básica de Home Assistant mediante REST, permitiendo crear sensores de líneas por segundo, totales y alertas.
- Centralización de logs desde múltiples dispositivos de red (routers, switches, firewalls, NAS) en un solo lugar
- Visualización en tiempo real de eventos críticos para troubleshooting inmediato
- Almacenamiento a largo plazo de logs como texto plano para auditoría forense
- Integración con Home Assistant mediante API REST para métricas de actividad de sistema
- Reemplazo ligero de soluciones complejas (ELK, VictoriaLogs) en entornos domésticos o pequeños
- Monitoreo básico de severidad y volumen de logs sin dependencias pesadas
- Almacenamiento como texto plano: los logs son archivos legibles y movibles sin esquemas propietarios
- Peso mínimo: solo una dependencia Go, sin bases de datos ni componentes externos complejos
- Interfaz web responsive con soporte móvil básico (botones Jump to Top/Bottom)
- API REST simple en /api/stats para integraciones externas como Home Assistant
- Caché JSON por día para arranque rápido y rendimiento óptimo
- Configuración personalizable mediante archivos JSON para colores de UI y dispositivos
- No incluye retención automática ni pruning de logs antiguos; requiere gestión manual del volumen de disco
- Sin soporte multiusuario ni control de acceso; un solo punto de vista sobre los logs
- No es una SIEM: carece de correlación avanzada, alertas automáticas o análisis forense profundo
- La caché JSON debe regenerarse si se reorganizan manualmente los archivos de logs en el disco
- Soporte móvil básico sin funcionalidades avanzadas como sidebar colapsable
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Recomendado para entornos con 4 núcleos CPU y 4GB RAM mínimo. Asegurar al menos 20GB de espacio libre para logs históricos. Configurar retención manual o implementar scripts externos de pruning. Exponer puertos 514/udp y 514/tcp para ingestión, 2200/tcp para UI/API. Usar timezone del servidor (/etc/localtime) para organización por días. Backup de app.json y status-colors.json antes de actualizaciones.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.