
statewave
Runtime de memoria para agentes IA open-source. Proporciona contextos deterministas y con trazabilidad de procedencia en lugar de recuperación en tiempo de consulta. Auto-alojable en PostgreSQL + pgvector, SDKs Python/TypeScript, licencia Apache-2.0.
Ficha actualizada 24 sept 2026, 15:44 · upstream 24 sept 2026, 15:15 · release v1.5.0
Qué es statewave
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
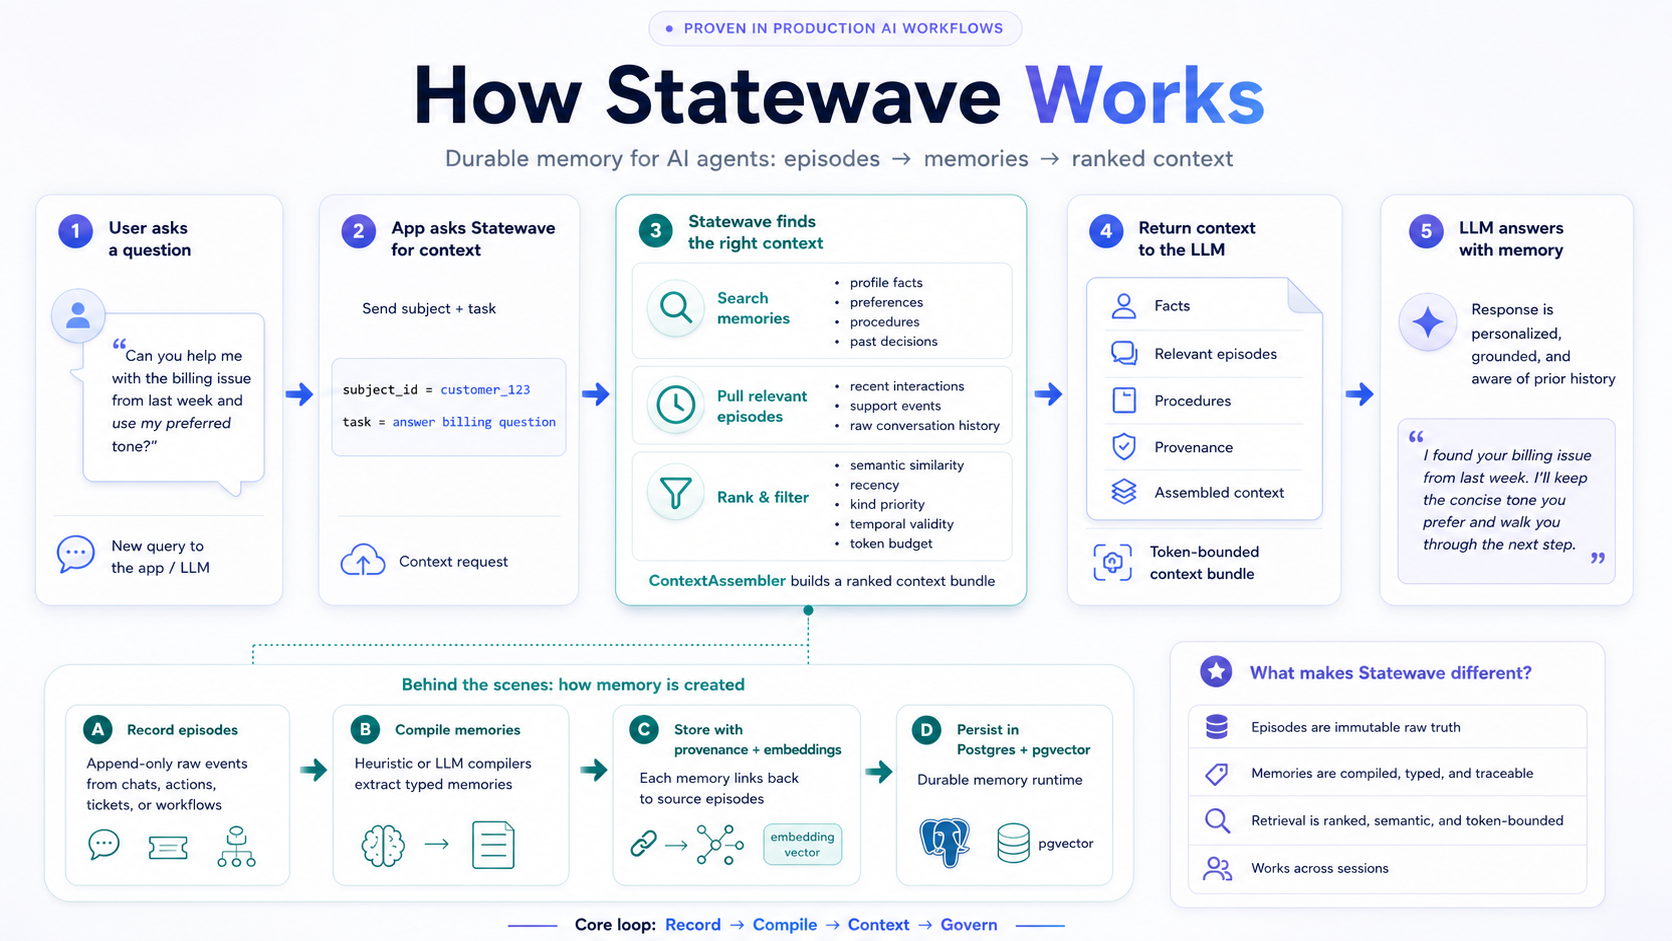
Statewave es un runtime de memoria open-source diseñado para agentes de IA que requieren persistencia de estado entre sesiones. A diferencia de las bases de datos vectoriales tradicionales o el RAG basado en logs, utiliza un enfoque "compile-then-use" para generar contextos deterministas y con trazabilidad de procedencia (provenance). Esto elimina el ruido del muestreo en la recuperación de contexto en tiempo de consulta.
El sistema se auto-aloja sobre PostgreSQL con pgvector, gestionando episodios crudos que se compilan en memorias estructuradas por sujeto (usuario, repositorio, etc.). Ofrece una vida útil clara de los datos: ingestión, compilación, recuperación y gobernanza. No es un framework de chatbot ni un servicio alojado, sino infraestructura neutral a tu aplicación.
Incluye capacidades avanzadas como etiquetas de sensibilidad, políticas declarativas (YAML), soporte multi-inquilino mediante encabezados X-Tenant-ID y compiladores pluggables que pueden usar heurísticas locales o LLMs vía LiteLLM. Los SDKs están disponibles para Python y TypeScript.
- Agentes de soporte con reconocimiento de clientes a través de sesiones
- Agentes de codificación de larga duración que recuerdan decisiones de arquitectura
- Comparación A/B entre agentes stateless y con memoria persistente
- Integraciones con LangChain, CrewAI o AutoGen para gestión de contexto
- Gestión de cumplimiento mediante etiquetas de sensibilidad (PII, financieros)
- Licencia Apache-2.0 y código abierto
- Determinismo garantizado en los bundles de contexto (idempotente)
- Sin dependencia de GPU para el proceso API (CPU-only)
- Trazabilidad completa de procedencia (provenance) a episodios fuente
- Soporte multi-inquilino con aislamiento de datos por inquilino
- Integración directa con LiteLLM para proveedores LLM flexibles
- Requiere PostgreSQL + pgvector (no es agnóstico a DB)
- Modo demo predeterminado usa embeddings de stub sin búsqueda semántica real hasta configurar .env
- Soporte CI verificado solo en Linux; macOS/Windows son para desarrollo local no testeado en CI
- GPU necesaria solo si se auto-aloja un compilador LLM o modelo de embeddings (API es CPU)
- No incluye modelos LLM ni embeddings por defecto, requiere configuración externa
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Despliegue recomendado con docker compose up -d para levantar PostgreSQL y la API en el puerto 8100. Las migraciones se ejecutan automáticamente al iniciar. Para activar compiladores LLM, configure .env junto a docker-compose.yml con variables como STATEWAVE_EMBEDDING_PROVIDER=litellm y la clave de API correspondiente. Verifique la salud con GET /readyz. La imagen Docker soporta linux/amd64 y linux/arm64. No requiere GPU para el proceso principal, aunque se necesita si usa compiladores LLM auto-alojados.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.