
StateCore
StateCore es una plataforma auto-alojada para memoria a largo plazo de sistemas de IA. Implementa un pipeline determinista que valida propuestas de LLMs, garantizando auditabilidad y consistencia en el estado de conocimiento sin depender ciegamente de modelos externos.
Ficha actualizada 23 sept 2026, 22:16 · upstream 23 sept 2026, 22:01 · release v1.6.1
Qué es StateCore
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
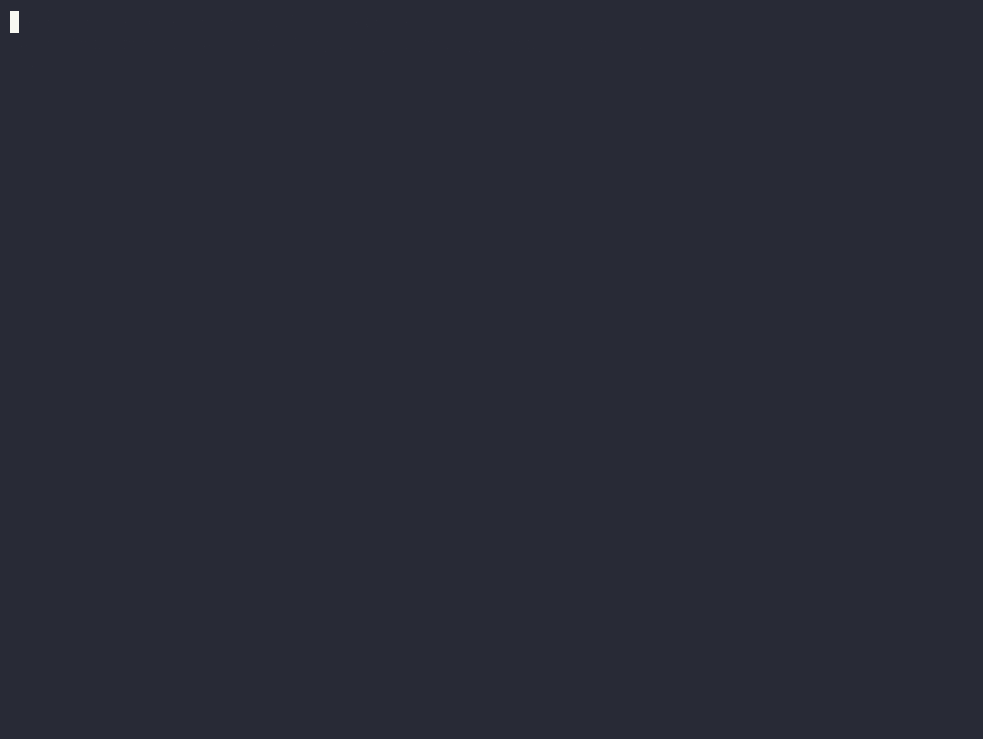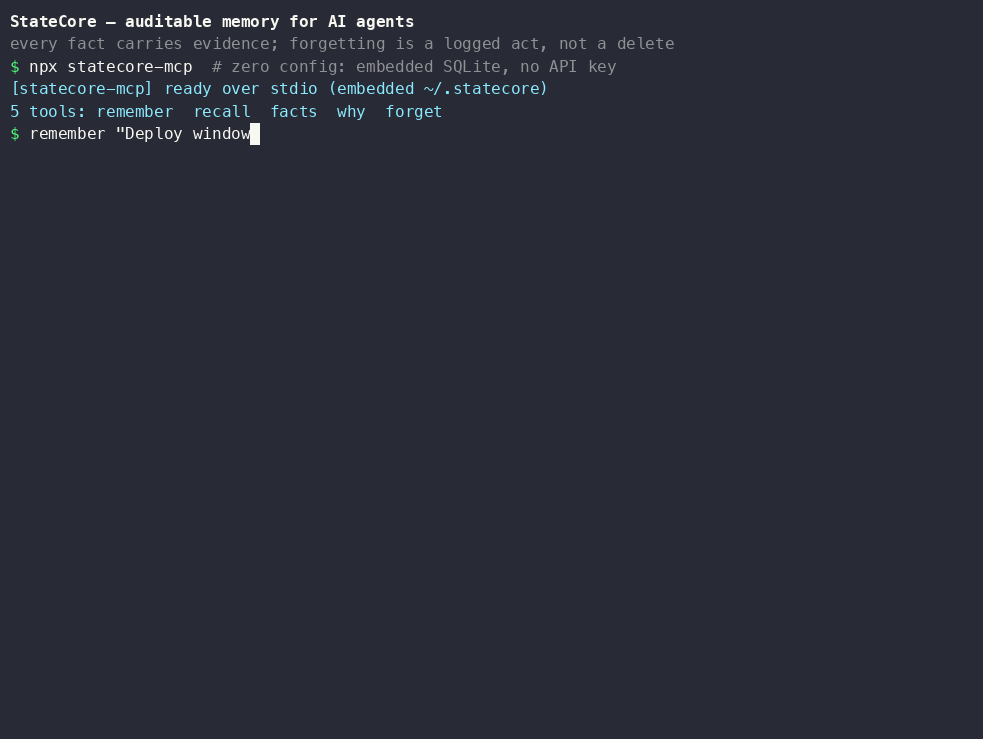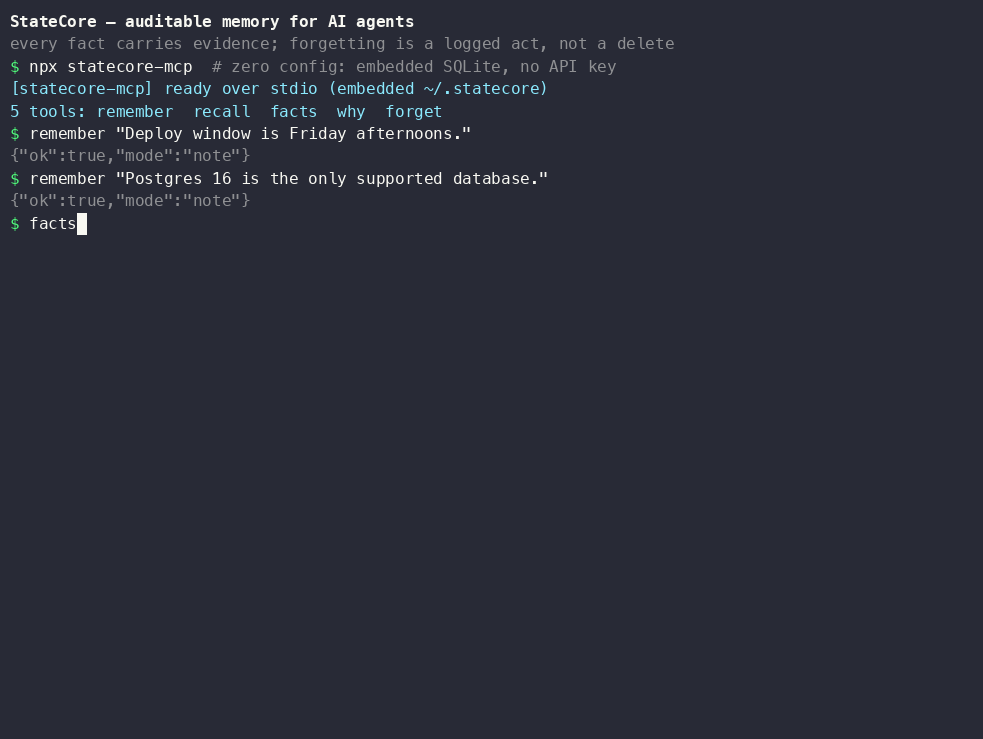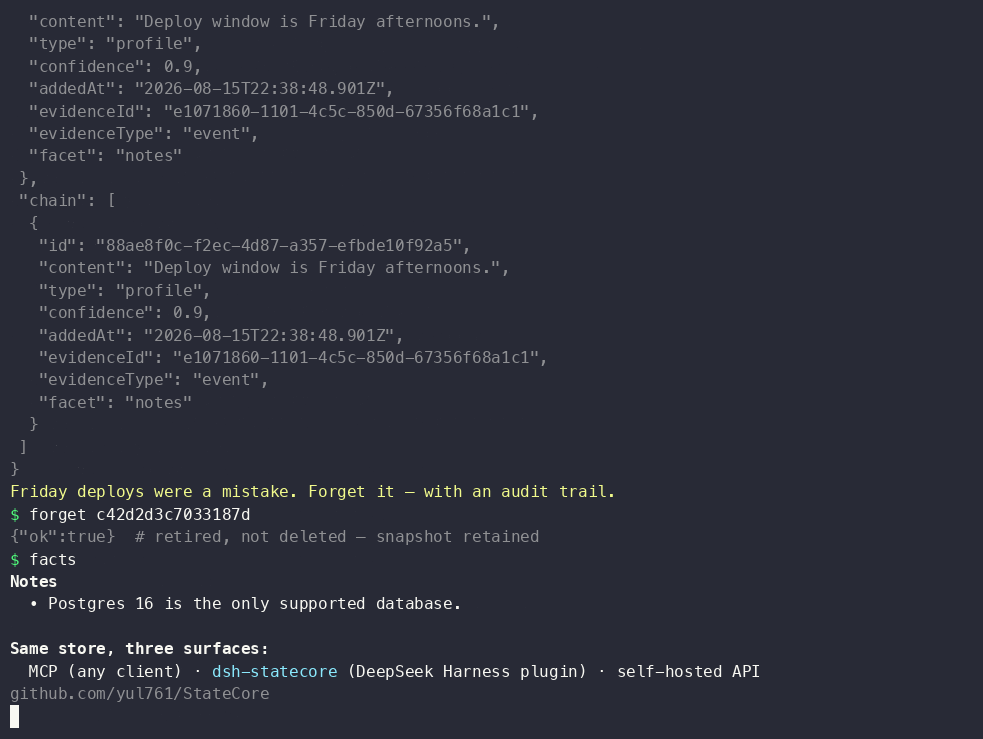
Se centra en la fiabilidad de la memoria a largo plazo para agentes autónomos. A diferencia de herramientas que solo acumulan texto, StateCore introduce una capa de digestión determinista donde un pipeline decide qué hechos estabilizar, descartando información con razones registradas. Esto permite responder "por qué crees esto" auditando la cadena de evidencia y versiones.
Soporta integración vía Model Context Protocol (MCP) para agentes como Claude Code o Cursor sin necesidad de claves API, facilitando despliegues locales o compartidos en equipos. La arquitectura separa memoria rápida, trabajo y estado estable, usando PostgreSQL con pgvector y Redis para el procesamiento asíncrono.
Incluye herramientas de benchmarking y regresión sintética para validar la retención de hechos y estabilidad de decisiones a lo largo del tiempo, asegurando que la memoria no degrade silenciosamente tras actualizaciones o cambios en los modelos subyacentes.
- Auditoría de decisiones de agentes de IA
- Gestión de contexto compartido para equipos de desarrollo
- Persistencia de conocimiento con trazabilidad completa
- Integración ligera vía MCP sin infraestructura compleja
- Validación de retención de información en sistemas autónomos
- Pipeline determinista que valida propuestas de LLM antes de estabilizar datos
- Soporte nativo para Model Context Protocol (MCP) con despliegue keyless
- Retención de evidencia y cadenas de supersesión de hechos sin borrado
- Benchmarks incluidos para medir retención y estabilidad a largo plazo
- Arquitectura modular con separación clara entre ingestión, digestión y estado estable
- Requiere infraestructura externa (PostgreSQL y Redis) para despliegue completo
- Funciones avanzadas de digestión dependen de claves API de modelos LLM externos
- Configuración inicial manual necesaria para migraciones y variables de entorno
- Algunos endpoints internos no están incluidos en el contrato público /v1
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Despliega con docker compose -f docker-compose.local.yml para iniciar Postgres y Redis. Ejecuta pnpm db:generate, migrate y seed antes de arrancar la API o worker. Asegura que el modelo LLM seleccionado soporte reasoning_effort si se usa en endpoints de runtime, ya que modelos como gpt-4o* pueden fallar sin parámetros específicos configurados en las variables de entorno.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.