
spool-tracker
Spool Tracker es una aplicación autoalojada para gestionar el historial de películas, series y anime. Funciona como alternativa a servicios centralizados como Trakt o Simkl, permitiendo almacenar datos en tu propio servidor con Django, PostgreSQL y Redis.
Ficha actualizada 24 sept 2026, 18:40 · upstream 24 sept 2026, 18:35 · release sin release detectada
Qué es spool-tracker
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Spool Tracker es una herramienta de seguimiento de medios diseñada para funcionar localmente, garantizando la privacidad y evitando límites de cuentas o publicidad. La aplicación utiliza un stack tecnológico robusto basado en Django 5.2 LTS, PostgreSQL y Redis con Celery para tareas asíncronas. Se despliega mediante Docker Compose como una pila de cinco contenedores lista para producción, optimizada para entornos con recursos moderados (mínimo 2 núcleos CPU y 2 GB de RAM).
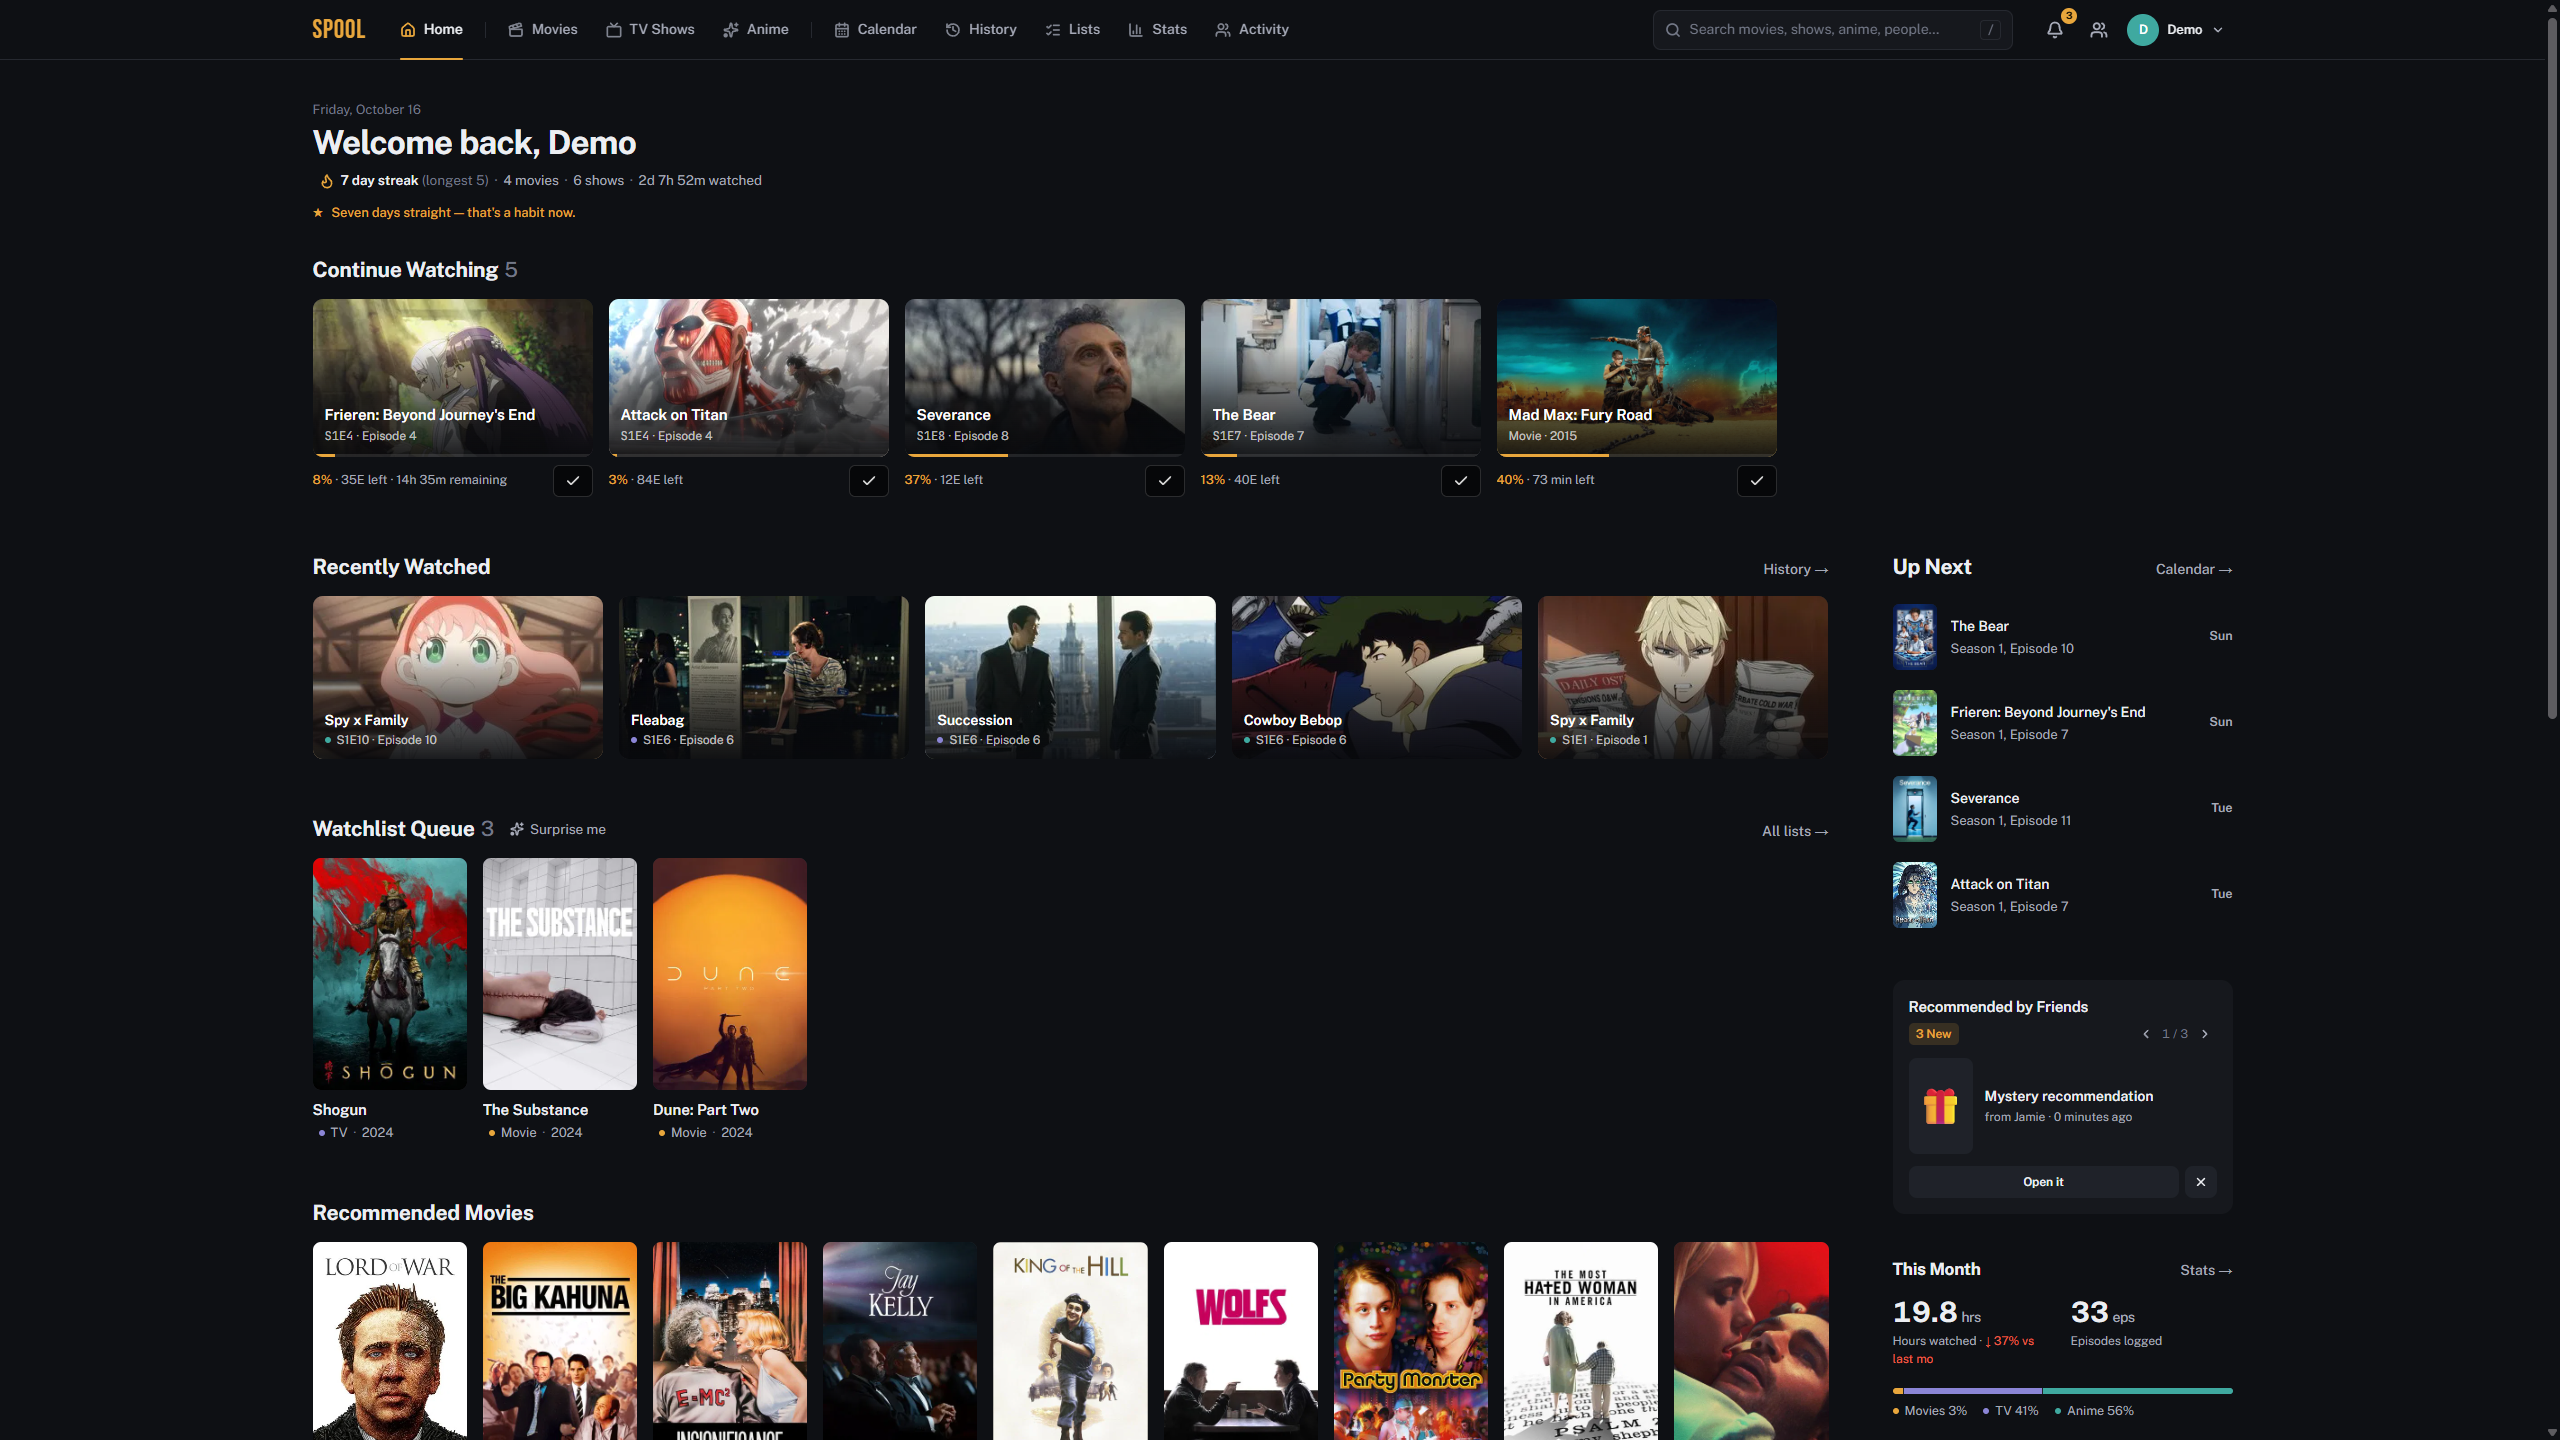
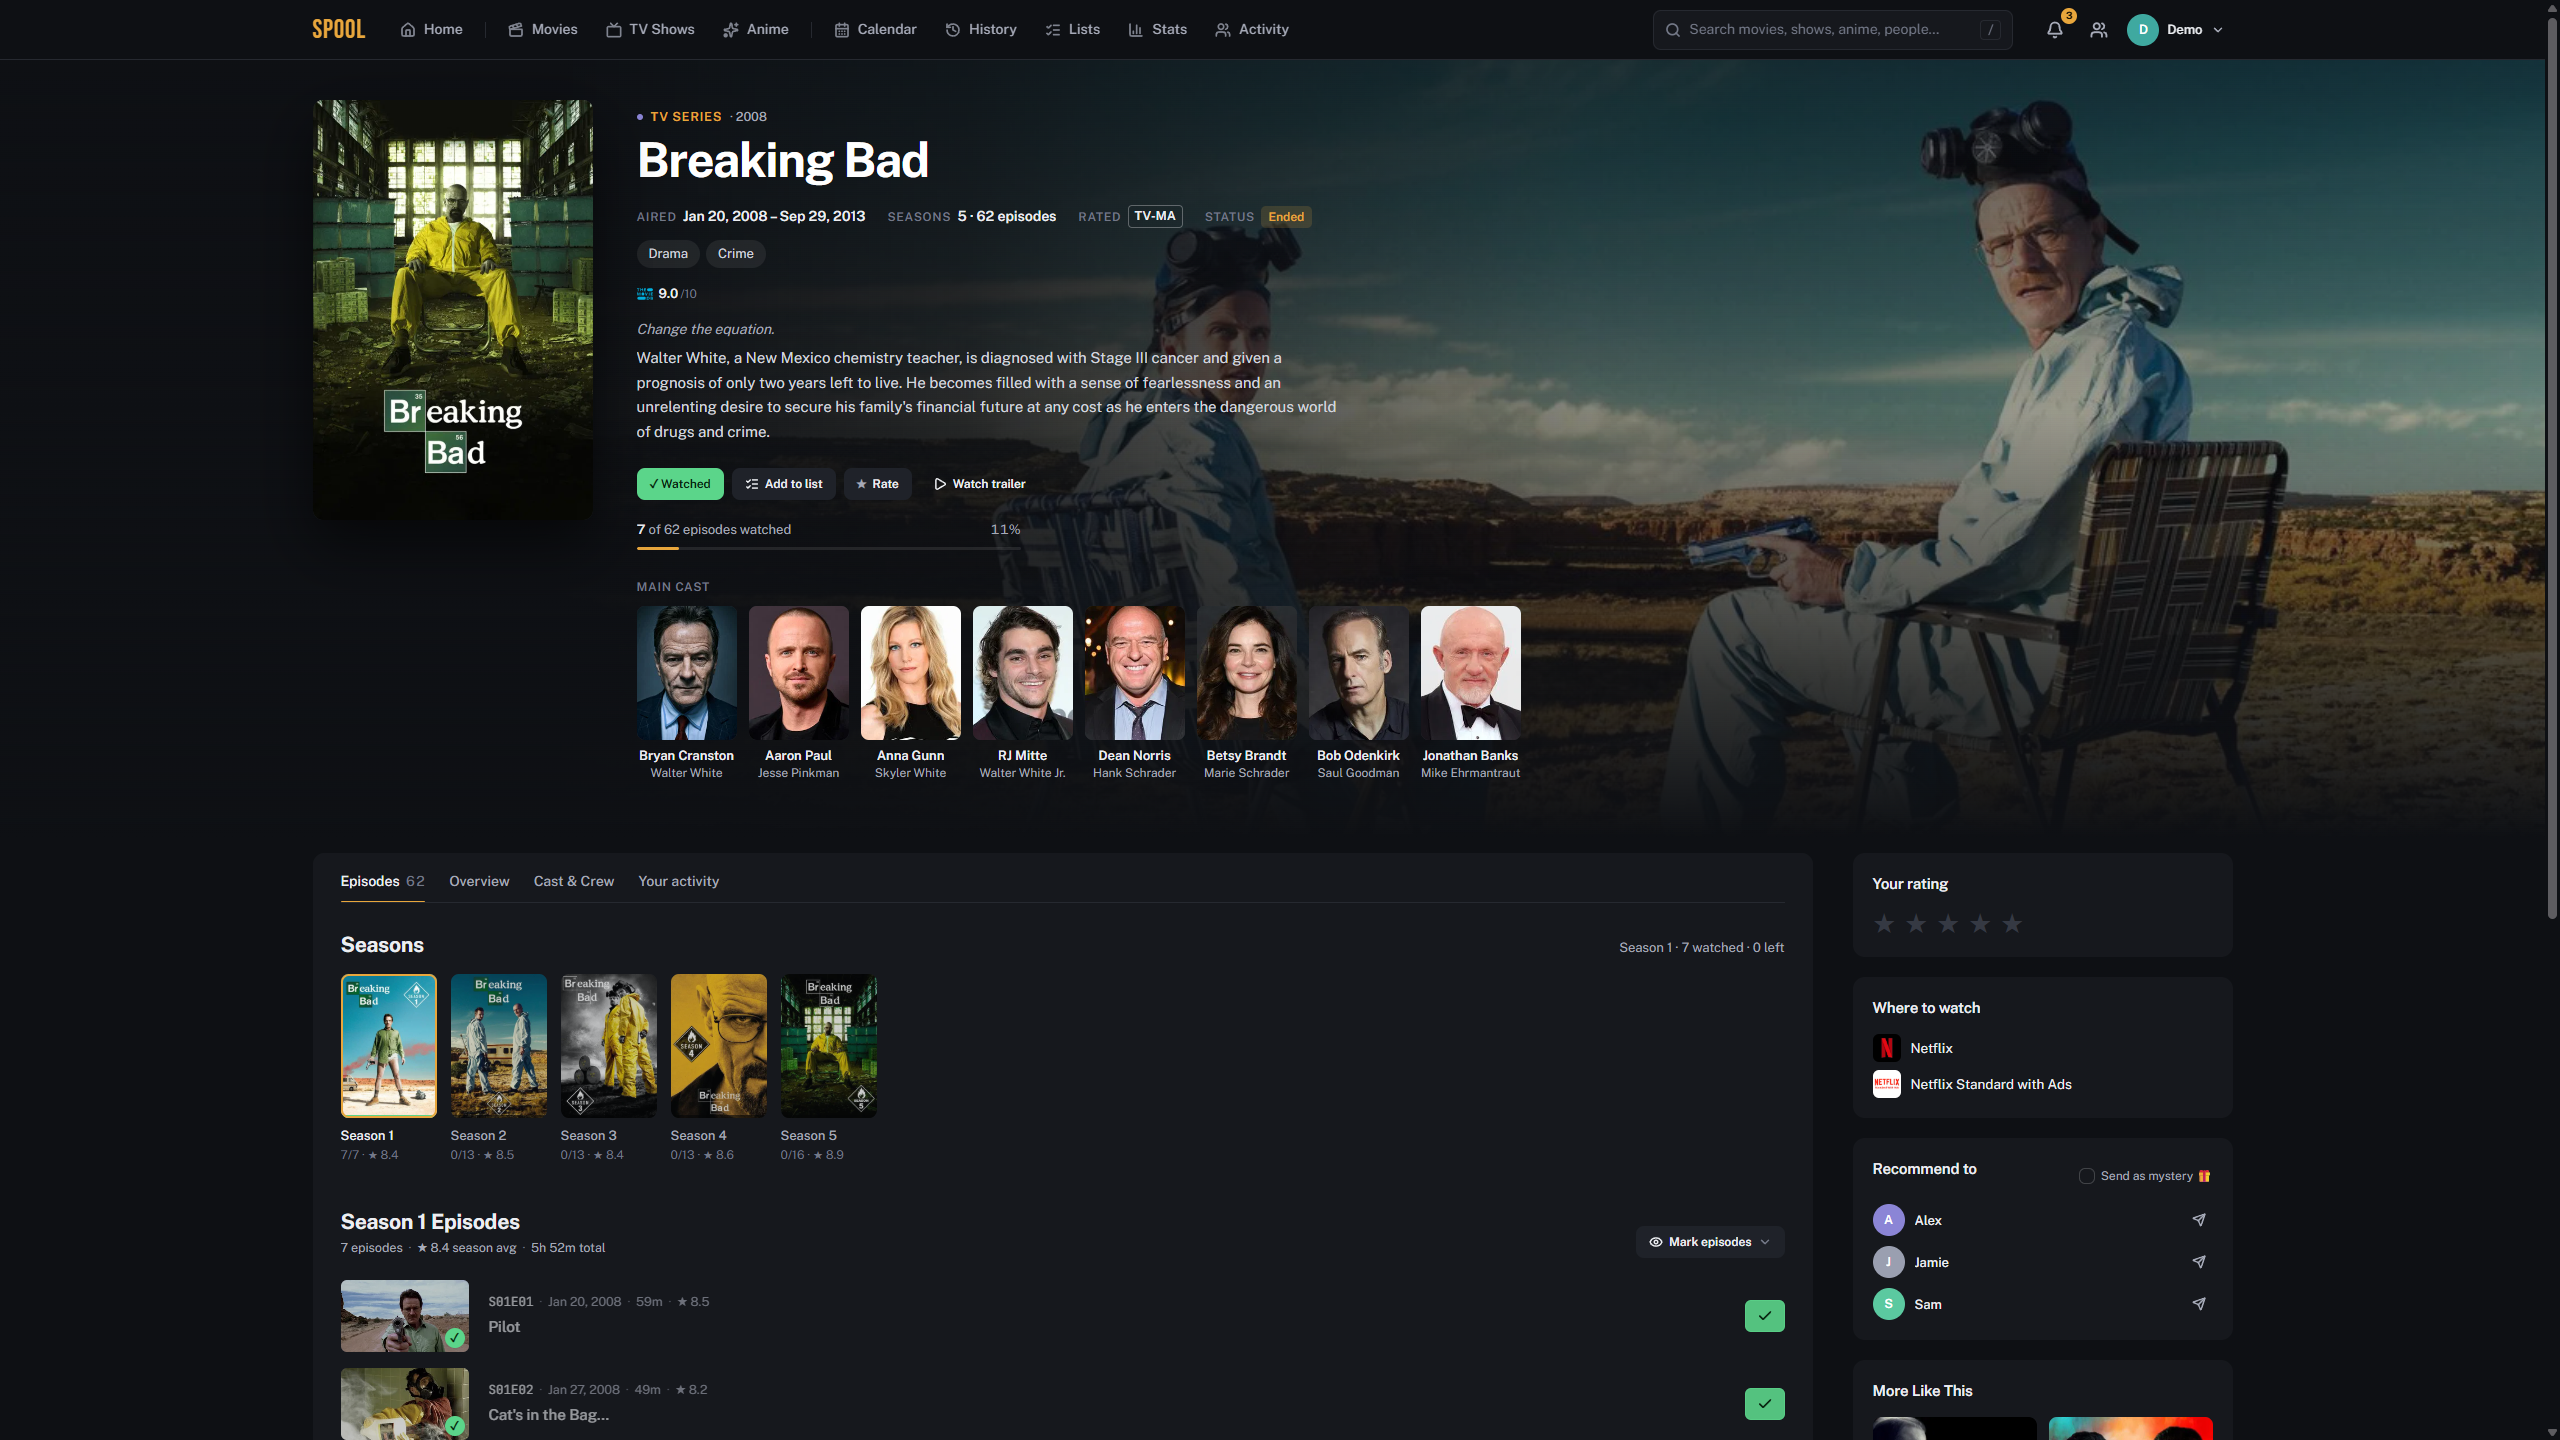
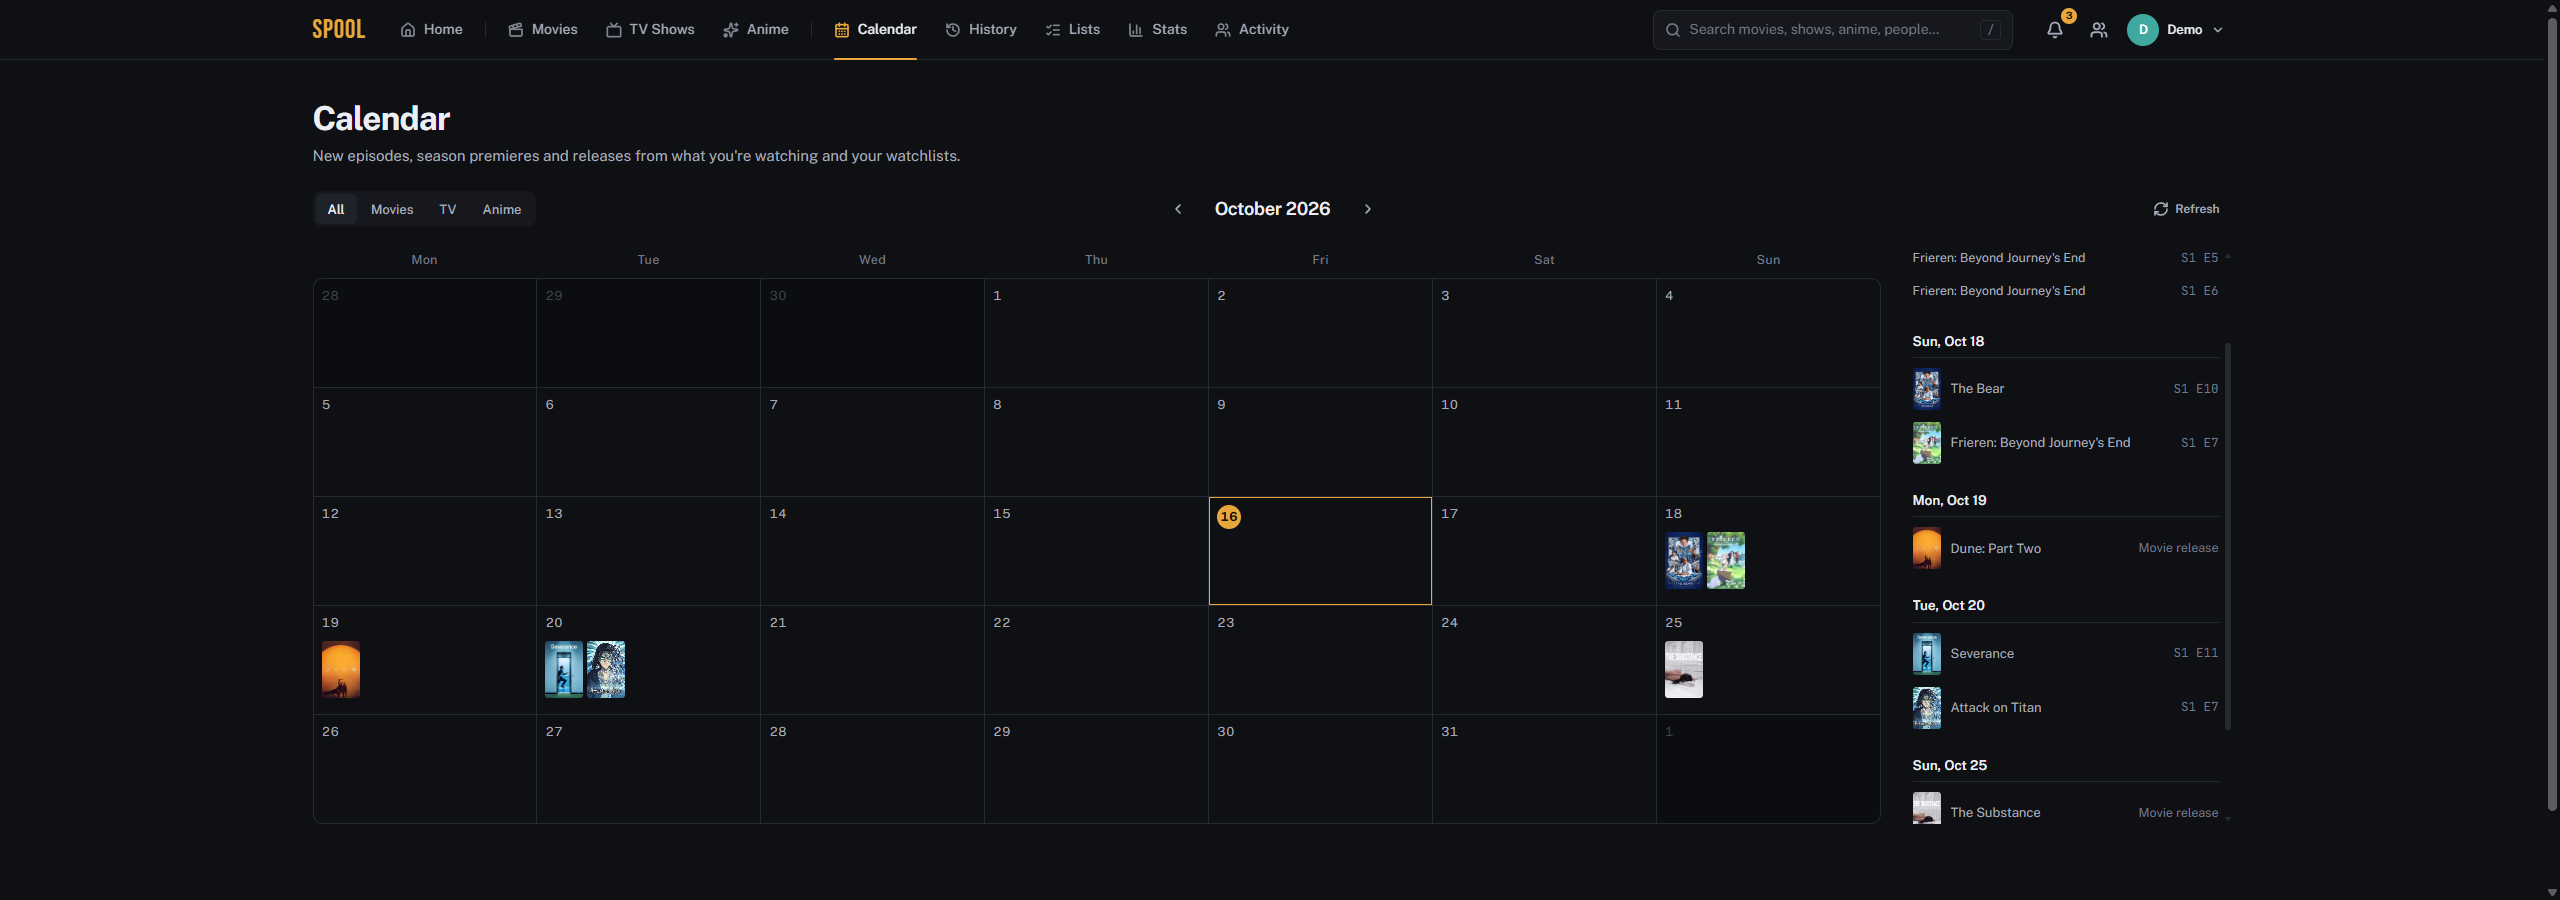
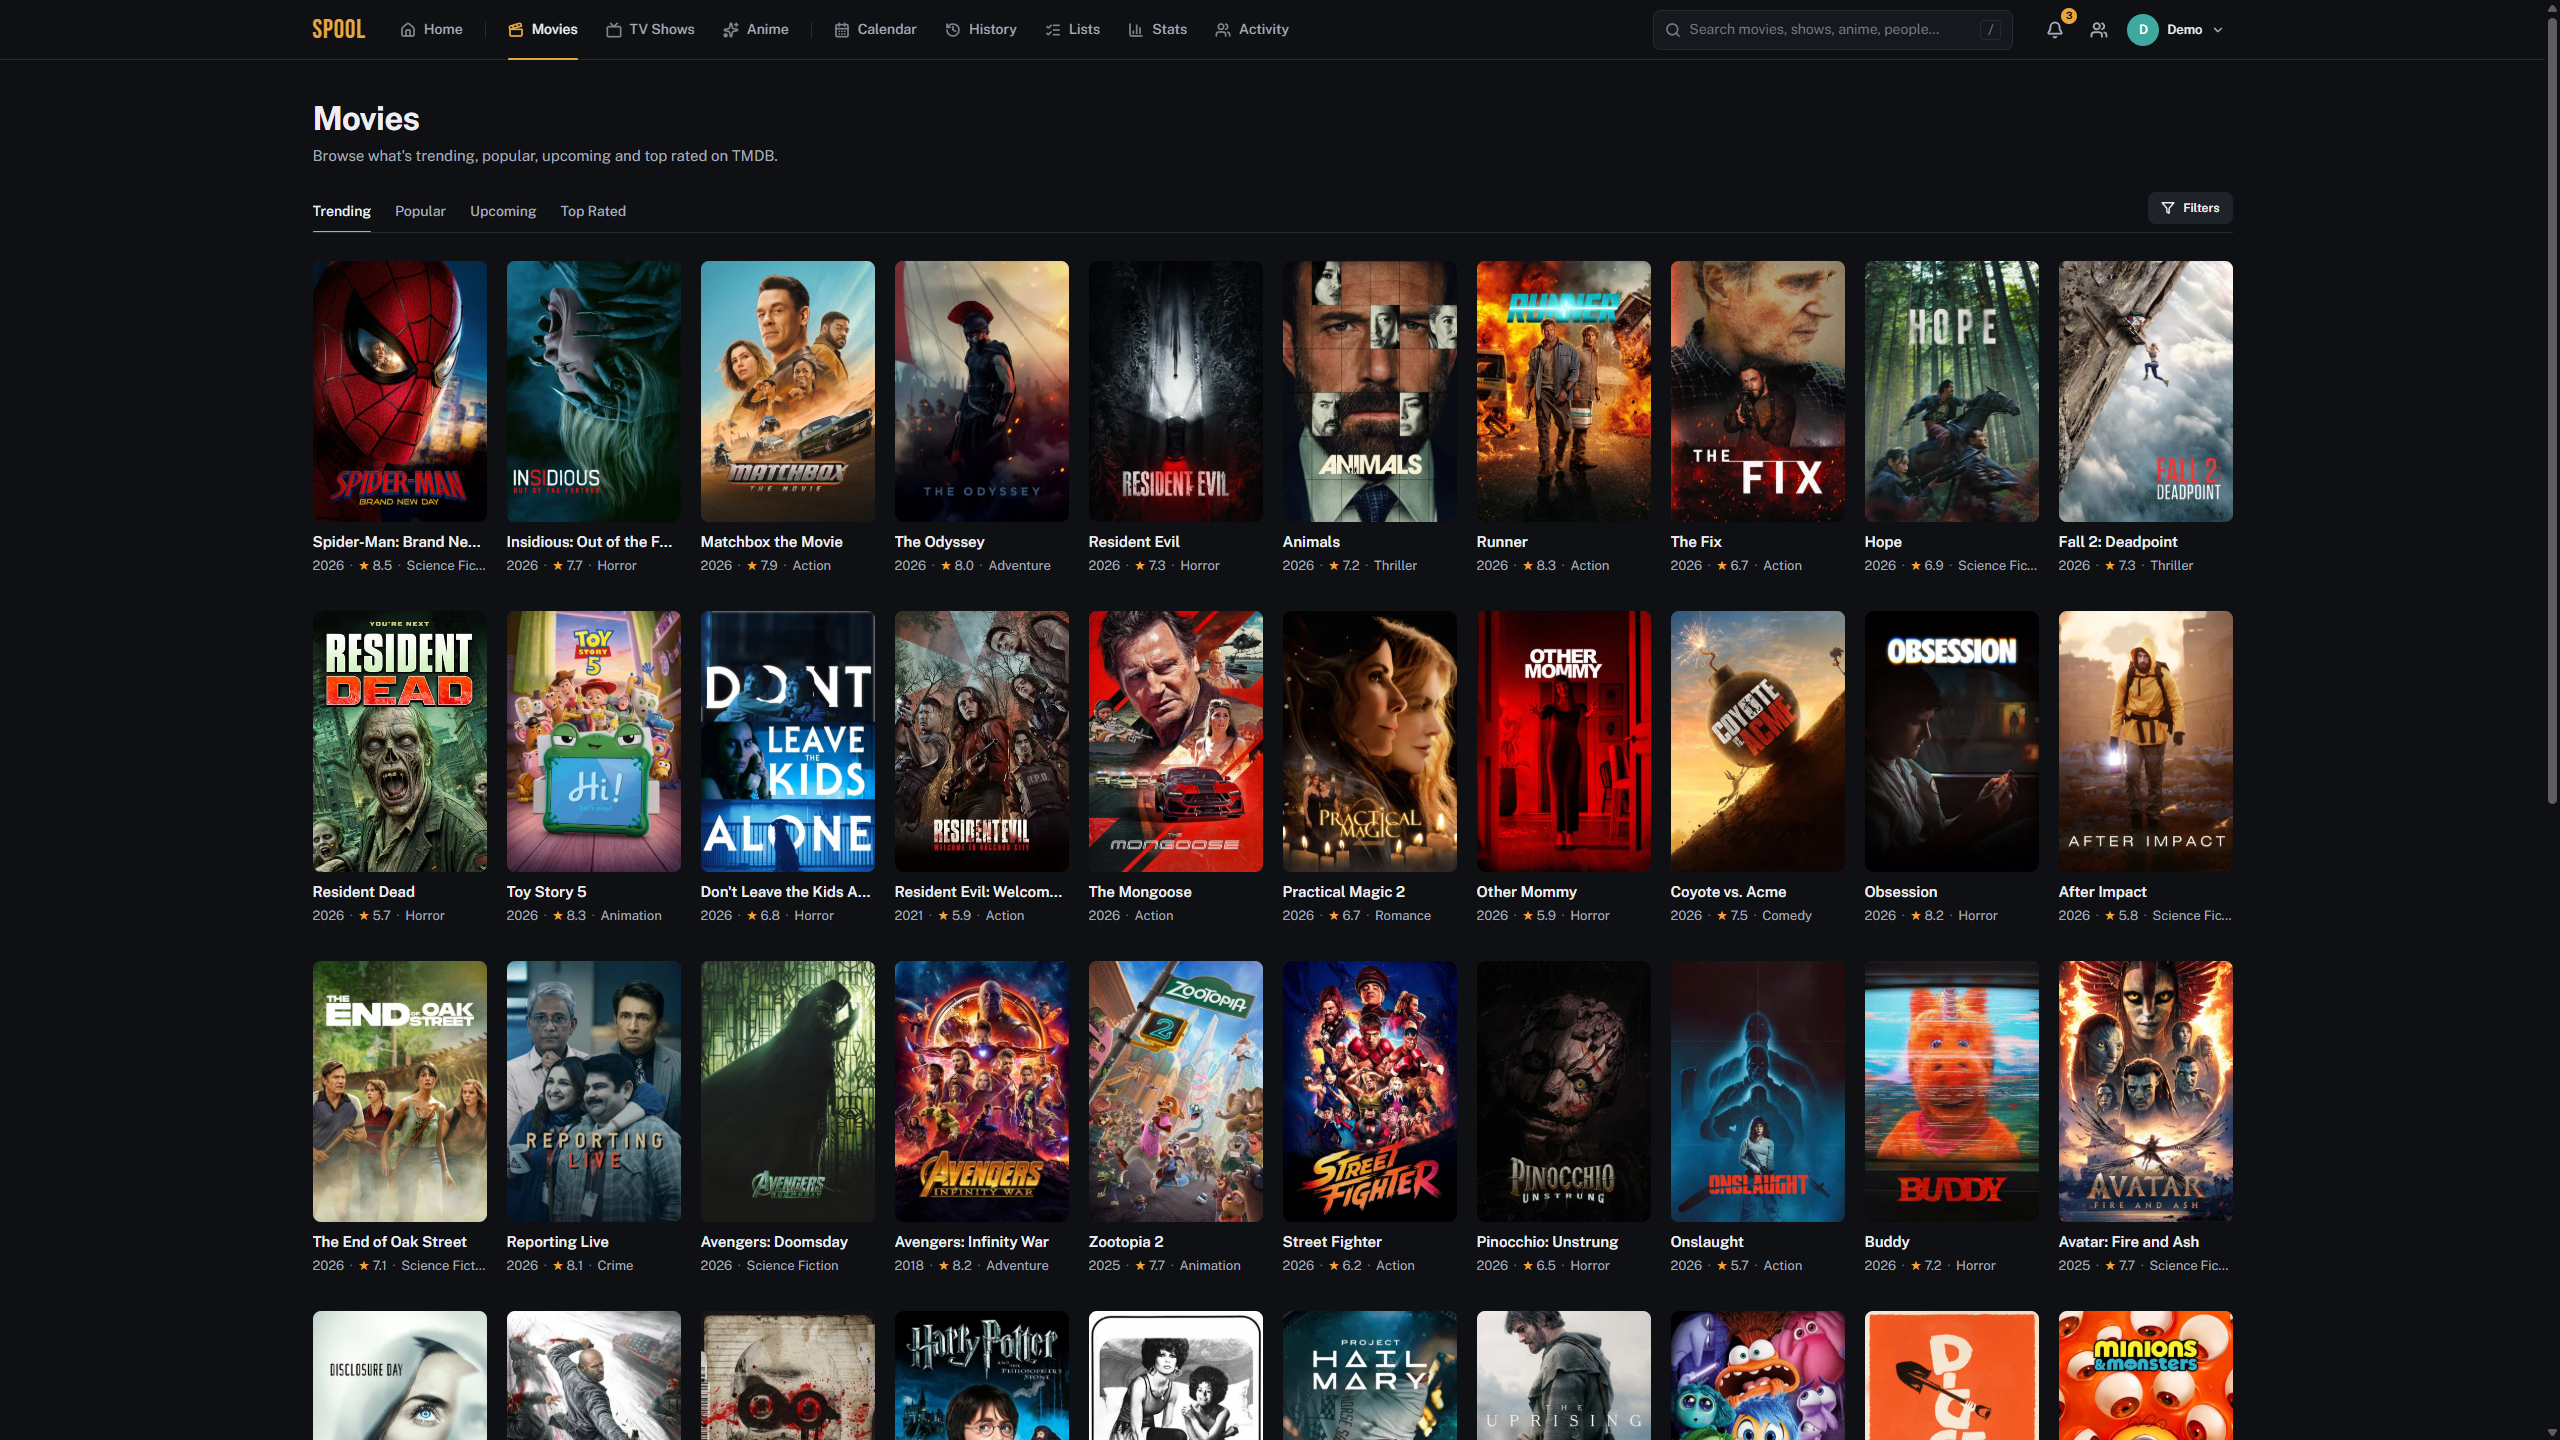
La interfaz está construida con HTMX para un rendimiento rápido sin recargas completas, ofreciendo vistas detalladas de títulos, calendarios de episodios y análisis de actividad. Permite la importación de datos desde CSV o sincronización OAuth con Trakt, Simkl y Nuvio. Además, ofrece APIs públicas para scrobble directo desde reproductores externos y generación de informes para servicios terceros como spool-wrapped.
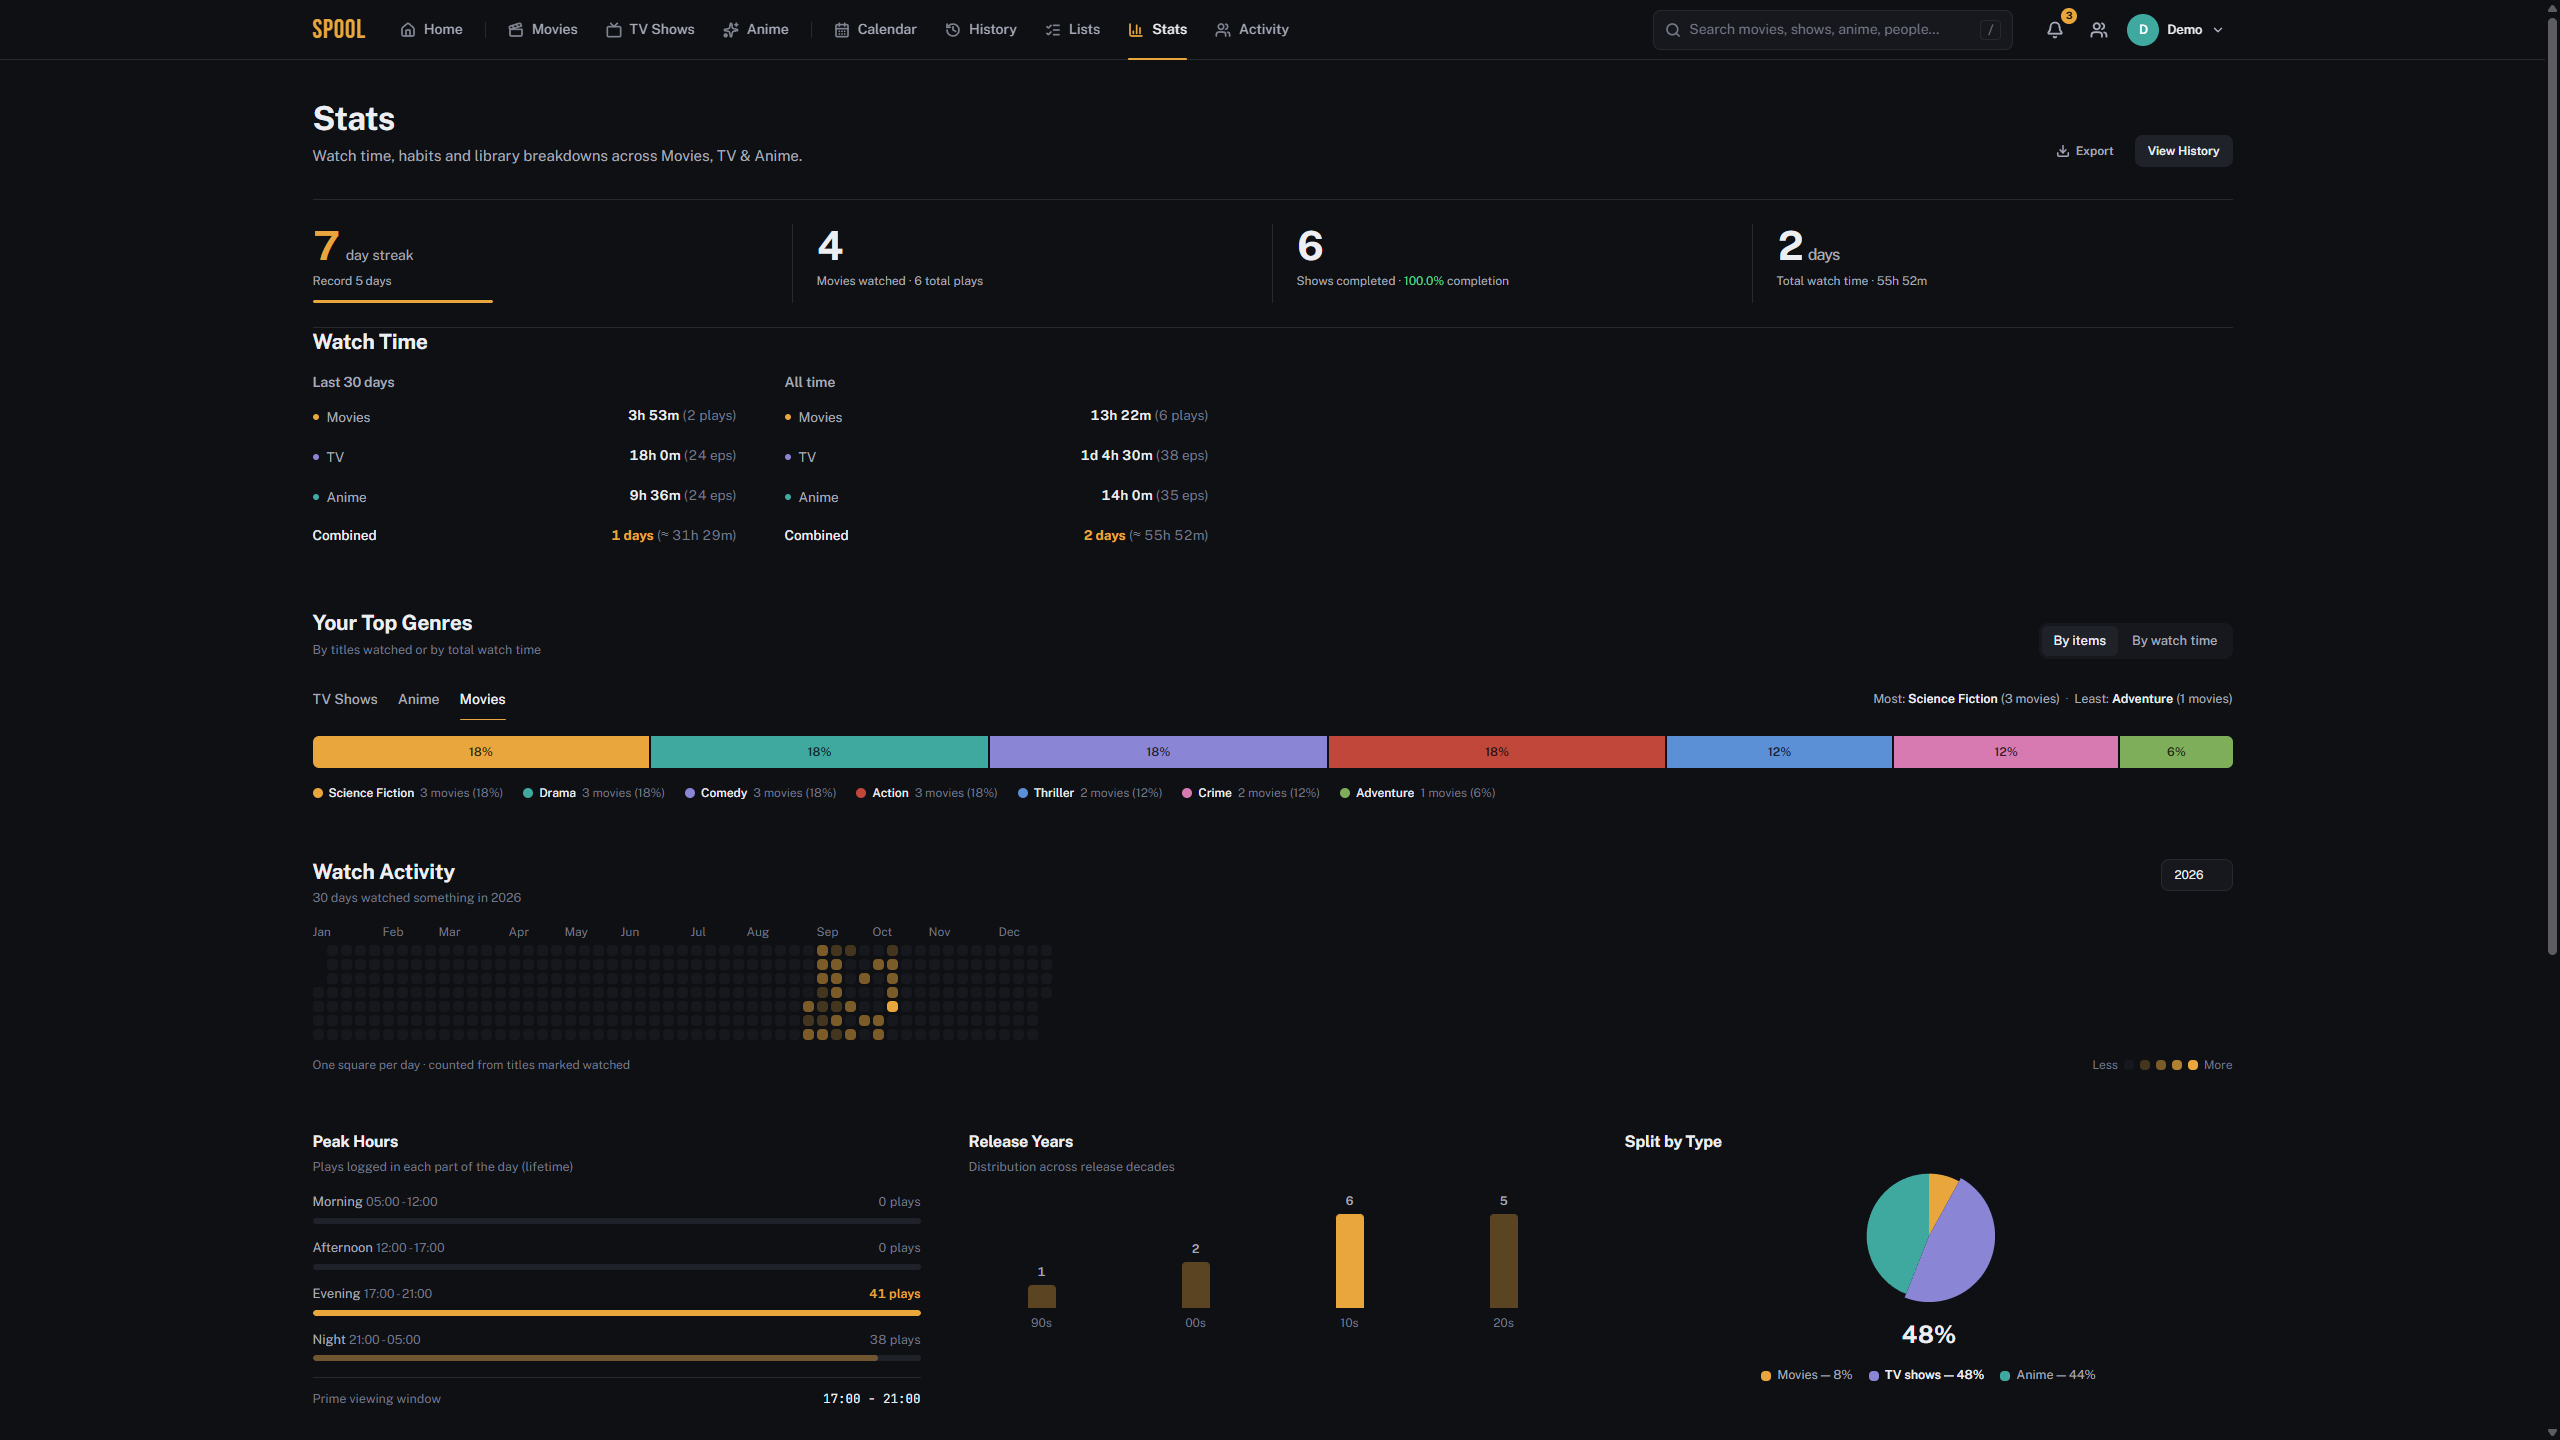
La aplicación soporta múltiples perfiles familiares en una sola instancia, permitiendo compartir listas mientras mantiene historiales privados. Incluye funcionalidades avanzadas como rachas de visualización, mapas de calor de actividad y recomendaciones anónimas entre usuarios.
- Gestión centralizada del historial de visualización familiar sin depender de APIs externas para el almacenamiento principal.
- Sincronización automática de calendarios de estrenos y episodios desde TMDB para cualquier título en la lista de seguimiento.
- Importación masiva de datos históricos mediante CSV con mapeo de columnas y validación previa al commit.
- Recomendaciones de títulos a compañeros del hogar, incluyendo un sistema de recomendación anónimo misterio.
- Estadísticas avanzadas como rachas de visualización, desglose por género y mapas de calor de actividad.
- Privacidad total: Los datos de historial y preferencias residen en tu servidor, no en una nube centralizada.
- Sincronización híbrida: Soporta conexión OAuth con Trakt/Simkl o autenticación por contraseña con Nuvio.
- Integración multimedia: Enriquecimiento automático de anime vía MyAnimeList sin necesidad de API keys adicionales.
- Escalabilidad familiar: Múltiples perfiles compartidos en una sola instancia con listas privadas y públicas.
- APIs abiertas: Incluye endpoints para scrobble genérico y reports de historial para servicios externos.
- Dependencia de APIs externas: La sincronización de metadatos depende de la disponibilidad de TMDB, MyAnimeList y Trakt/Simkl.
- Recursos mínimos: Requiere al menos 2 núcleos CPU y 2 GB de RAM según especificaciones del análisis técnico.
- Configuración inicial: Necesita ejecución de setup.sh o despliegue manual de variables de entorno .env.
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Recomendado usar el script ./setup.sh para generar automáticamente el archivo .env y levantar la pila Docker Compose. Para entornos de producción, utilizar docker-compose.prod.yml. Asegurar que los puertos 8000 estén libres y configurar correctamente las variables de entorno de PostgreSQL y Redis antes del primer inicio.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.