rembric
Rembric es una memoria persistente para agentes de IA autohosteados. Es nativo MCP, append-only y usa un solo contenedor Docker con un único archivo SQLite.
Ficha actualizada 23 sept 2026, 17:09 · upstream 23 sept 2026, 17:08 · release server-v0.28.9
Qué es rembric
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
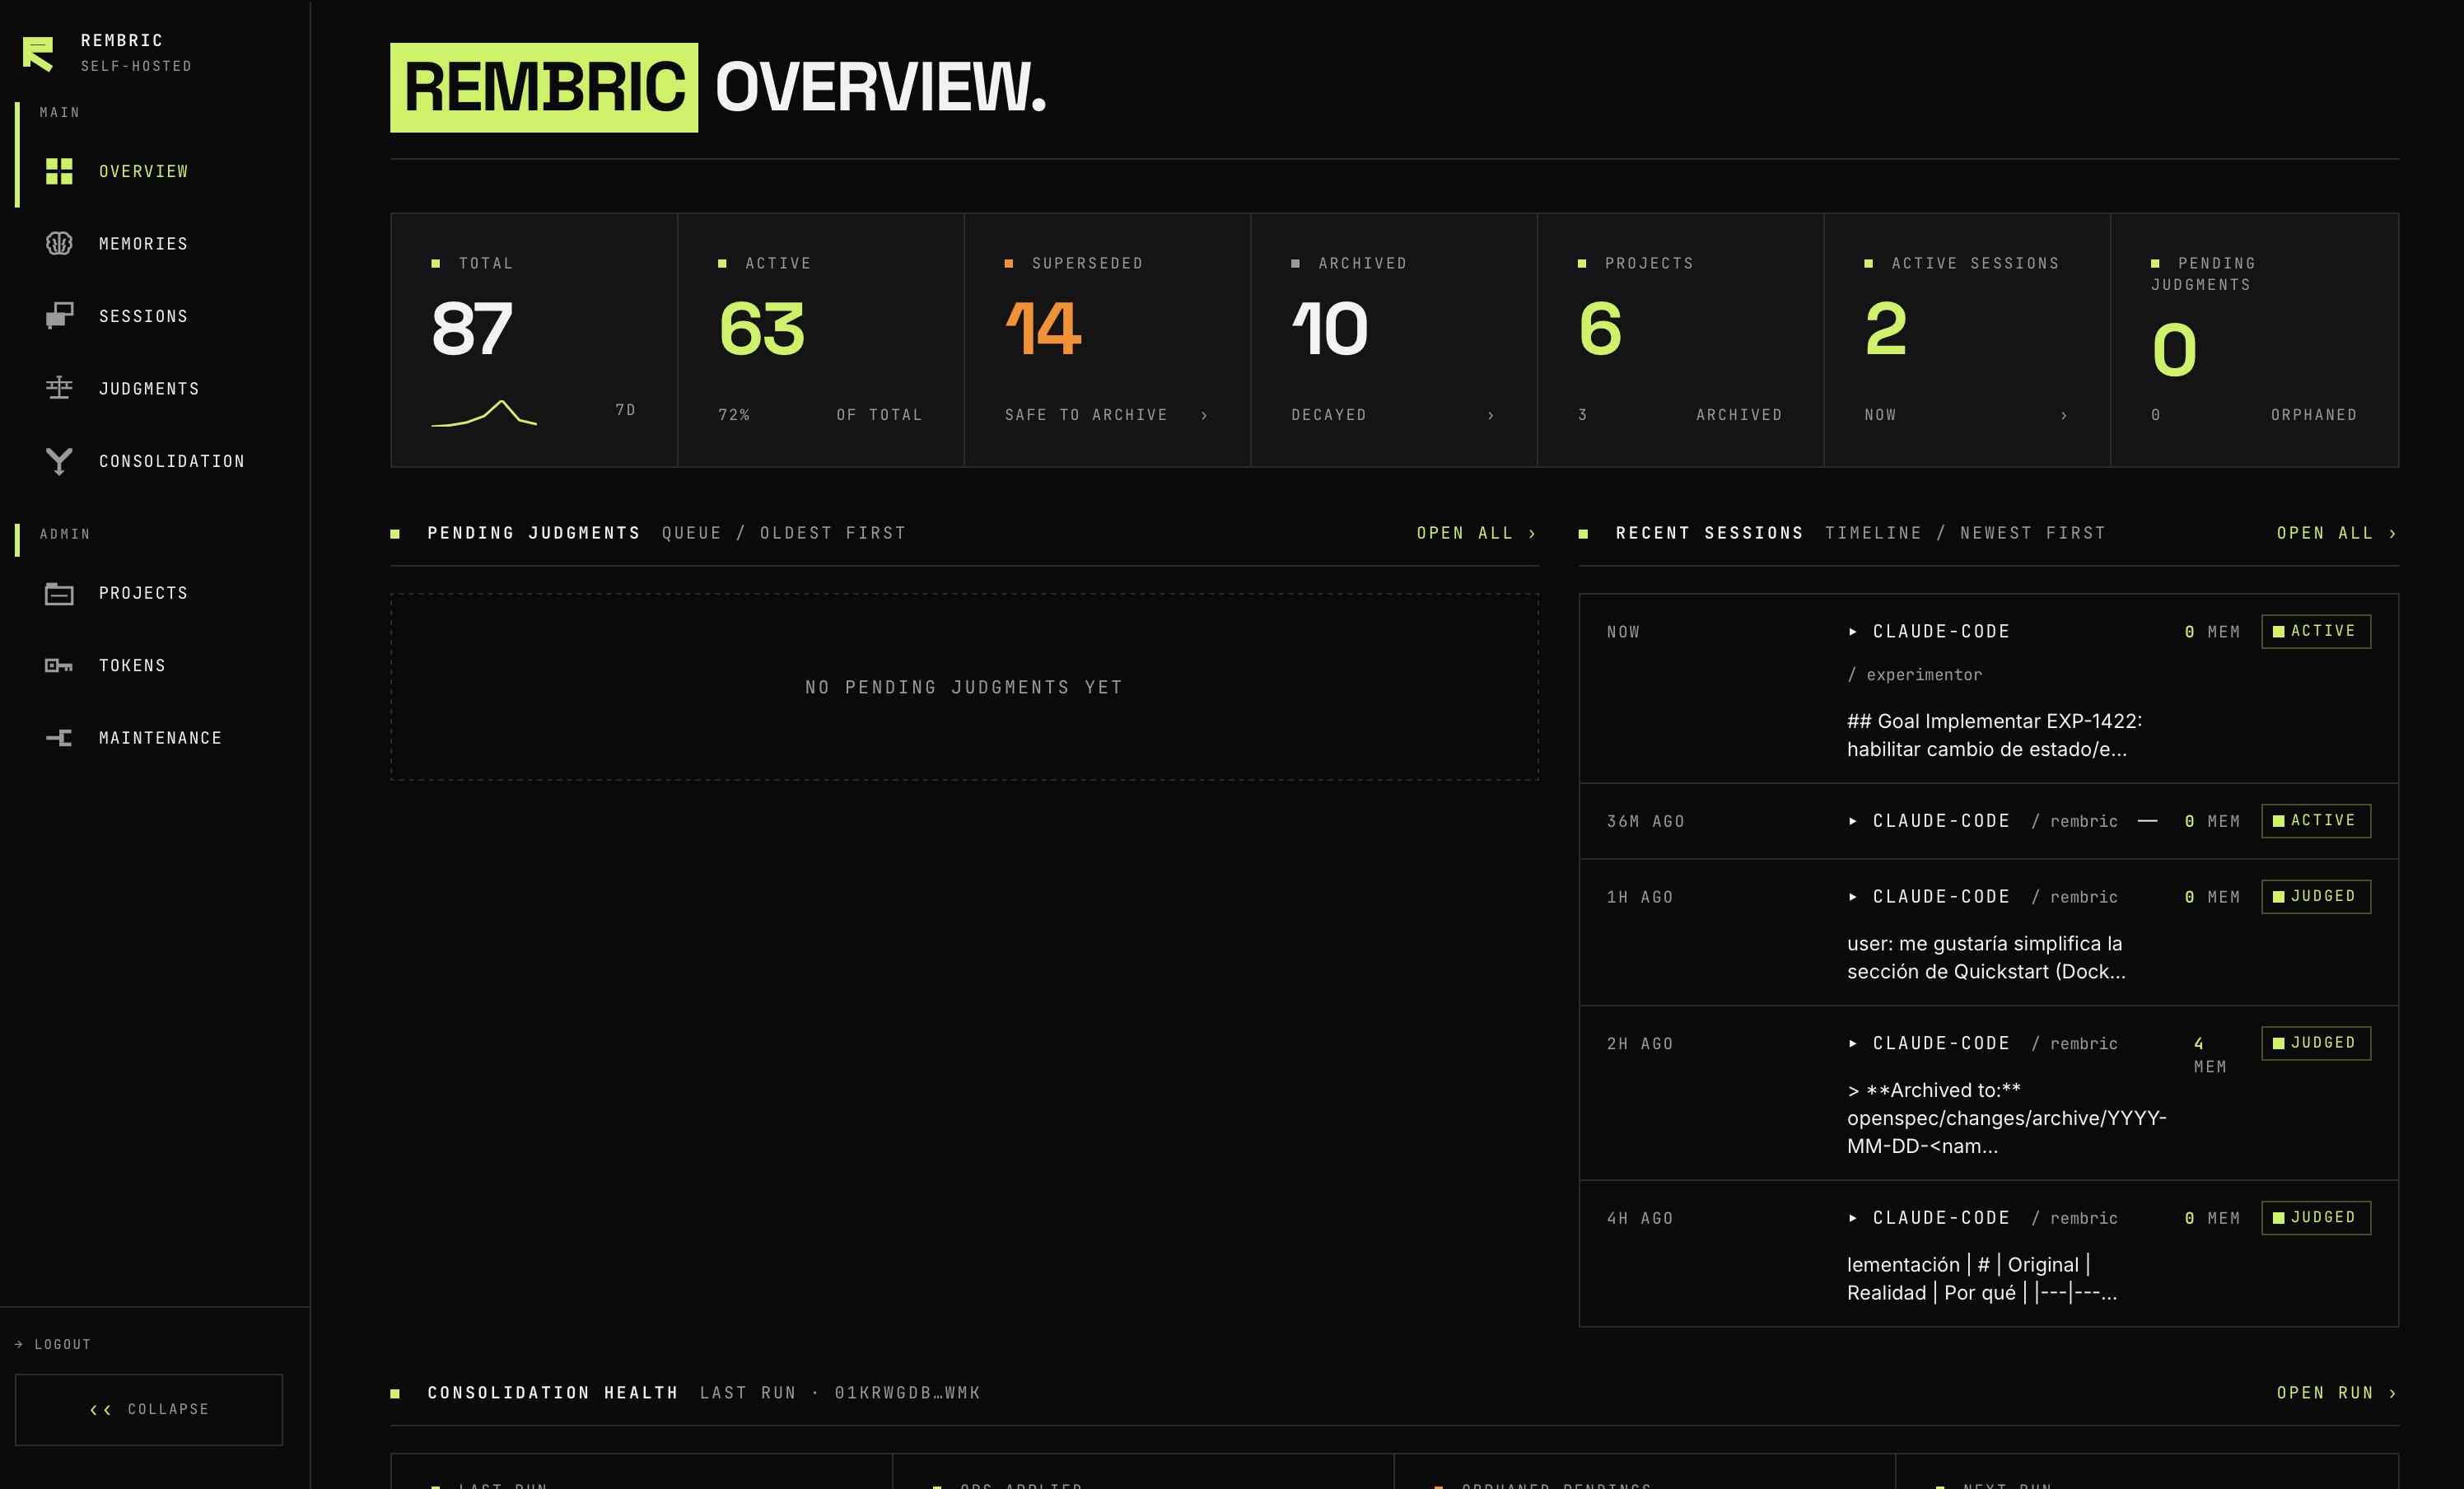
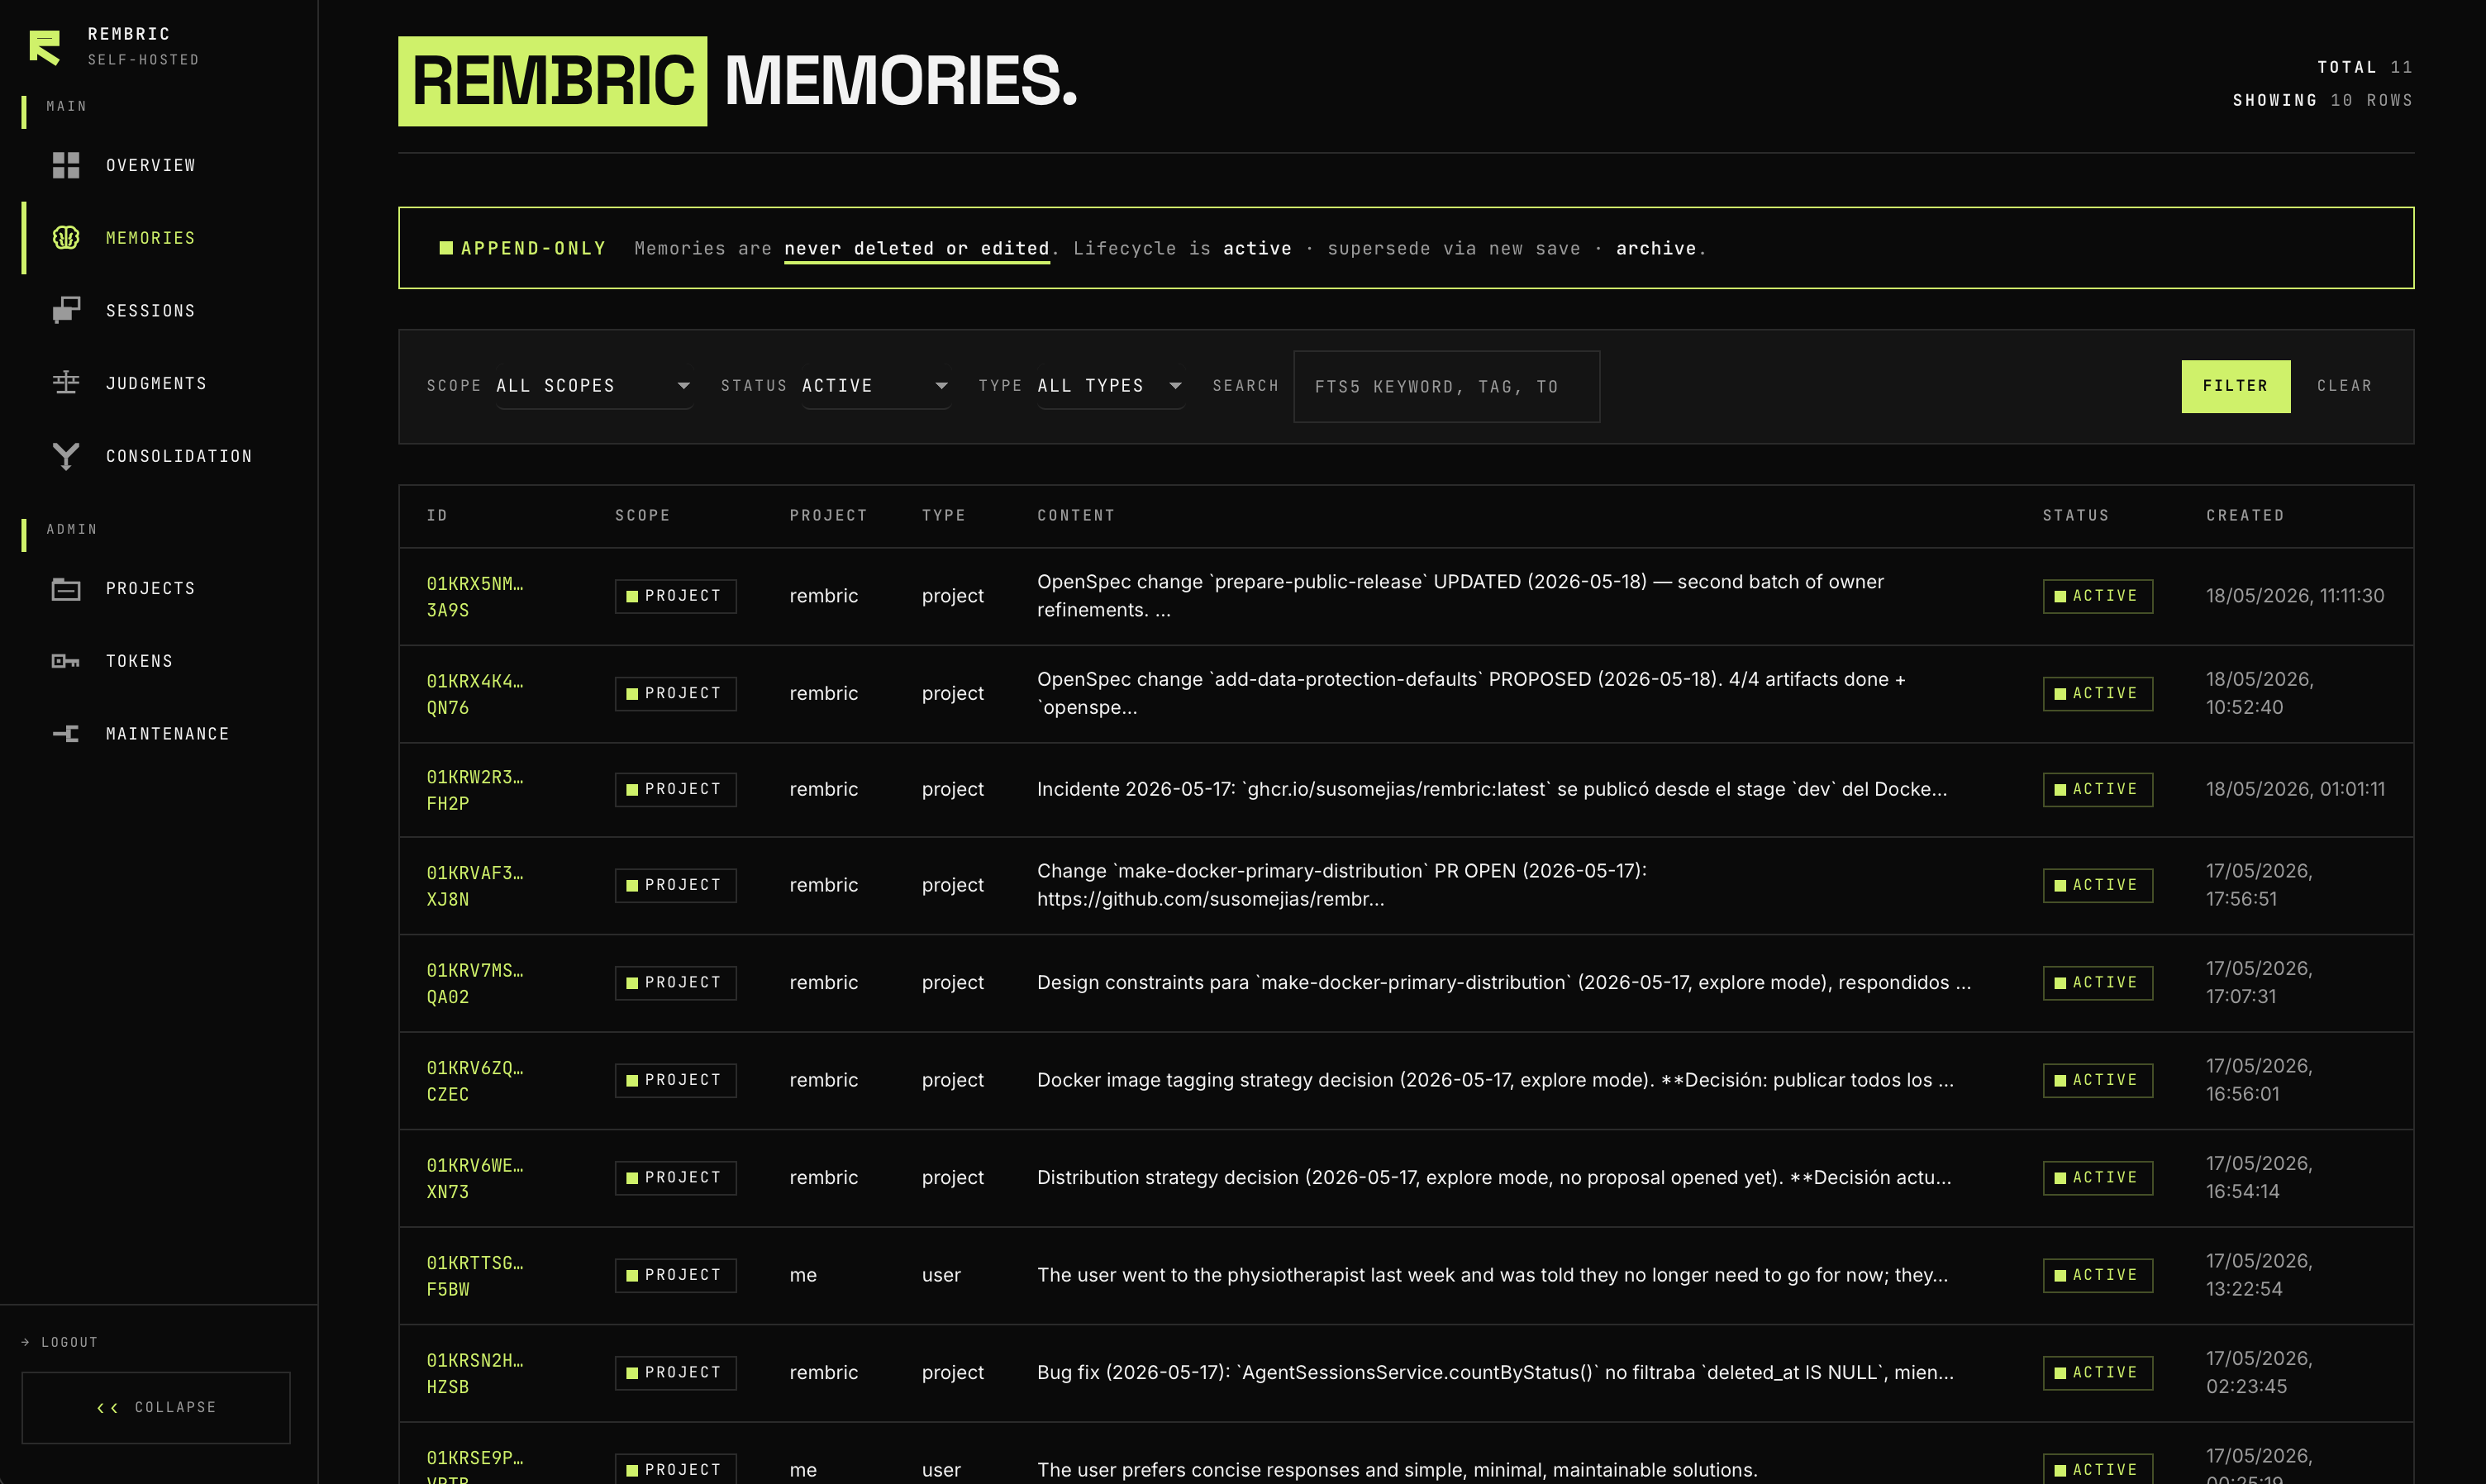
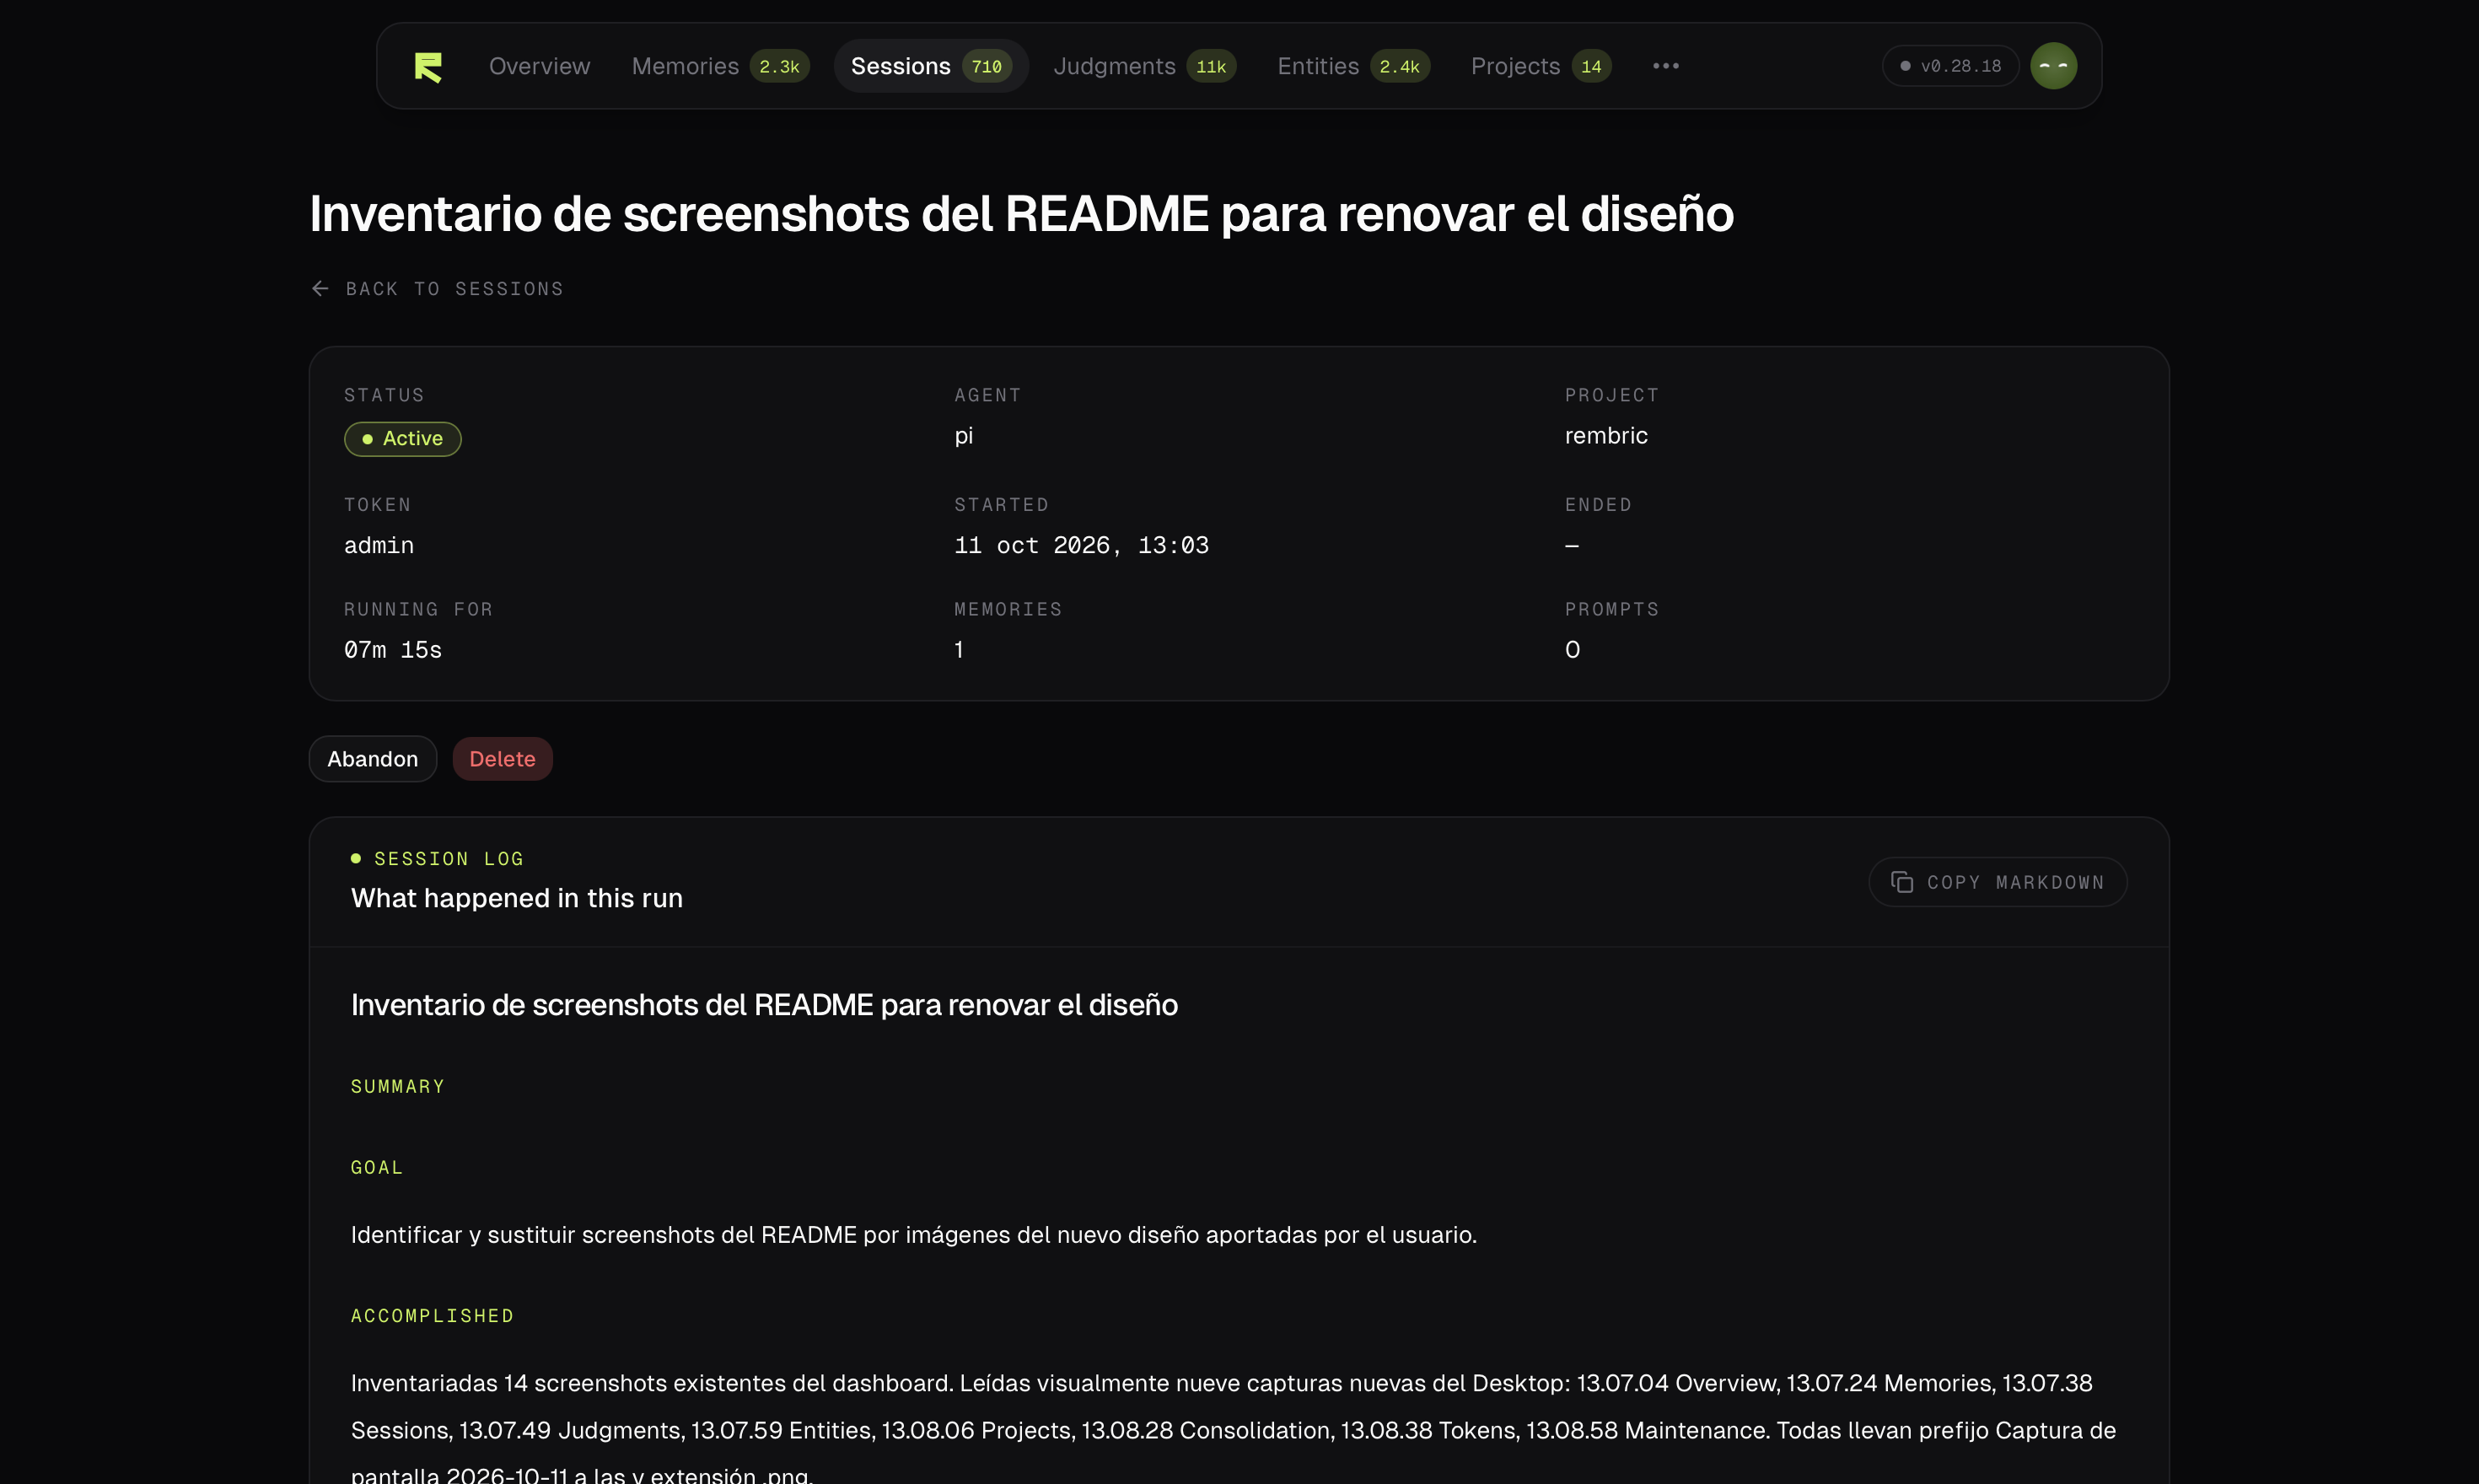
Rembric proporciona memoria persistente, sesiones y panel de control para agentes de codificación de IA. Funciona como una capa de memoria bajo la que operan los agentes: Claude Code, opencode, Hermes Agent, Pi, Cursor y más. El diseño es reversible por defecto y multiplica clientes en un solo proceso Node.js. La superficie MCP es el núcleo; las sesiones, juicios, consolidación y el panel del operador se integran en ese mismo proceso.
- Gestionar sesiones de codificación para múltiples agentes concurrentes
- Almacenar historial de comandos y decisiones de cada agente
- Permitir auditoría y trazabilidad de acciones tomadas por los agentes
- Soportar contenido privado con redacción encriptada antes del envío
- Facilitar la migración entre versiones de agentes sin perder contexto
- Arquitectura monolítica: todo corre en un único proceso Node.js
- Diseño reversible: no se pierde datos al reiniciar el contenedor
- Soporte nativo para múltiples clientes MCP simultáneamente
- Redacción de contenido privado antes del envío a la red
- API MCP nativa sin necesidad de plugins adicionales
- Requiere Docker instalado en el host (no se ejecuta directamente)
- El contenedor no incluye shell ni sqlite3 binario, por lo que no funciona como CLI standalone
- SQLite puede sufrir bloqueos de bloqueo en entornos NFS o SMB
- No tiene un panel web dedicado para la gestión del usuario final
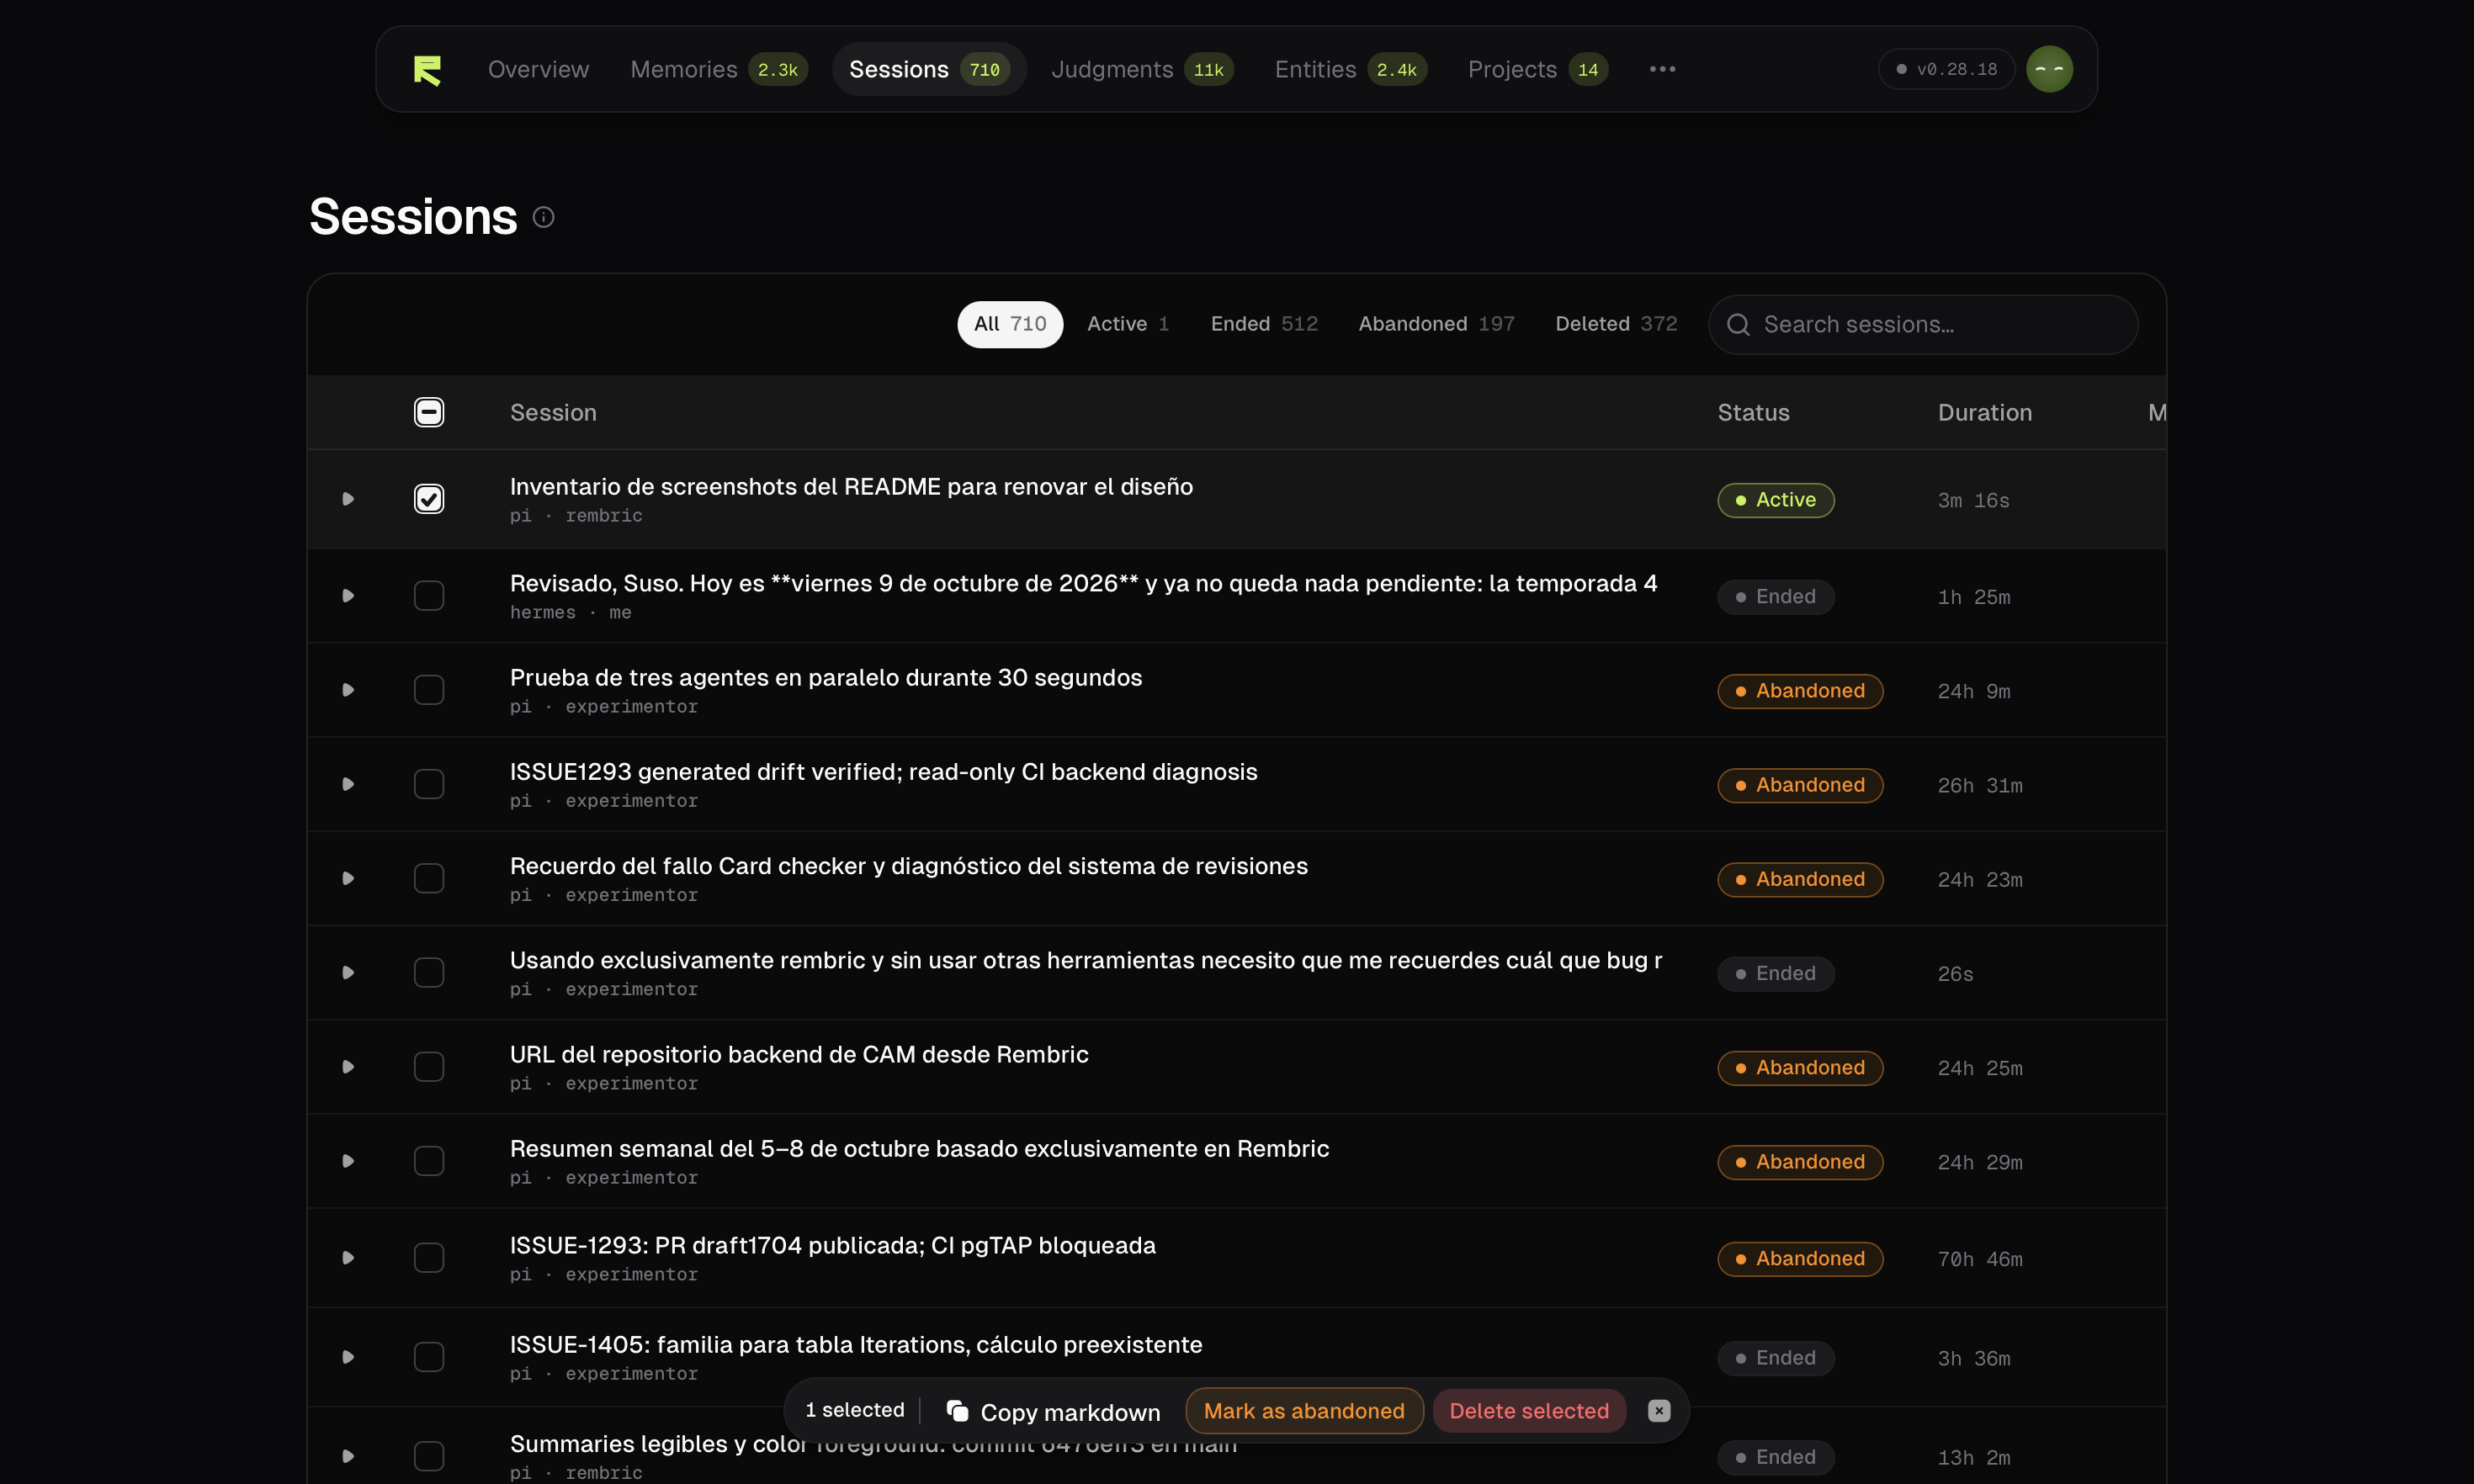
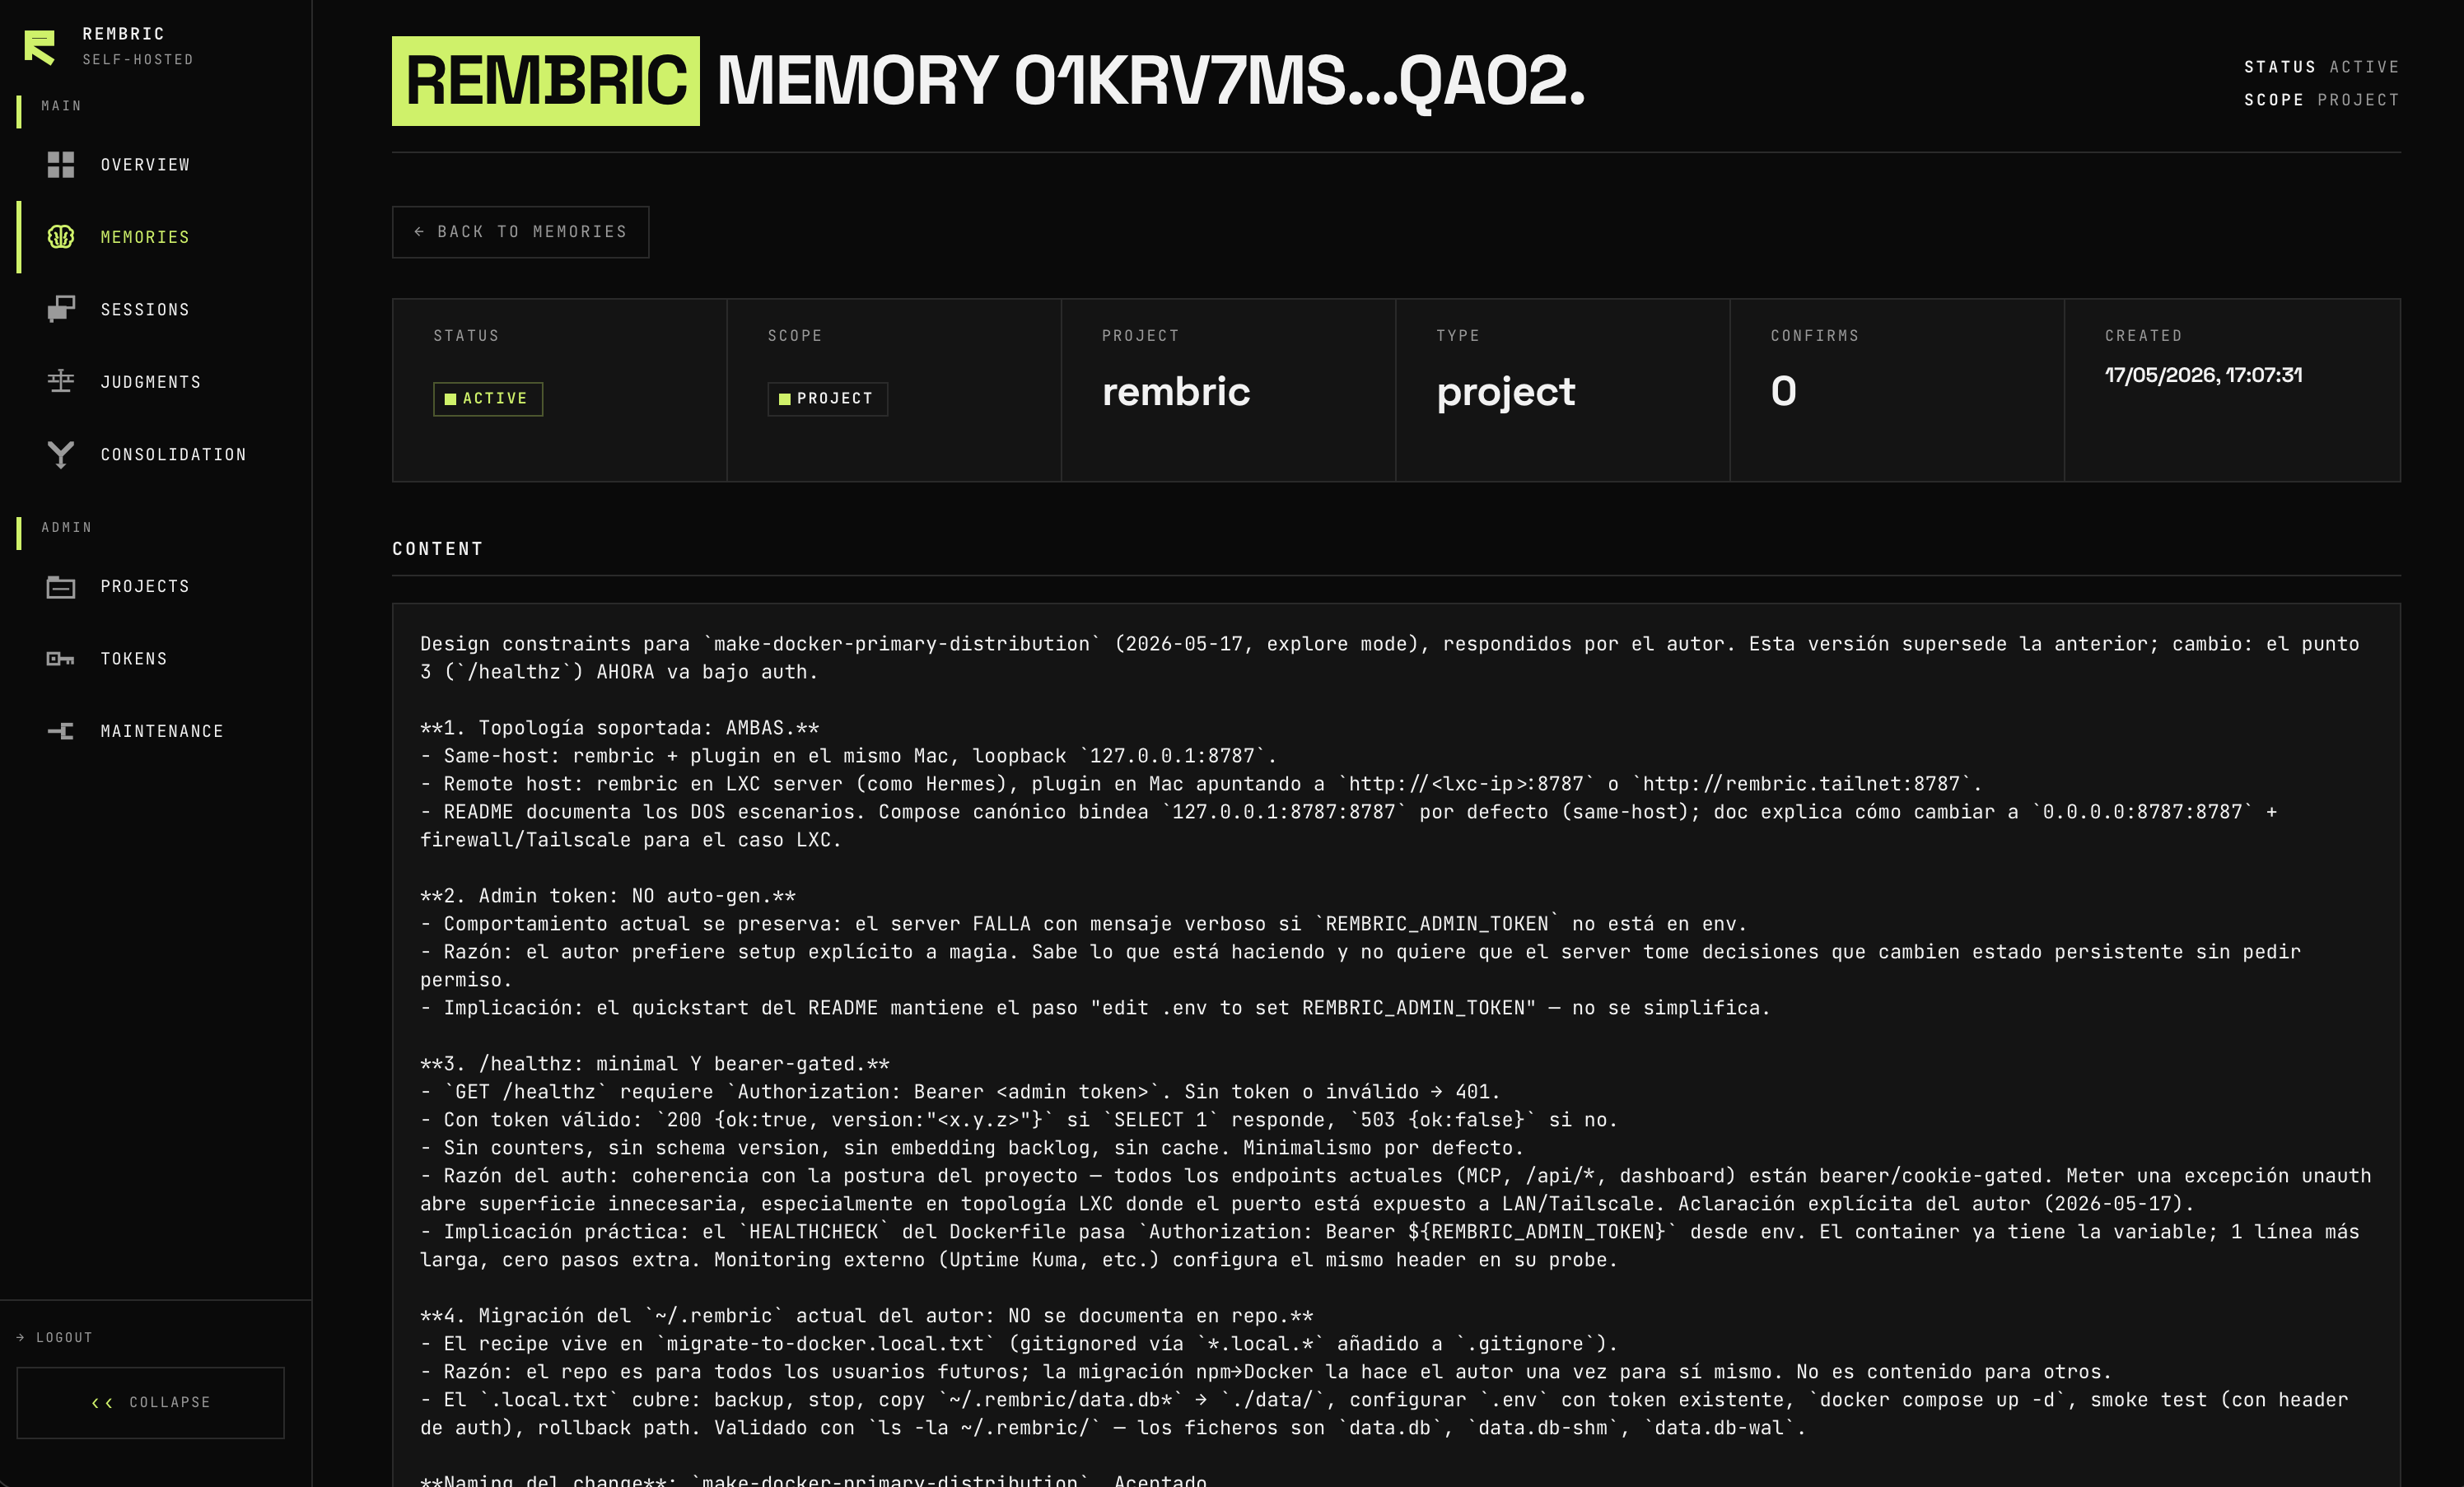
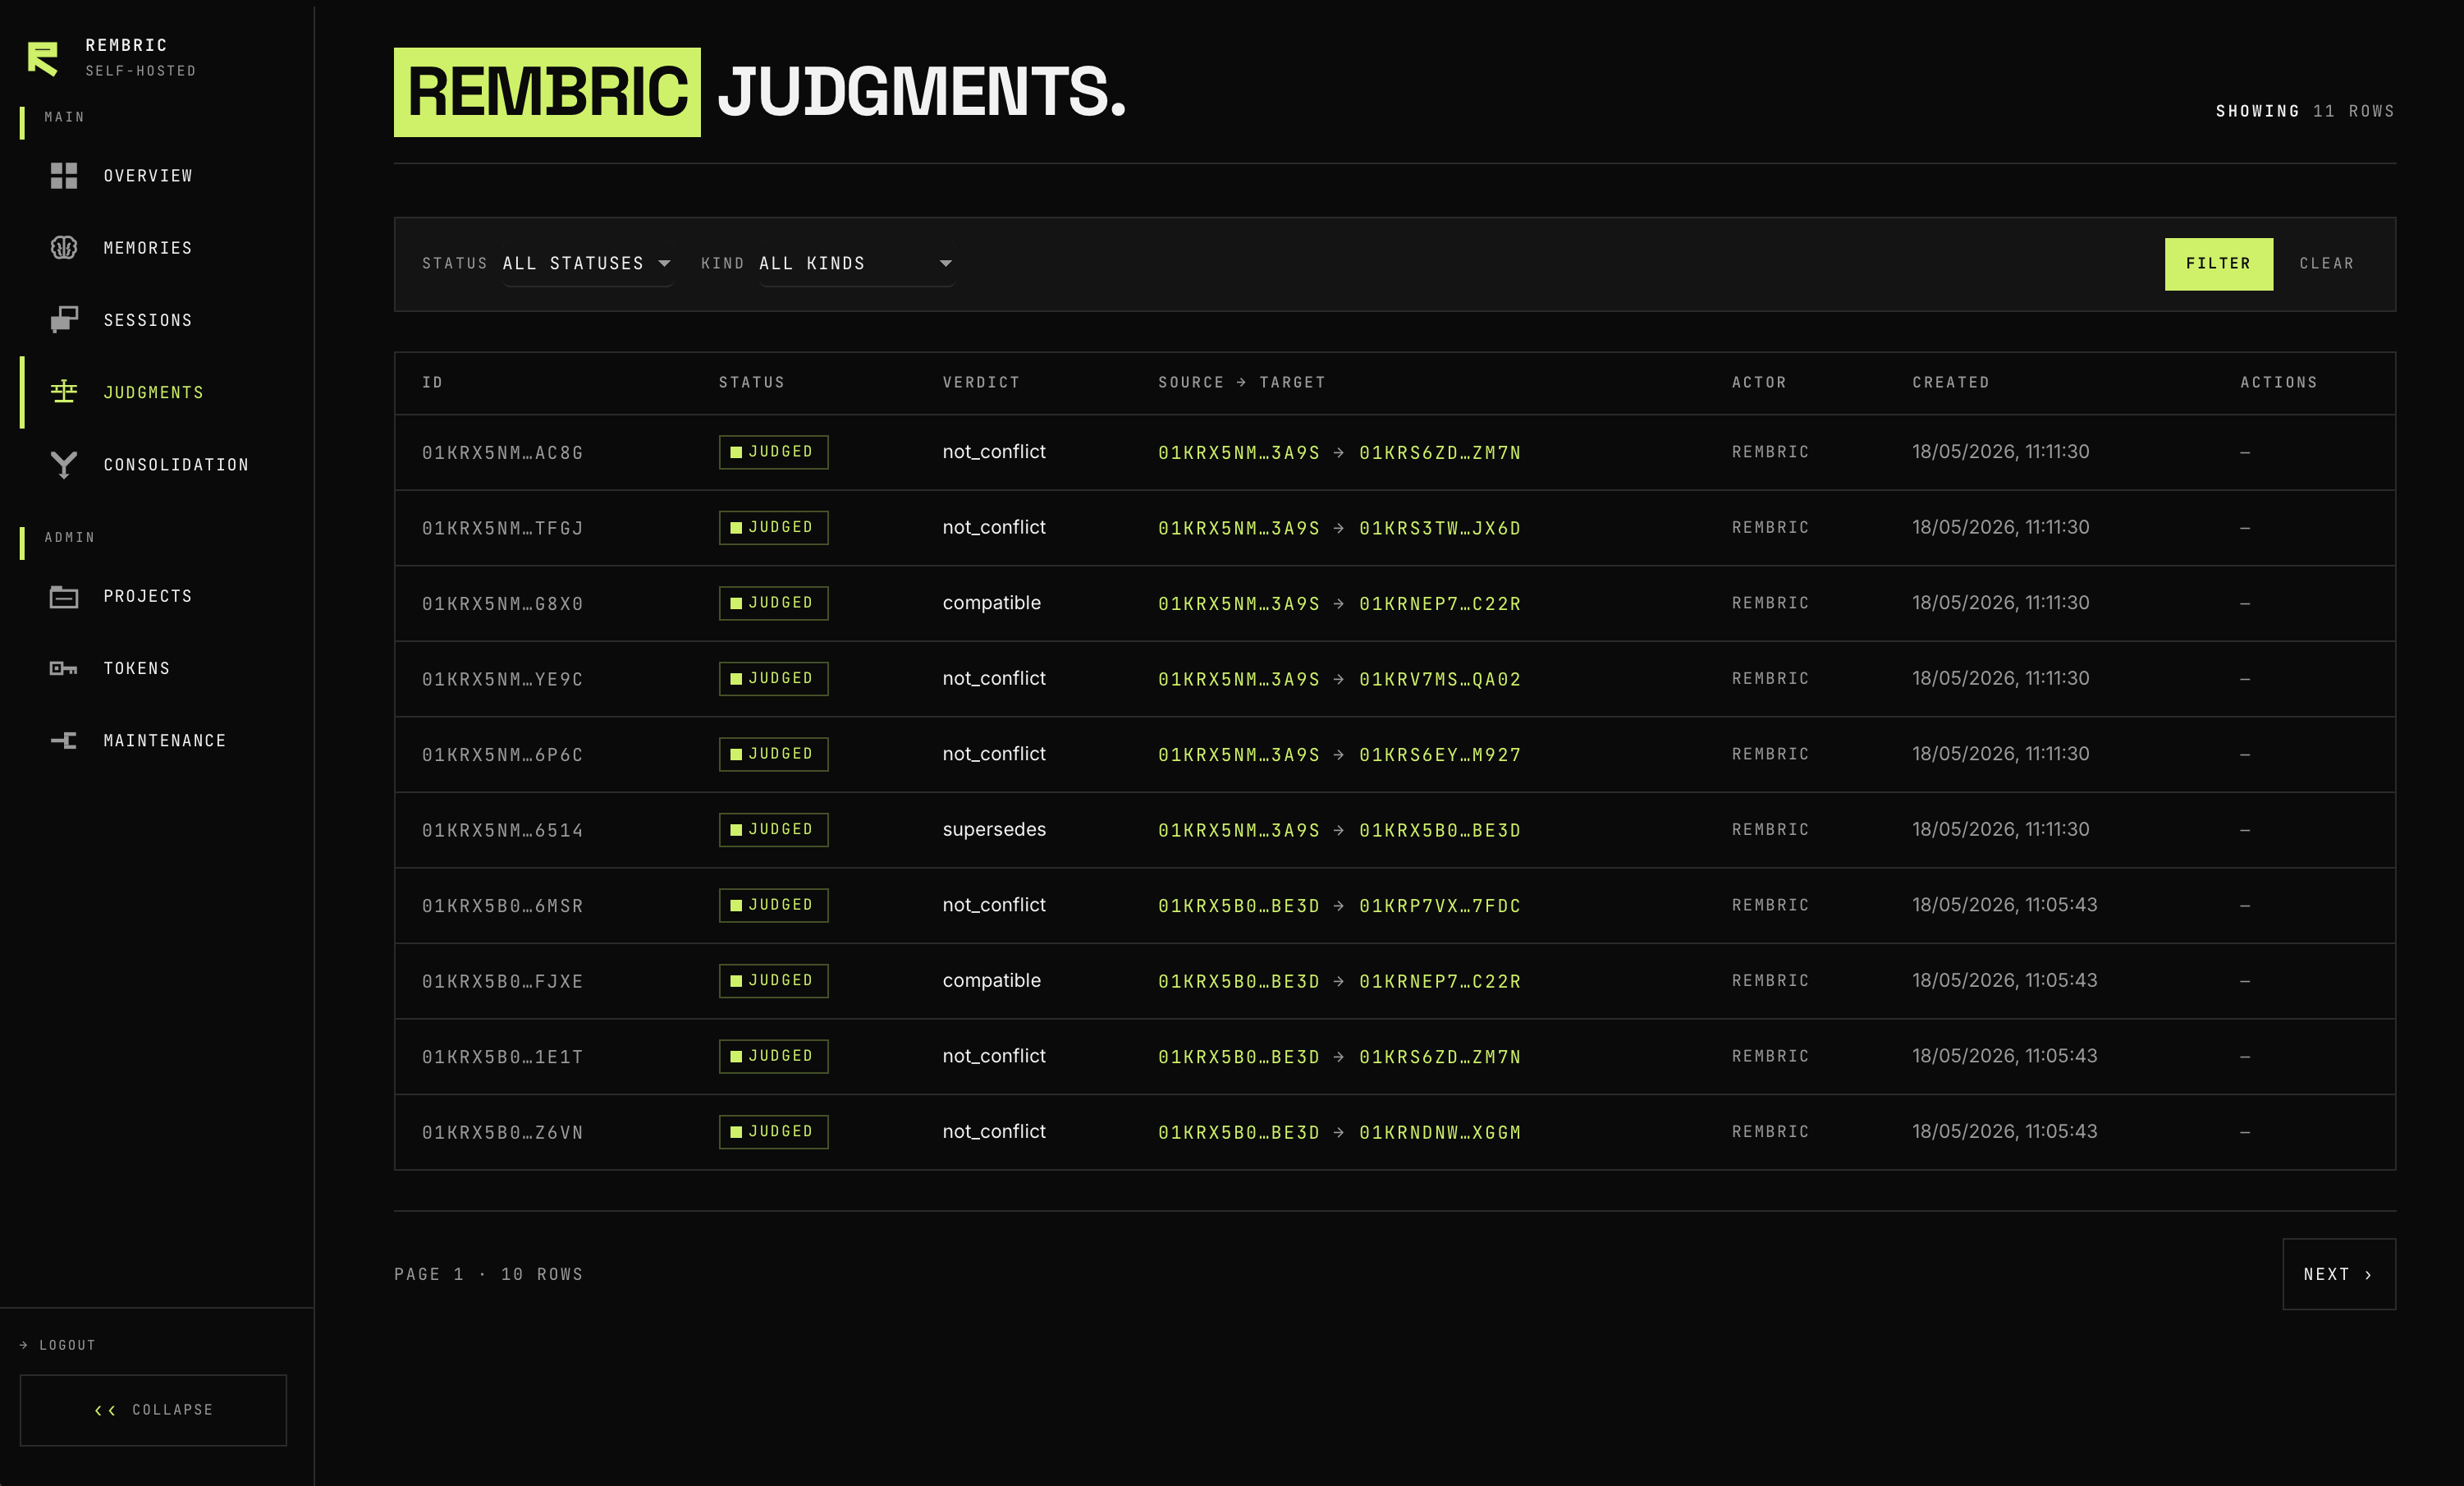
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.

Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Se recomienda usar Docker Compose. El token de administrador se genera al iniciar y debe guardarse en el entorno. Se puede restringir a loopback (127.0.0.1) mediante docker-compose.override.yml si solo se usa en la misma máquina. Para producción, se debe exponer port 8787 con un proxy o Tailscale. El backup se realiza desde el panel del dashboard y nunca se debe bind-mount ./data/ a NFS/SMB.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.