
RAGandRAGfind
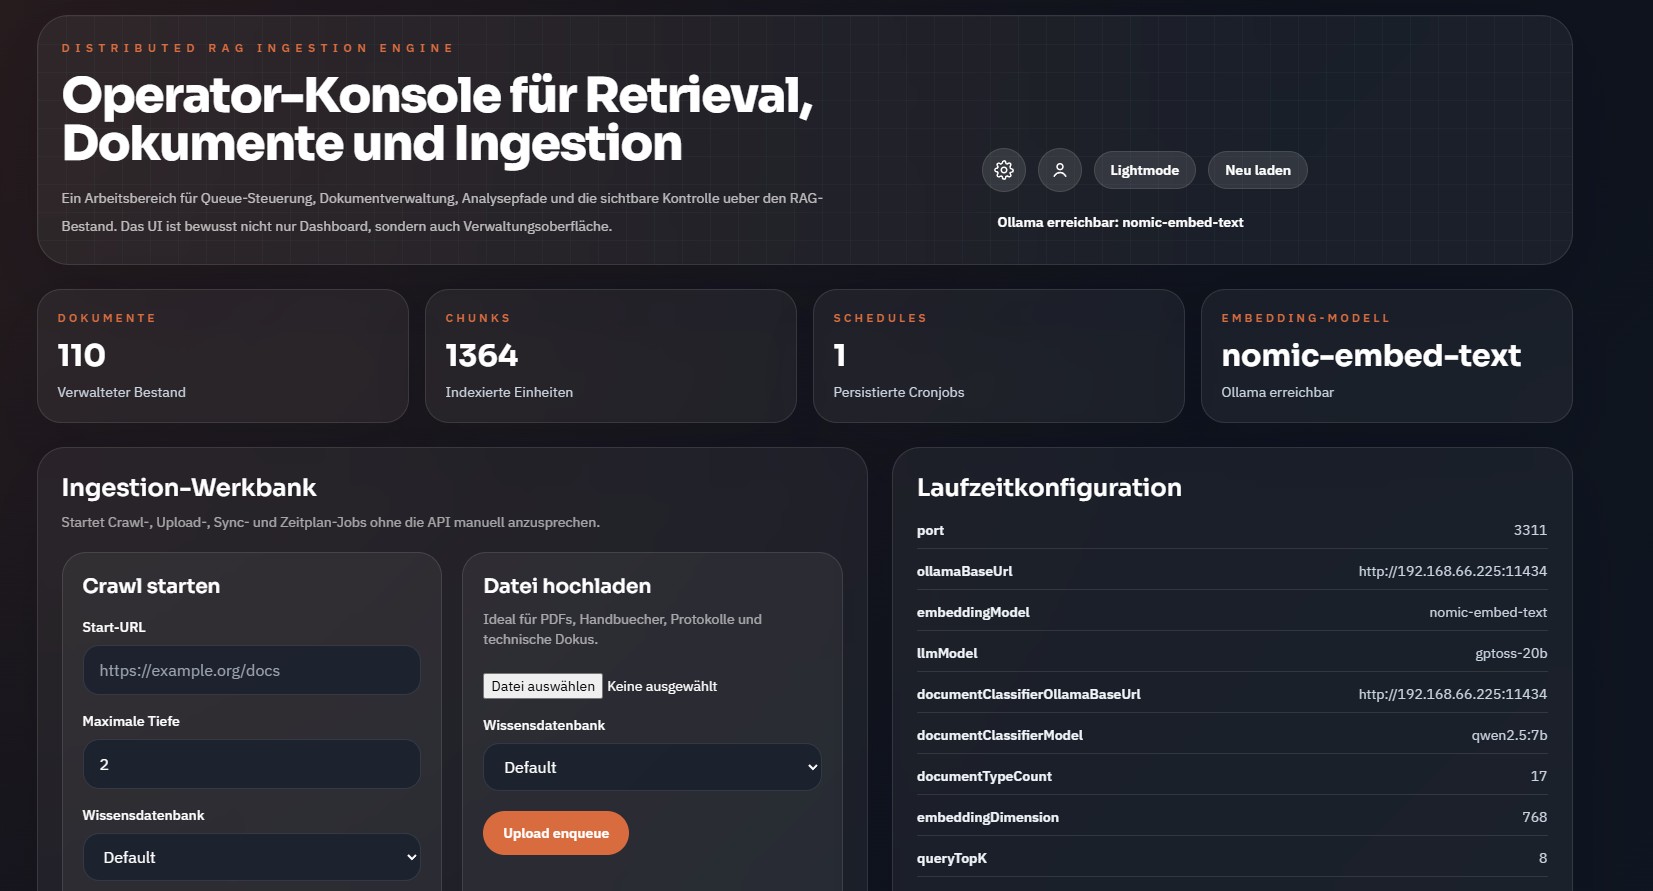
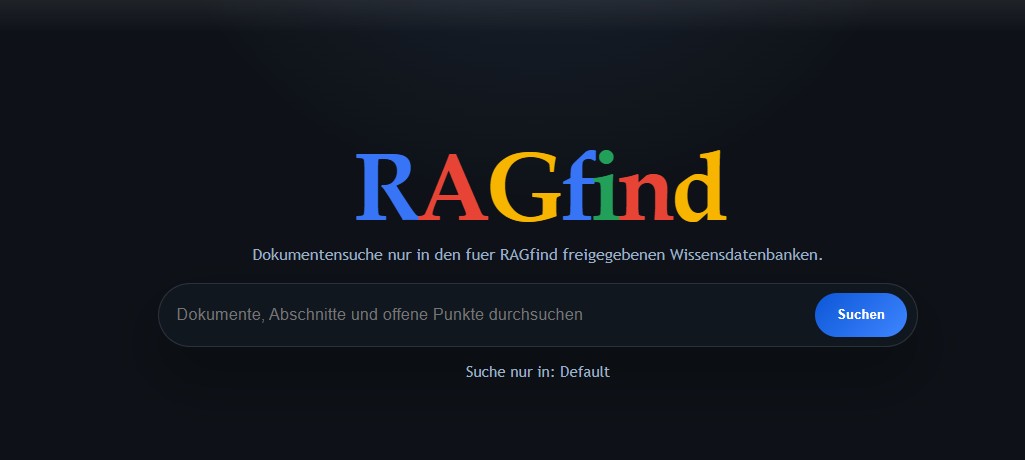
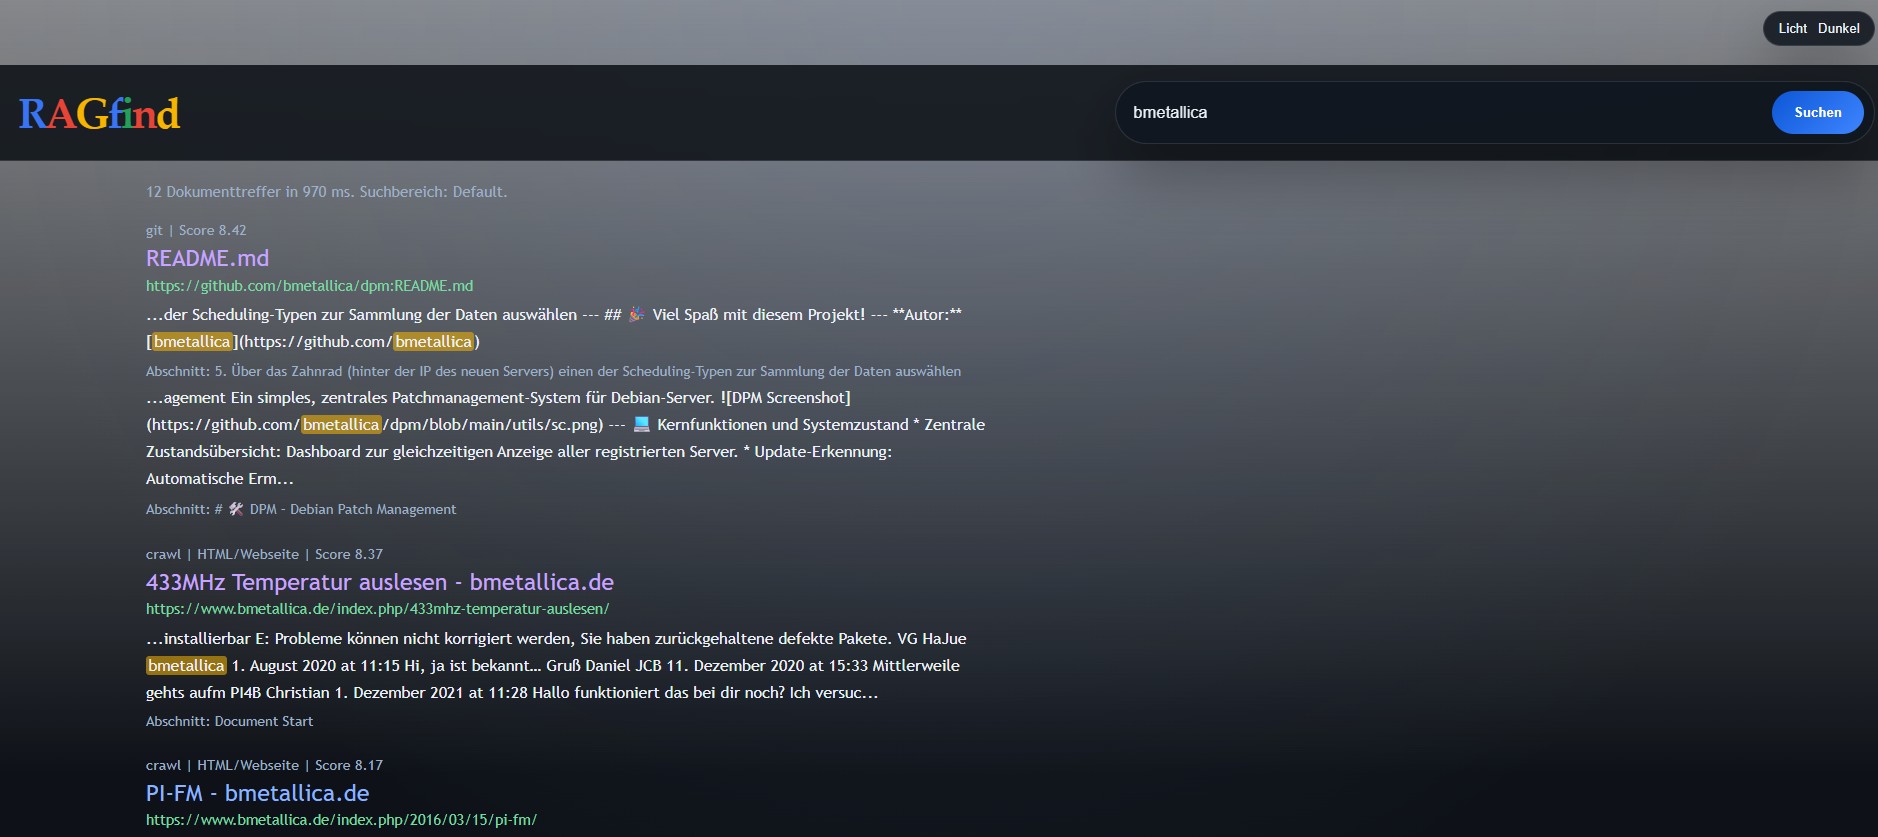
Plataforma RAG centrada en documentos con ingestión híbrida (uploads, sync, crawl, Git), OCR, búsqueda semántica/keyword/reranking, MCP integrado y dos interfaces separadas (Admin 3311, RAGfind 3312). Usa PostgreSQL/pgvector, Redis, Elasticsearch opcional y Ollama para embeddings.
Ficha actualizada 23 sept 2026, 22:46 · upstream 23 sept 2026, 22:32 · release sin release detectada
Qué es RAGandRAGfind
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
RAGandRAGfind es una plataforma de recuperación aumentada generativa (RAG) centrada en documentos, diseñada para equipos que requieren más capacidades que la simple búsqueda vectorial. Integra ingestión de múltiples fuentes (archivos subidos, sincronización de directorios locales, crawling web y repositorios Git), extracción de texto con OCR como fallback, y clasificación automática de tipos de documento mediante Ollama antes del chunking.
La arquitectura separa el backend de gestión (`ingestor-app`) del frontend de búsqueda para usuarios finales (`ragfind`), permitiendo una configuración granular de bases de conocimiento. Utiliza PostgreSQL con pgvector para embeddings y texto completo, Redis para colas de trabajo (BullMQ) y Elasticsearch opcional para señales híbridas de búsqueda. La persistencia incluye metadatos de archivos originales, sections y asignaciones chunk-section para navegación estructural.
El sistema soporta análisis semántico avanzado mediante reranking documentocéntrico, expansión de contexto small-to-big e inventario de documentos. Incluye herramientas MCP (Model Context Protocol) tanto vía HTTP como stdio para integración con Open WebUI y otros clientes. La gestión administrativa permite CRUD de bases de conocimiento, control de usuarios, configuración de tipos de documento y escopos de búsqueda específicos por interfaz.
- Búsqueda empresarial en repositorios internos (Git, docs) con navegación estructural por secciones.
- Análisis de documentos legales o técnicos para extraer cláusulas, fechas, riesgos y configuraciones.
- Integración con Open WebUI vía MCP para asistentes IA que consultan bases de conocimiento privadas.
- Monitorización de ingestión y gestión de múltiples bases de conocimiento (KB) desde una consola centralizada.
- Búsqueda local sin salir del entorno (RAGfind) para evitar fugas de datos a servicios externos.
- Ingestión híbrida robusta con OCR, deduplicación SHA-256 y clasificación automática por tipo de archivo.
- Arquitectura desacoplada entre gestión (Admin) y búsqueda pública (RAGfind) para seguridad y granularidad.
- Soporte nativo para MCP (HTTP/stdio), facilitando integración con ecosistemas LLM actuales.
- Persistencia estructural (sections/chunks) permite navegación dentro de documentos largos, no solo snippets.
- Análisis automático de contenido (extractión de tareas, riesgos, API surfaces) sin prompts externos.
- Dependencia externa de Ollama para embeddings y análisis; si falla, el embedding se marca como 'failed' pero la búsqueda de texto completo sigue funcionando.
- Elasticsearch es opcional; sin él, se pierde parte del potencial híbrido de búsqueda (solo pgvector + fulltext).
- La deduplicación es por hash de contenido, no considera metadatos o versiones temporales automáticamente.
- Actualización manual requerida para cambios mayores (scripts `update.sh`), sin despliegue one-click.
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Requiere 4 núcleos CPU y 8GB RAM mínimo. Configurar `.env` con credenciales Admin (`admin/admin`) y endpoint Ollama. Usar `docker compose up -d`. Para ingestión por directorio, montar volumen en `import-dir/`. Verificar conectividad Ollama antes de producción para evitar colas de embedding pendientes. Backup automático de DB y archivos en `backups/` tras cada actualización.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.