
rag-foundry-universal
Stack RAG especializado en inteligencia de código y documentos con análisis estático mediante tree-sitter, búsqueda vectorial pgvector y generación LLM vía Ollama/LiteLLM. Arquitectura multi-servicio para Python/TypeScript/Rust/Java.
Ficha actualizada 27 sept 2026, 17:39 · upstream 27 sept 2026, 17:19 · release sin release detectada
Qué es rag-foundry-universal
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
rag-foundry-universal es una pila RAG especializada en inteligencia de código y documentos que combina análisis estático con grafos deterministas para responder preguntas sobre implementación, dependencias y estructura de repositorios. Soporta múltiples lenguajes incluyendo Python, TypeScript/JavaScript, Rust y Java, junto con Markdown y documentos subidos.
La arquitectura se basa en microservicios comunicados por HTTP: servicio de ingestión (8001), almacén vectorial (8002), LLM (8003) y orquestador RAG (8004). Utiliza PostgreSQL con pgvector para almacenamiento, tree-sitter para extracción de código, Docling para OCR en PDFs, y Ollama/LiteLLM para inferencia. La interfaz Gradio (7860) permite ingestión y consultas.
El sistema prioriza la trazabilidad de fuentes mediante manifestos de contexto que registran identidades y hashes de texto, diferenciando evidencia encontrada durante recuperación de evidencia retenida en el prompt. Soporta ingestión incremental reutilizando embeddings para archivos sin cambios y recuperación de trabajos interrumpidos.
- Análisis de impacto de cambios en repositorios: identificar qué llamadas o dependientes podrían verse afectados al modificar un símbolo
- Búsqueda semántica en código con grafos deterministas que recuperan evidencia que la búsqueda vectorial sola pasa por alto
- Documentación y comprensión de repositorios desconocidos mediante análisis estructural sin modificar el código fuente
- Recuperación de documentación técnica de implementaciones específicas con trazabilidad a fuentes originales
- Recuperación gráfica recupera evidencia relevante para preguntas que la búsqueda vectorial top-5 no encuentra (9/10 vs 7/10 en baseline)
- Análisis estático multi-lenguaje mediante tree-sitter con representación de grafo compartida
- Trazabilidad completa de fuentes con manifestos de contexto que registran identidades y hashes SHA
- Ingestión incremental reutiliza embeddings para archivos sin cambios, preservando linaje de generación
- Arquitectura desacoplada con orquestador sin acceso directo a base de datos
- No es CPU-friendly: requiere GPU para embeddings y generación o endpoints de inferencia remotos
- Análisis estático no resuelve llamadas de tiempo de ejecución ni dependencias externas completas
- Resultados de impacto describen candidatos, no garantías de ruptura real del código
- Búsqueda gráfica carga repositorio en caché de memoria durante recuperación
- No garantiza persistencia continua de snapshots anteriores durante reconstrucción de base de datos
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
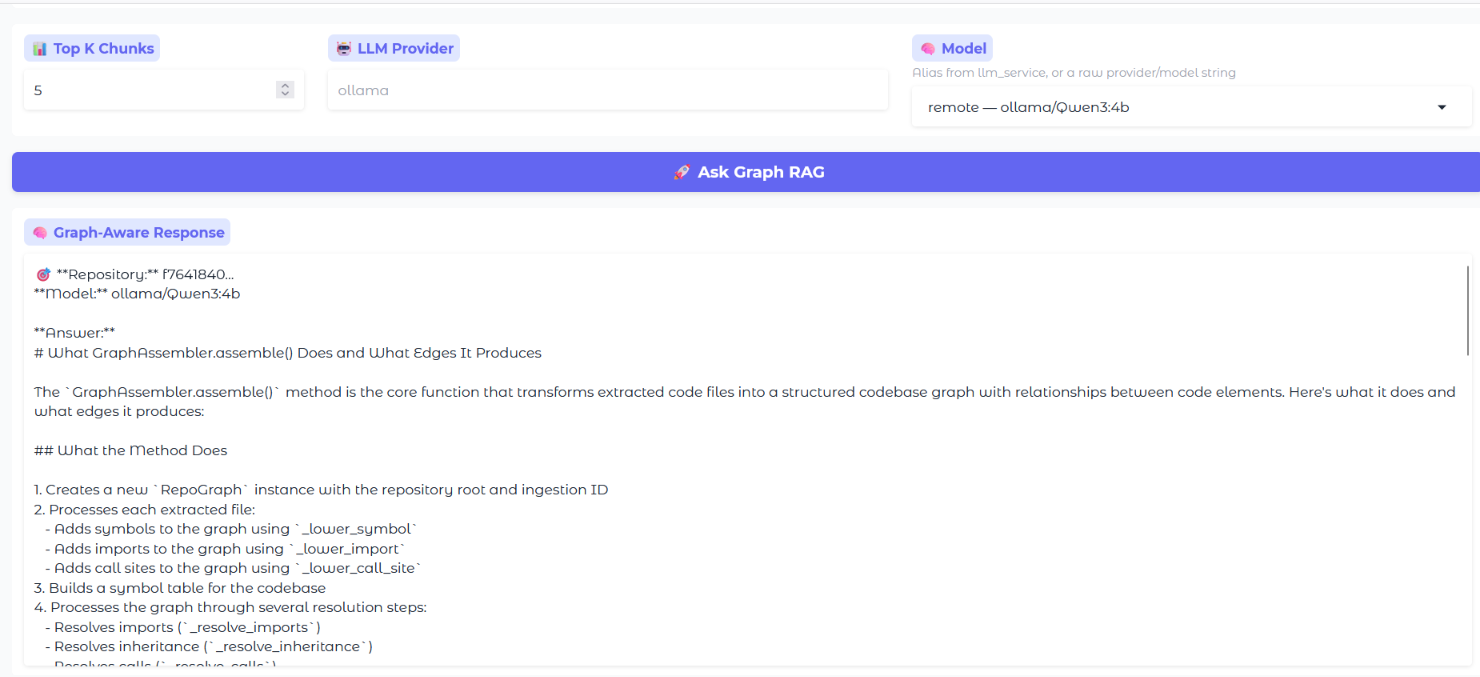
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Requiere Docker Compose, Python 3.12 con uv y capacidad GPU para inferencia. Configurar Ollama local o endpoints remotos en .env. Ejecutar migraciones PostgreSQL antes de iniciar servicios. Verificar salud de PostgreSQL antes de aplicar alembic. Para producción usar imágenes inmutables con revisiones de fuente registradas y pruebas de humo RAG. Consultar DOCS/deployment/production-docker-compose.md para despliegue completo.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.