
AsrServe
AsrServe es un servicio de reconocimiento de voz autoalojado que soporta procesamiento en tiempo real y offline, con modelos SOTA abiertos como Confucius4-R2T2 para transcripción y Nemotron-3-Diarization para identificación de hablantes. Compatible con GPU NVIDIA (vLLM), CPU Linux y Apple Silicon na
Ficha actualizada 27 sept 2026, 9:07 · upstream 27 sept 2026, 8:48 · release v1.0.4
Qué es AsrServe
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
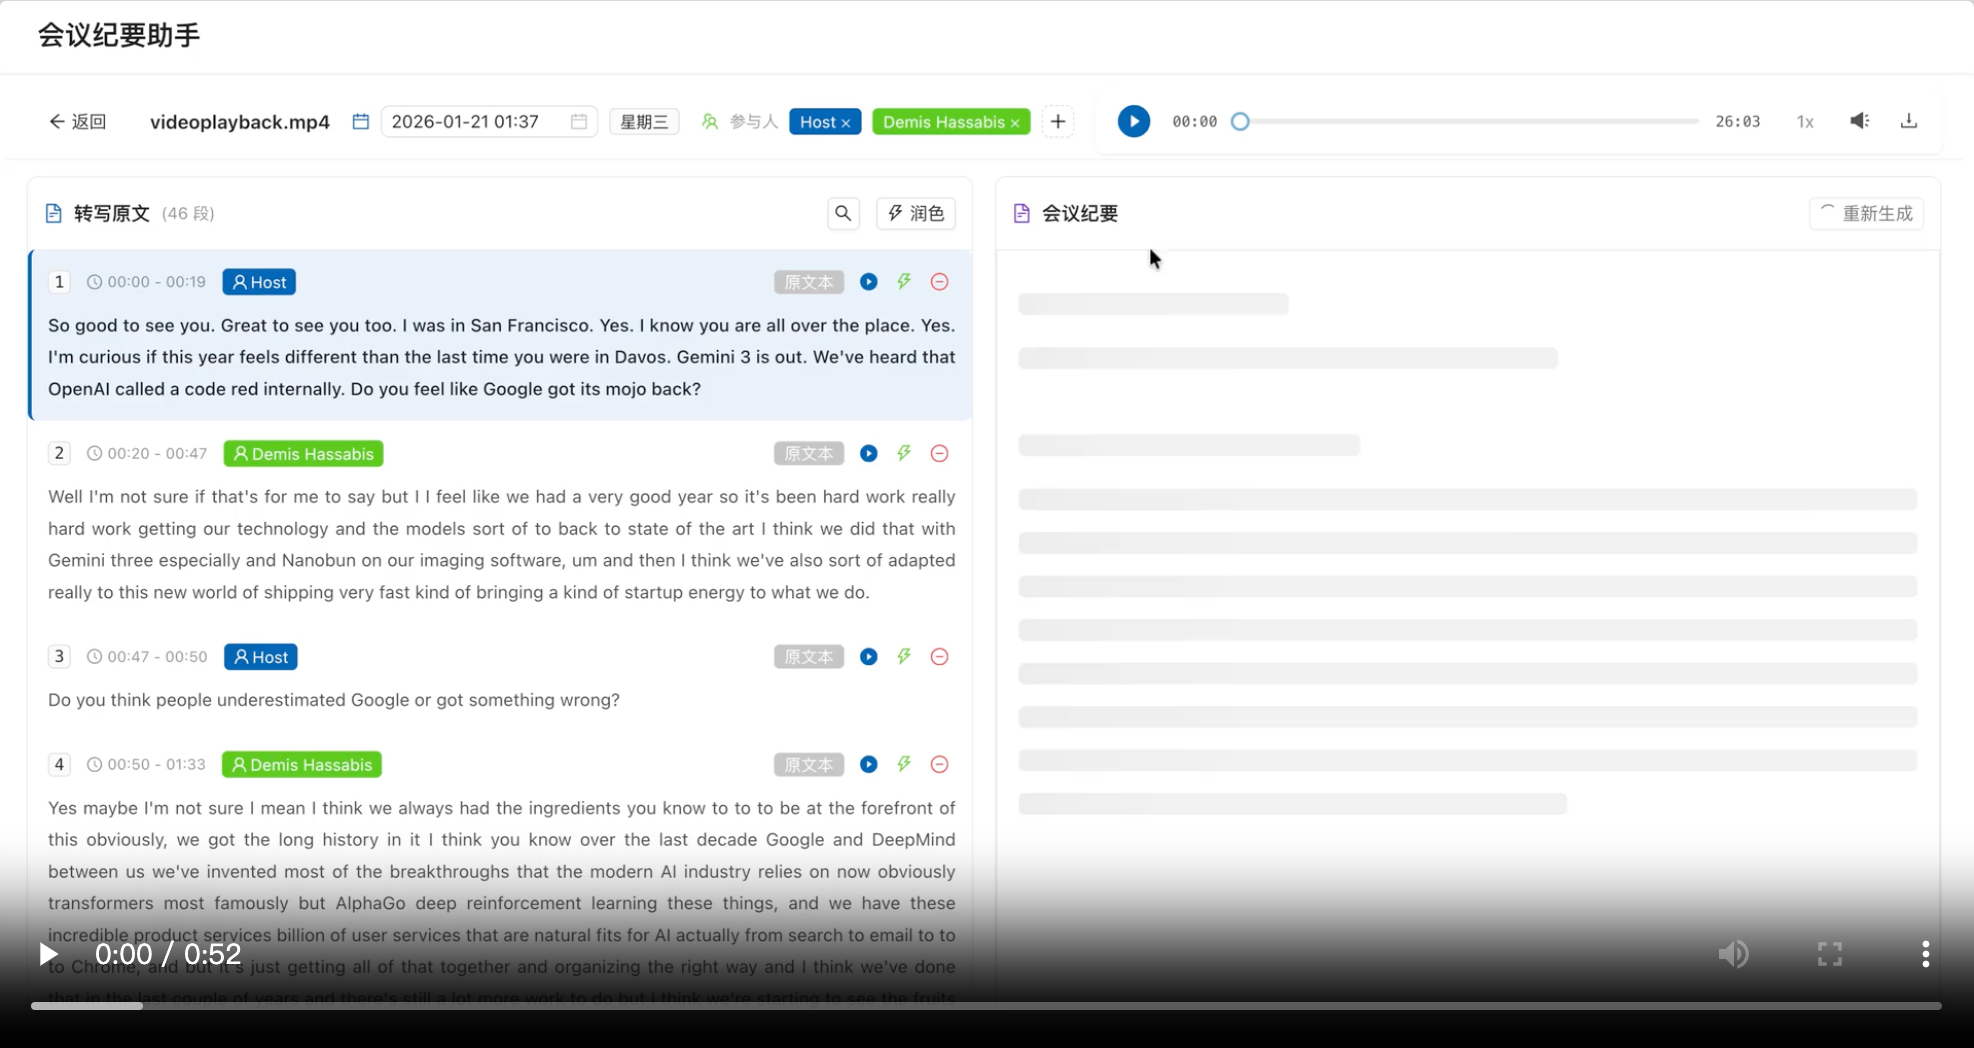
AsrServe es una solución completa de reconocimiento automático del habla (ASR) diseñada para ejecutarse localmente sin depender de servicios en la nube. El proyecto integra modelos de vanguardia como Confucius4-R2T2 para transcripción de audio y Nemotron-3-Diarization para la identificación de oradores, permitiendo hasta ocho hablantes distintos en una sola sesión. La arquitectura soporta tanto inferencia en tiempo real mediante WebSockets como procesamiento offline mediante archivos de audio, compartiendo un único motor R2T2 optimizado para ambos modos.
La plataforma está construida sobre tecnologías modernas y eficientes, utilizando vLLM 0.30 para aceleración CUDA en entornos GPU y un backend nativo en Rust para ejecuciones en CPU o Apple Silicon sin necesidad de Docker. Esto permite una flexibilidad significativa en el despliegue, desde servidores Linux con NVIDIA hasta máquinas Mac M1/M2/M3, manteniendo la calidad del reconocimiento como prioridad principal mediante actualizaciones automáticas del stack de modelos cuando aparecen mejoras en el ecosistema abierto.
El servicio ofrece endpoints compatibles con OpenAI SDK para integración sencilla, documentación detallada sobre protocolos en tiempo real y scripts de benchmarking. Soporta despliegue en contenedores Docker con imágenes optimizadas para GPU, CPU y Ascend 910B, además de ejecuciones nativas en macOS mediante Rust. La gestión de modelos se realiza localmente en directorio ./models con soporte para descarga offline preconfigurada.
- Transcripción automática de reuniones o entrevistas grabadas en formato WAV/MP3 con identificación de oradores
- Streaming en vivo para transcribir conversaciones en tiempo real enviando PCM 16 kHz mono a través de WebSocket
- Integración con aplicaciones existentes mediante API compatible con OpenAI SDK (/v1/audio/transcriptions)
- Despliegue local en entornos con restricciones de privacidad que requieren procesamiento offline sin enviar audio a la nube
- Uso en hardware heterogéneo (NVIDIA GPU, CPU Linux, Apple Silicon) para adaptarse a diferentes infraestructuras
- Soporte nativo multiplataforma: funciona en NVIDIA CUDA, CPU Linux y Apple Silicon sin dependencias externas complejas
- Modelos SOTA actualizados: utiliza Confucius4-R2T2 y Nemotron-3-Diarization con precisión verificada y timestamps de palabras vía Qwen3-ForcedAligner
- API compatible con OpenAI: facilita la integración con herramientas existentes sin reescribir código cliente
- Eficiencia optimizada: comparte pesos R2T2 entre modos online/offline, reduciendo latencia y consumo de recursos
- Interfaz web integrada: incluye página de grabación en /realtime para pruebas rápidas sin configuración adicional
- Requiere descarga inicial de modelos pesados (10 GB mínimo) antes del primer uso, incluso en modo offline
- La versión GPU depende de CUDA 13.0 y vLLM 0.30, lo que puede limitar compatibilidad con drivers antiguos
- No incluye API REST compatible con Alibaba Cloud; solo expone endpoints OpenAI y WebSocket nativo
- Los modelos vienen de Hugging Face con revisiones fijadas, por lo que no se benefician automáticamente de actualizaciones posteriores sin reconfiguración manual
- La versión Ascend 910B requiere rama específica del repositorio y no es compatible con imágenes estándar Docker Hub
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Para producción, utilice docker compose up -d con imagen GPU (quantatrisk/asrserve:gpu) o CPU según hardware. En macOS Apple Silicon, ejecute nativamente sin Docker usando uv sync --frozen && ./scripts/build-rust.sh. Asegúrese de montar el volumen ./models para persistencia y pre-descargue modelos en máquina con red si opera offline. Configure variables de entorno como API_KEY o HF_HUB_OFFLINE=1 según necesidades. El servicio escucha por defecto en puerto 17003; verifique disponibilidad en /health. Para despliegues Ascend, use rama ascend-910b. Evite montar modelos desde directorios externos sin control de permisos para evitar corrupción de pesos.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.