
predastore
PredaStore es una plataforma de almacenamiento de objetos distribuida y compatible con la API Amazon S3, escrita en Go. Diseñada para entornos on-premise y edge, ofrece alta disponibilidad mediante codificación Reed-Solomon, consenso Raft y transporte QUIC. Soporta cifrado en reposo y despliegues au
Ficha actualizada 27 sept 2026, 23:11 · upstream 27 sept 2026, 23:06 · release v1.5.1
Qué es predastore
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
PredaStore es una plataforma de almacenamiento de objetos distribuida implementada en Go, diseñada para operar en entornos on-premise y edge con compatibilidad total con la API Amazon S3. Su arquitectura combina consenso Raft para metadatos, codificación Reed-Solomon para redundancia eficiente y transporte QUIC para baja latencia entre nodos. El sistema soporta cifrado de datos en reposo mediante AES-256 y permite despliegues autónomos o integrados como backend de objetos para el clúster Spinifex.
PredaStore ofrece dos modos de operación principales: Standalone, que utiliza credenciales definidas estáticamente en la configuración TOML sin evaluación de políticas externas, y un modo integrado bajo Spinifex que gestiona identidad (IAM), roles y sesiones temporales a través de NATS JetStream KV. El modo integrado es esencial para entornos multi-inquilino donde se requiere aislamiento estricto entre cuentas y rotación dinámica de claves sin reiniciar el servicio.
El despliegue soporta topologías desde un solo host hasta clústeres distribuidos con transporte QUIC entre máquinas. Requiere gestión manual de certificados TLS y claves maestras (32 bytes AES-256), aunque proporciona scripts para inicialización básica. La instalación en sistemas operativos modernos se realiza mediante systemd, permitiendo integración nativa con el gestor de procesos del servidor.
- Almacenamiento persistente para aplicaciones edge con baja latencia
- Backend de objetos para clústeres Spinifex en entornos multi-inquilino
- Repositorio de datos masivos con redundancia mediante erasure coding
- Sustituto on-premise de S3 para cargas de trabajo críticas
- Almacenamiento de backups cifrados en reposo
- Implementación nativa en Go con compilación FIPS 140-2
- Codificación Reed-Solomon para tolerancia a fallos sin duplicación completa
- Transporte QUIC para optimización de red entre nodos distribuidos
- Compatibilidad API S3 estándar para interoperabilidad con clientes existentes
- Soporte nativo para cifrado AES-256 en reposo con gestión de claves
- Requiere sudo para configurar alias de loopback en perfiles multi-host
- Rotación de claves de cifrado no soportada actualmente (ver Roadmap)
- Modo Standalone carece de evaluación de políticas IAM nativa
- Dependencia de NATS JetStream para el modo integrado con Spinifex
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
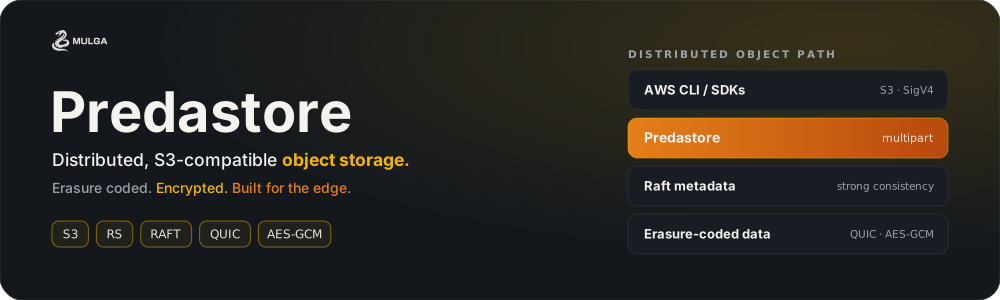
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Generar claves maestras con `openssl rand -out master.key 32` y permisos 0600. Usar `make build` para asegurar enlace FIPS antes de instalar. En clústeres multi-host, ejecutar scripts de configuración con sudo para añadir alias de loopback. Asegurar que el archivo de configuración coincida con los hosts físicos o virtuales definidos.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.