
portage
Portage es un gateway de modelo autocontenido que permite ejecutar modelos OpenAI compatibles, Ollama o vLLM en una sola instancia con un solo binario. Transfiere protocolos entre Claude Code, Codex CLI y otros agentes.
Ficha actualizada 23 sept 2026, 14:37 · upstream 23 sept 2026, 14:21 · release sin release detectada
Qué es portage
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Portage es un servidor de modelo autocontenido que ejecuta cualquier modelo compatible con OpenAI (APIs oficiales, relays compatibles, Ollama o vLLM) a través de una única dirección IP. Funciona mediante traducción de protocolos: Claude Code usa Anthropic Messages, Codex CLI usa OpenAI Responses y la mayoría de modelos solo exponen Chat Completions. Portage traduce entre todos los tres protocolos en el centro y pasa bytes crudos cuando los protocolos ya coinciden.
El sistema soporta streaming (SSE) y llamadas a herramientas en cada ruta. Para un agente, estos no son características sino la base mínima: sin traducción se obtiene una ruta de traducción que no funciona.
- Ejecutar modelos OpenAI compatibles (GPT-4, Llama, etc.) desde Claude Code o Codex CLI
- Ejecutar modelos locales como Ollama o vLLM en un solo binario sin dependencias externas
- Conectar múltiples agentes de IA a través de una única instancia de servidor
- Evitar la necesidad de parchear clientes o crear scripts personalizados por cada modelo
- Soportar transacciones críticas con persistencia de estado y logs detallados
- Un solo binario que ejecuta múltiples protocolos (Anthropic Messages, OpenAI Responses, Chat Completions) sin necesidad de parchear clientes
- No requiere Redis ni dependencias externas: almacenamiento en SQLite local
- Soporta streaming SSE y llamadas a herramientas en cada ruta de traducción
- Permite cambiar modelos sin tocar los clientes existentes mediante un solo archivo de configuración
- Credenciales de upstream se guardan en una sola ubicación (pool) y nunca aparecen en logs ni errores
- No soporta compaction de contexto para Codex CLI sin configurar manualmente el modelo
- La ruta de traducción no es bidireccional: solo funciona cuando el upstream entiende el protocolo original
- El almacenamiento local (SQLite) puede crecer con datos acumulados a largo plazo
- No tiene un sistema de escalado automático ni auto-reescalado
- Depende de la disponibilidad del servidor para mantener las conexiones abiertas
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
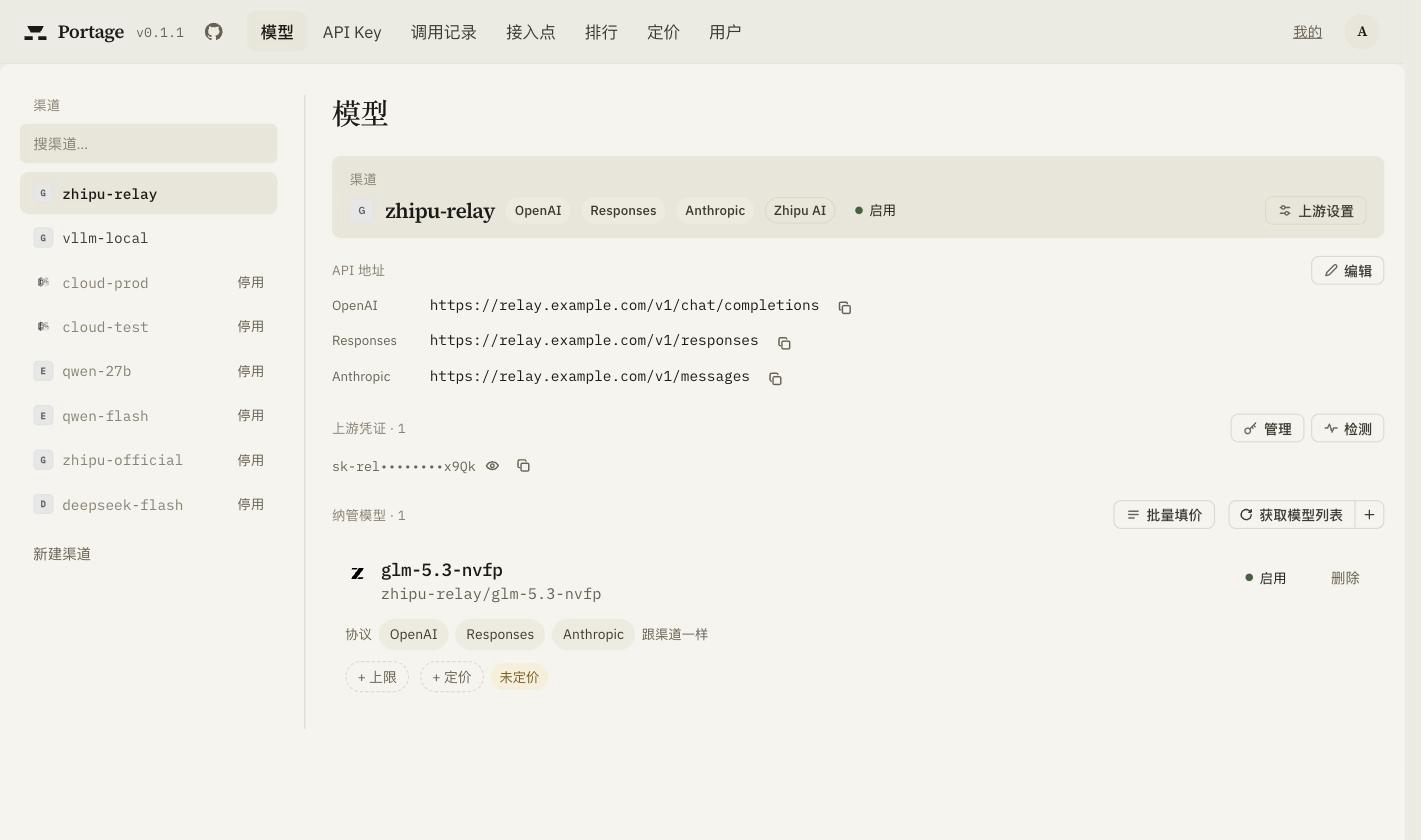
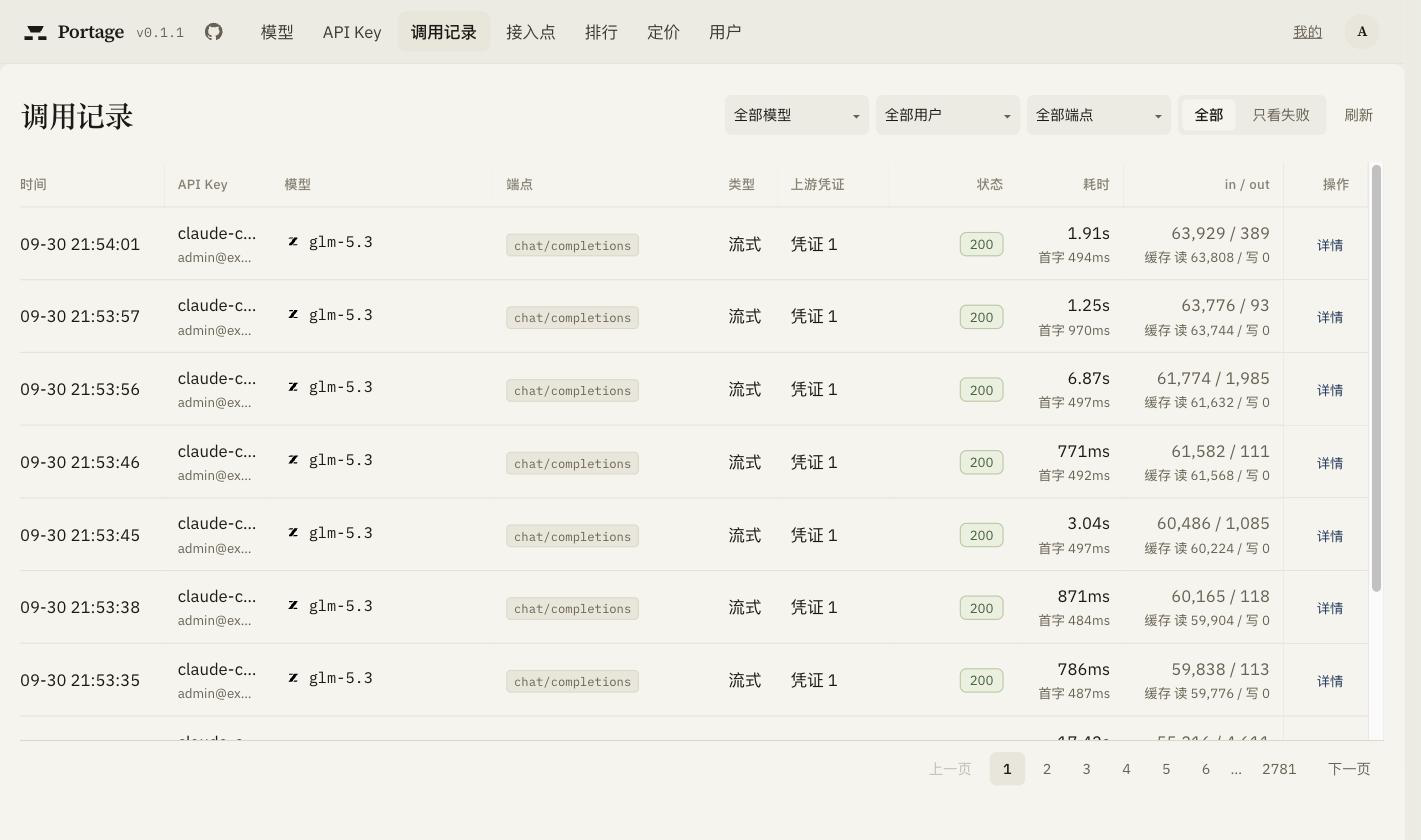
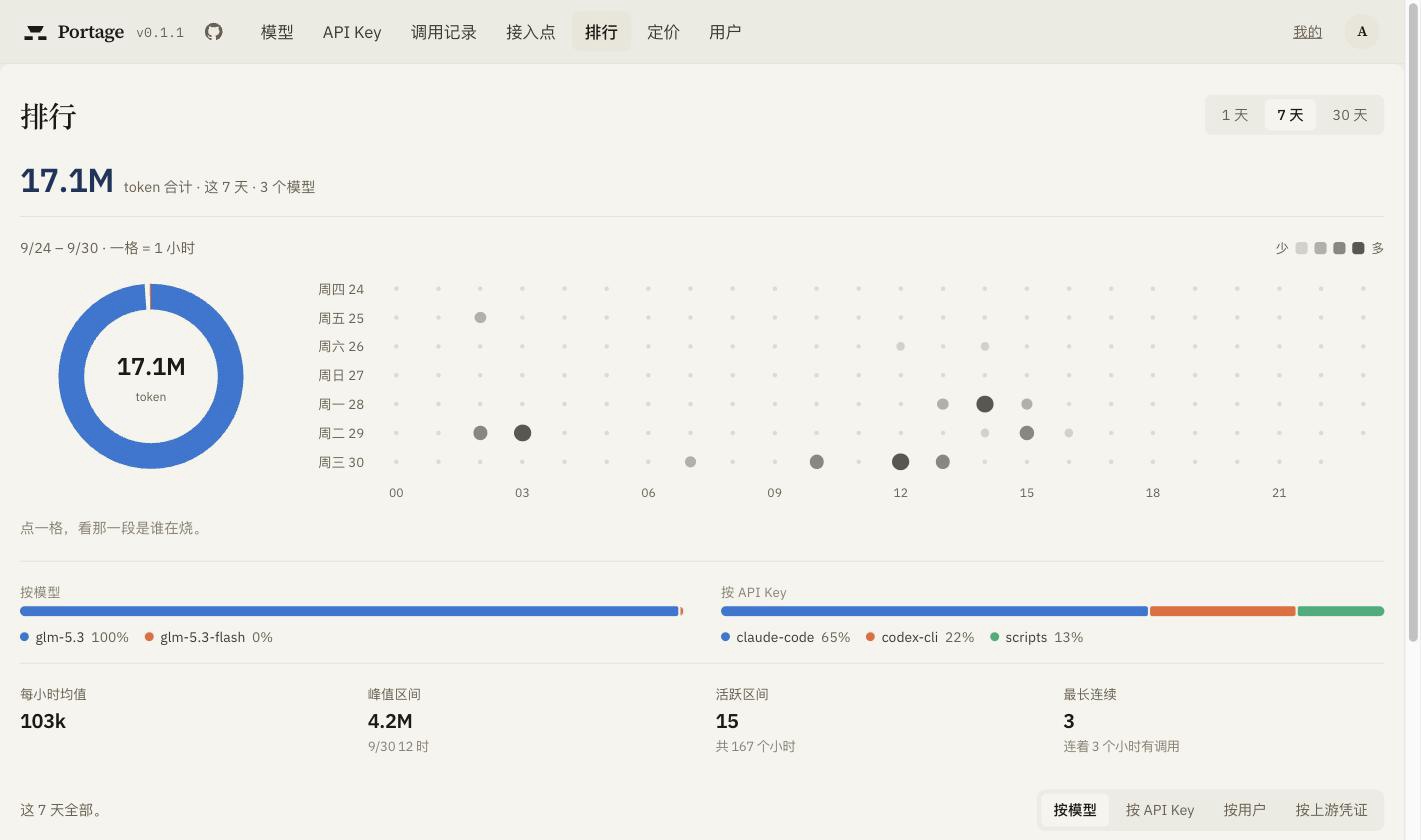
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Configura el binario con docker compose, usa un archivo channels.yaml para definir modelos y credenciales, y despliega en modo forwarding (sin admin password). Para producción, considera replicar el binario en múltiples nodos, configurar rate limiting en config.yaml y monitoreo de logs. El modelo de despliegue es simple: una imagen desde GHCR con docker-compose.forward.yml como punto único de configuración.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.