
pinard
Plataforma de orquestación para agentes de IA autónomos que transforma issues en solicitudes de fusión (MRs). Utiliza una jerarquía conductor/trabajador, mensajería durable con NATS y memoria persistente para permitir bucles semi-deterministas reanudables.
Ficha actualizada 24 sept 2026, 17:44 · upstream 24 sept 2026, 17:12 · release v0.70.1
Qué es pinard
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
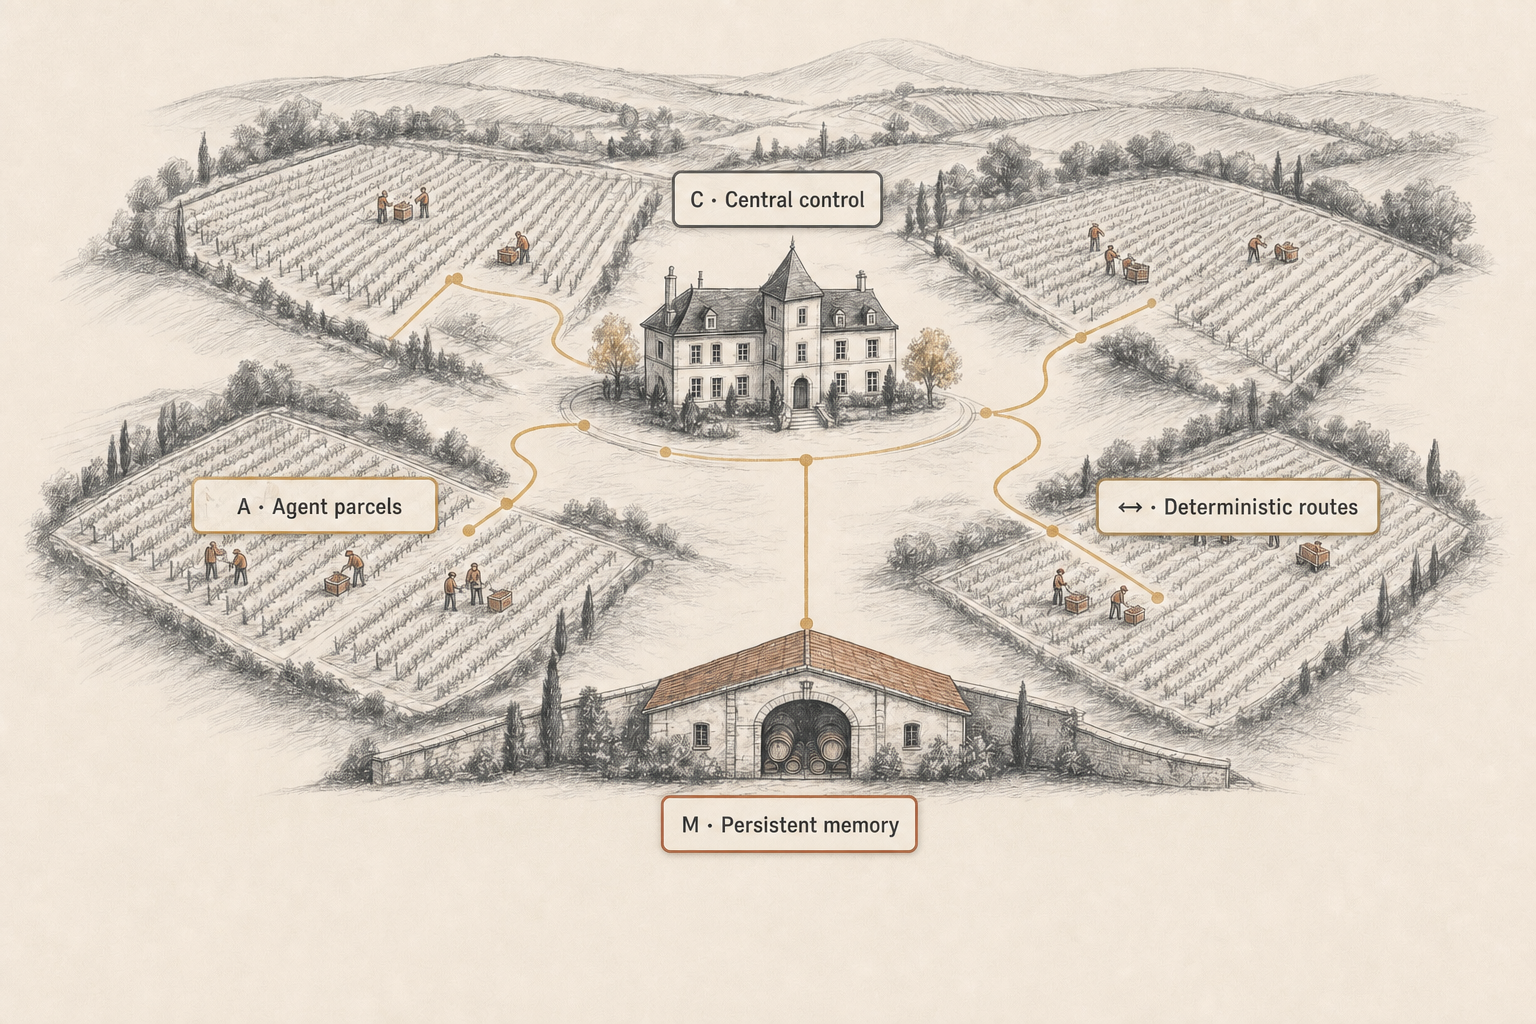
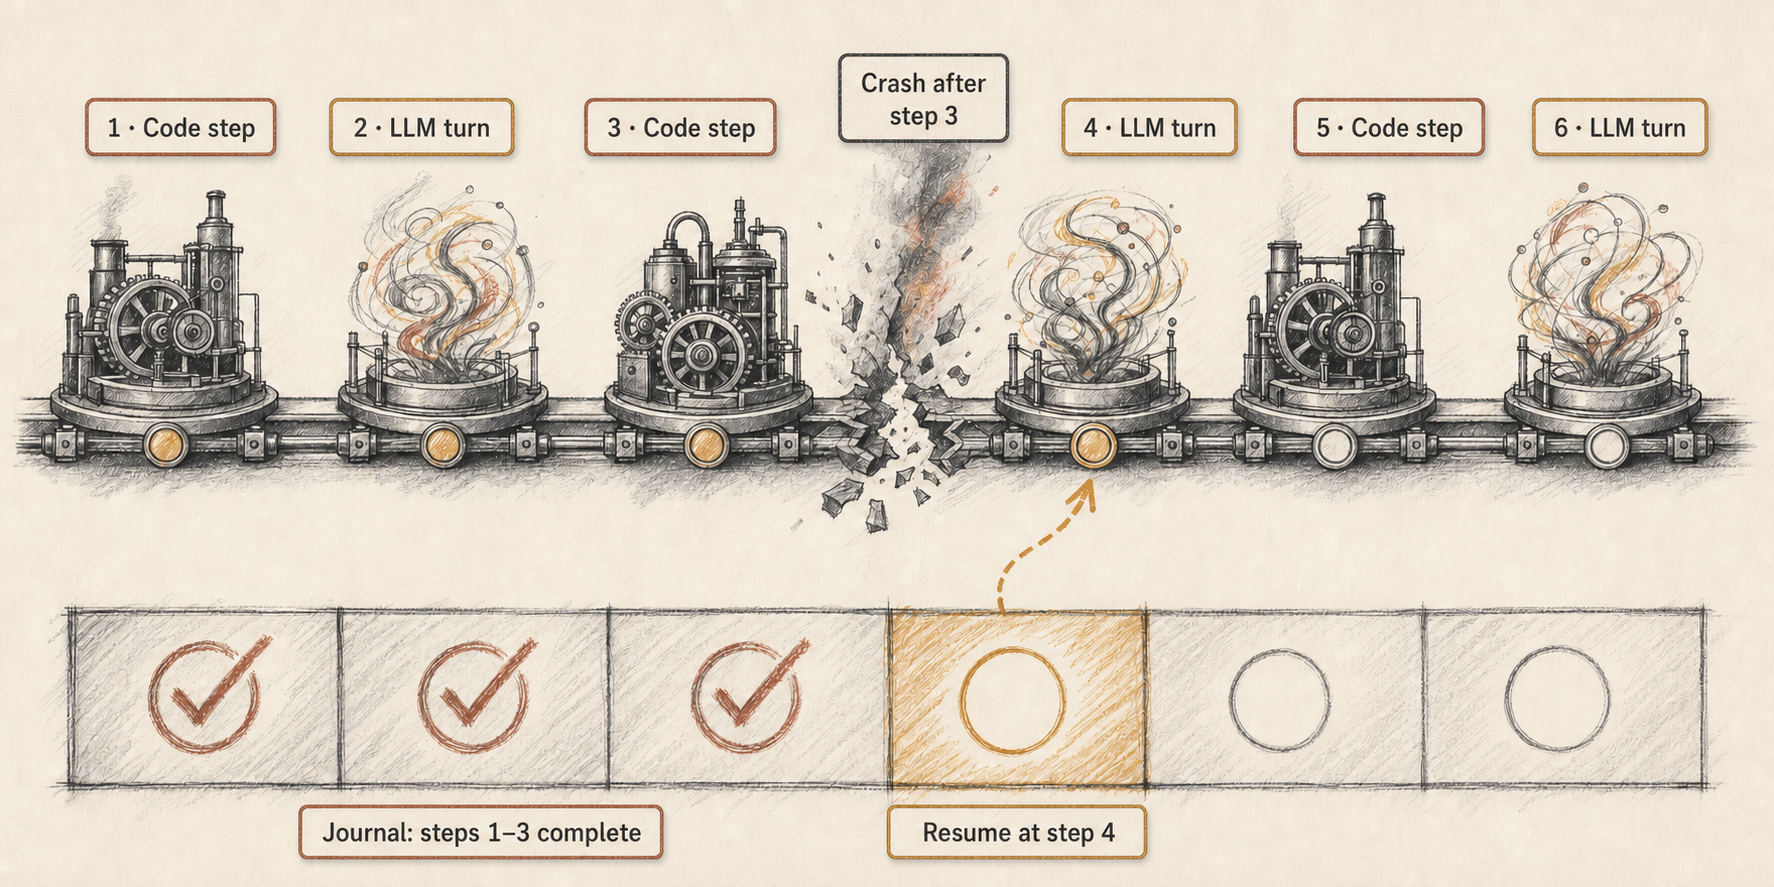
Pinard es una plataforma de orquestación diseñada para gestionar flotas de agentes de LLM mediante bucles semi-deterministas fiables. El sistema separa el flujo de control (código) del juicio del modelo, permitiendo que la IA opere dentro de límites definidos por scripts versionados en JavaScript. Cada paso se registra en un diario (journal), lo que permite reanudar trabajos interrumpidos sin reiniciar desde cero, garantizando la auditoría y la resiliencia ante fallos.
- Automatización del ciclo de vida SWE: convertir issues de GitLab en solicitudes de fusión revisadas con seguimiento de pipelines.
- Mantenimiento recurrente y auditoría: ejecución de tareas programadas (cron) para limpieza o análisis de código distribuido.
- Ejecución en entornos HPC: despliegue de trabajadores en nodos Singularity o clústers sin necesidad de SSH entrante.
- Observabilidad remota: supervisión de sesiones tmux y progreso de agentes a través de una terminal web segura.
- Reanudación tras fallos: los bucles guardan estado en un journal persistente, permitiendo continuar tras interrupciones o reinicios.
- Control determinista: el flujo principal es código versionado, mientras que la IA aporta juicio limitado dentro de pasos específicos.
- Memoria persistente local-first: conocimiento curado almacenado localmente y replicado con esfuerzo mínimo al cloud.
- Observabilidad sin SSH: acceso a terminales remotos (tmux) vía NATS desde un navegador web en modo solo lectura por defecto.
- Requisitos de entorno estrictos: requiere Go, Node.js ≥22.19.0 y herramientas específicas como Pi, glab y fzf para instalación desde fuente.
- Gestión manual de credenciales: no incluye hosts ni credenciales integradas; se debe configurar manualmente tokens GitLab y NATS.
- Dependencia externa de Engram: el backend de memoria (engram) es un binario de terceros que debe instalarse o montarse aparte en ciertos despliegues.
- Auto-merge desactivado por defecto: la fusión automática requiere configuración explícita y condiciones estrictas (pipeline verde, aprobaciones).
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Para despliegue en contenedores, usar la imagen ghcr.io/genentech/pinard para trabajadores o régisseurs, y ghcr.io/genentech/pinard-backend para servicios web. Instalar Engram manualmente si no está incluido en la imagen del worker. Configurar secretos (tokens GitLab, NATS) mediante variables de entorno antes de iniciar el daemon. Asegurar compatibilidad con Linux y verificar versiones de Go/Node.js.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.