
PaperCortex
PaperCortex es una capa de inteligencia artificial para Paperless-ngx que añade búsqueda semántica, extracción automática de datos de recibos y exportación DATEV. Funciona 100% local vía Ollama con UI web bilingüe y protocolo MCP.
Ficha actualizada 24 sept 2026, 5:31 · upstream 24 sept 2026, 5:25 · release sin release detectada
Qué es PaperCortex
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
PaperCortex transforma el repositorio documental de Paperless-ngx en una base de conocimiento inteligente mediante inteligencia artificial ejecutada completamente en tu hardware local. La herramienta añade capacidades que Paperless-ngx no posee nativamente: búsqueda semántica por significado (no solo palabras clave), clasificación automática de documentos, extracción estructurada de datos de recibos y exportación directa a DATEV para contabilidad alemana.
El sistema genera embeddings vectoriales usando modelos locales Ollama como nomic-embed-text o mxbai-embed-large, almacenando los vectores en SQLite. Cada documento nuevo se procesa asíncronamente con LLM local para asignar tipo documental, etiquetas contextuales, correspondiente y detectar idioma. Los recibos se analizan para extraer proveedor, fecha, montantes brutos/netos, tipos de IVA y partidas individuales.
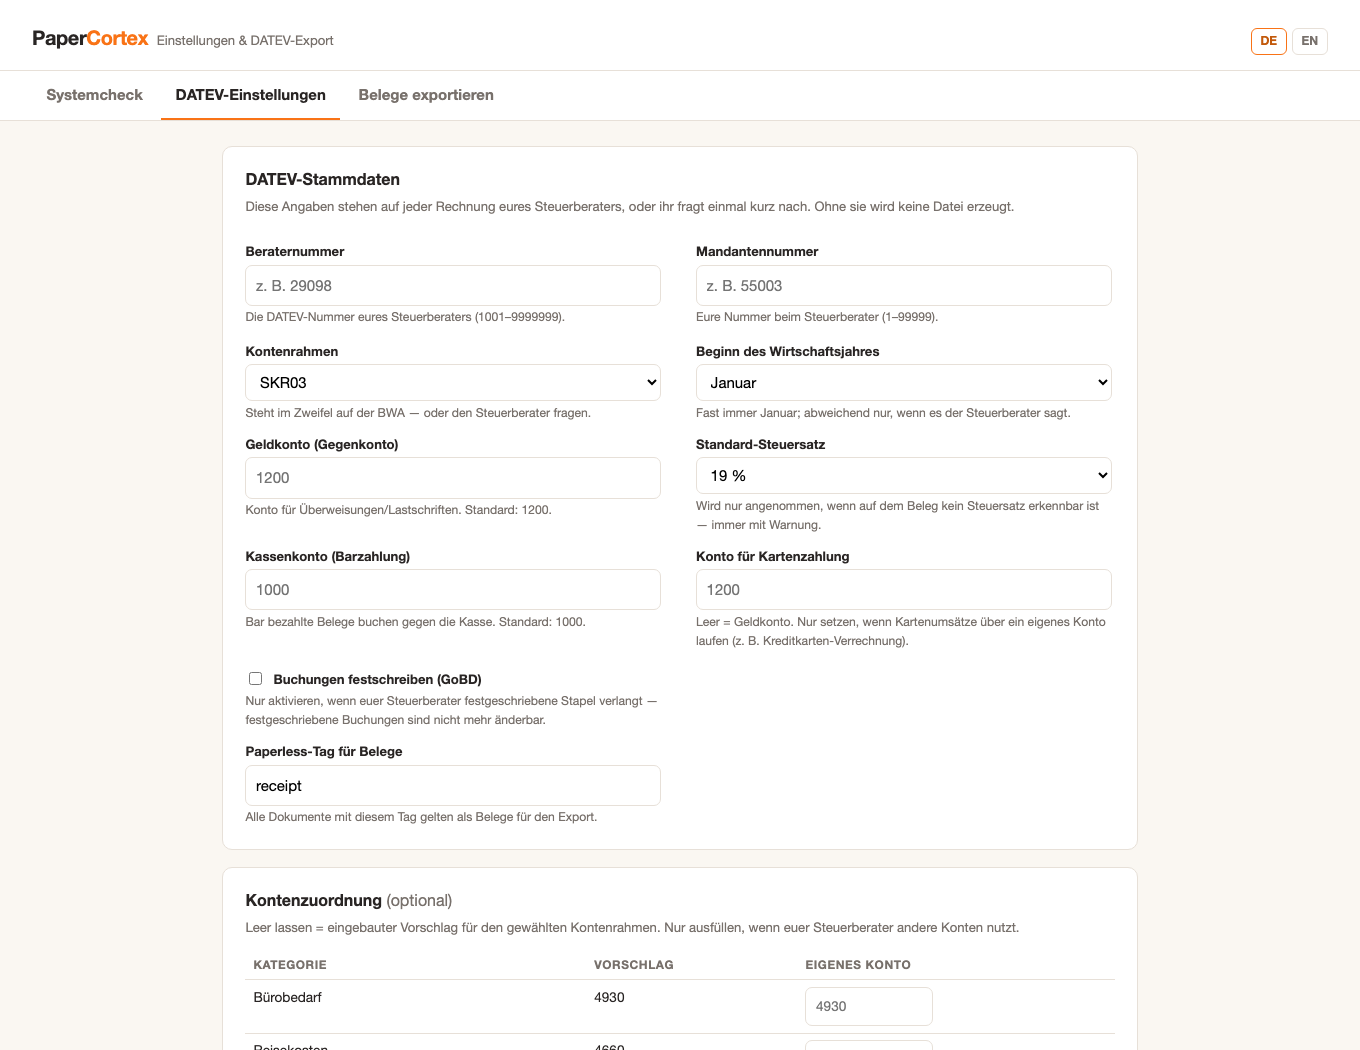
PaperCortex implementa el Model Context Protocol (MCP) como servidor, permitiendo que agentes AI compatibles como Claude Code accedan al repositorio documental como fuente de conocimiento. Incluye interfaz web bilingüe (alemán/inglés) para diagnóstico del sistema, validación de datos maestra DATEV y flujo de exportación paso a paso. La herramienta soporta coincidencia con extractos bancarios mediante fuzzy matching en monto, fecha y nombre de proveedor.
- Búsqueda semántica multilingüe: encontrar documentos por concepto (ej. 'electricity bill' encuentra 'Stromrechnung')
- Extracción automática de datos de recibos: proveedor, fecha, montantes, IVA y partidas para gestión de gastos
- Exportación DATEV: generar archivos EXTF_Buchungsstapel compatibles con DATEV Rechnungswesen sin intervención manual
- Coincidencia con extractos bancarios: emparejar transacciones bancarias con recibos mediante fuzzy matching
- Consultas en lenguaje natural: preguntar '¿cuánto gasté en hoteles Q1 2025?' y obtener respuesta con referencias documentales
- 100% local sin APIs de nube: todos los datos permanecen en tu red, sin suscripciones ni recolección de datos
- Protocolo MCP nativo: compatible con Claude Code, Claude Desktop y cualquier agente AI que soporte MCP
- Exportación DATEV validada: genera archivos EXTF con formato Buchungsstapel v13, CP1252, listo para importación en DATEV
- Búsqueda semántica por embeddings: entiende sinónimos y traducciones (inglés/alemán/español/francés)
- Clasificación asíncrona automática: tipo documental, etiquetas, correspondiente y fecha extraídos al procesarse
- Requiere Paperless-ngx instalado previamente como backend de almacenamiento y OCR
- Dependencia de Ollama local: necesita instalación previa del servidor AI en el mismo entorno
- Exporto DATEV requiere configuración específica (SKR03/SKR04, validación de datos maestra)
- Complejidad media: 4 núcleos CPU y 8GB RAM mínimo recomendados para funcionamiento estable
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.


Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Despliegue recomendado con Docker Compose. Puertos necesarios: 8000 (servicio), 11434 (Ollama), 8140 (UI web), 3100 (MCP). Variables de entorno para configuración de modelos Ollama y conexión Paperless-ngx. Para UnRaid usar Community Apps template disponible en docs/unraid/README.md. Ejecutar npm run datev:init una vez para configurar datos maestra antes del primer exporto.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.