
Ookami
Ookami es una infraestructura open-source de IA que unifica gateways, fine-tuning y evaluación en un solo paquete auto-alojado. Soporta modelos locales (vLLM, MLX, llama.cpp) y API, con autenticación por defecto, gestión de costes y consola web.
Ficha actualizada 25 sept 2026, 6:49 · upstream 25 sept 2026, 6:43 · release v0.3.0
Qué es Ookami
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Ookami es una plataforma open-source para infraestructura de IA que simplifica el despliegue de modelos abiertos y API mediante un único gateway seguro. Permite fine-tuning con LoRA en hardware Apple silicon (MLX) o NVIDIA (TRL), gestión de costes por clave/equipo, y promoción automática de versiones solo cuando superan evaluaciones propias.
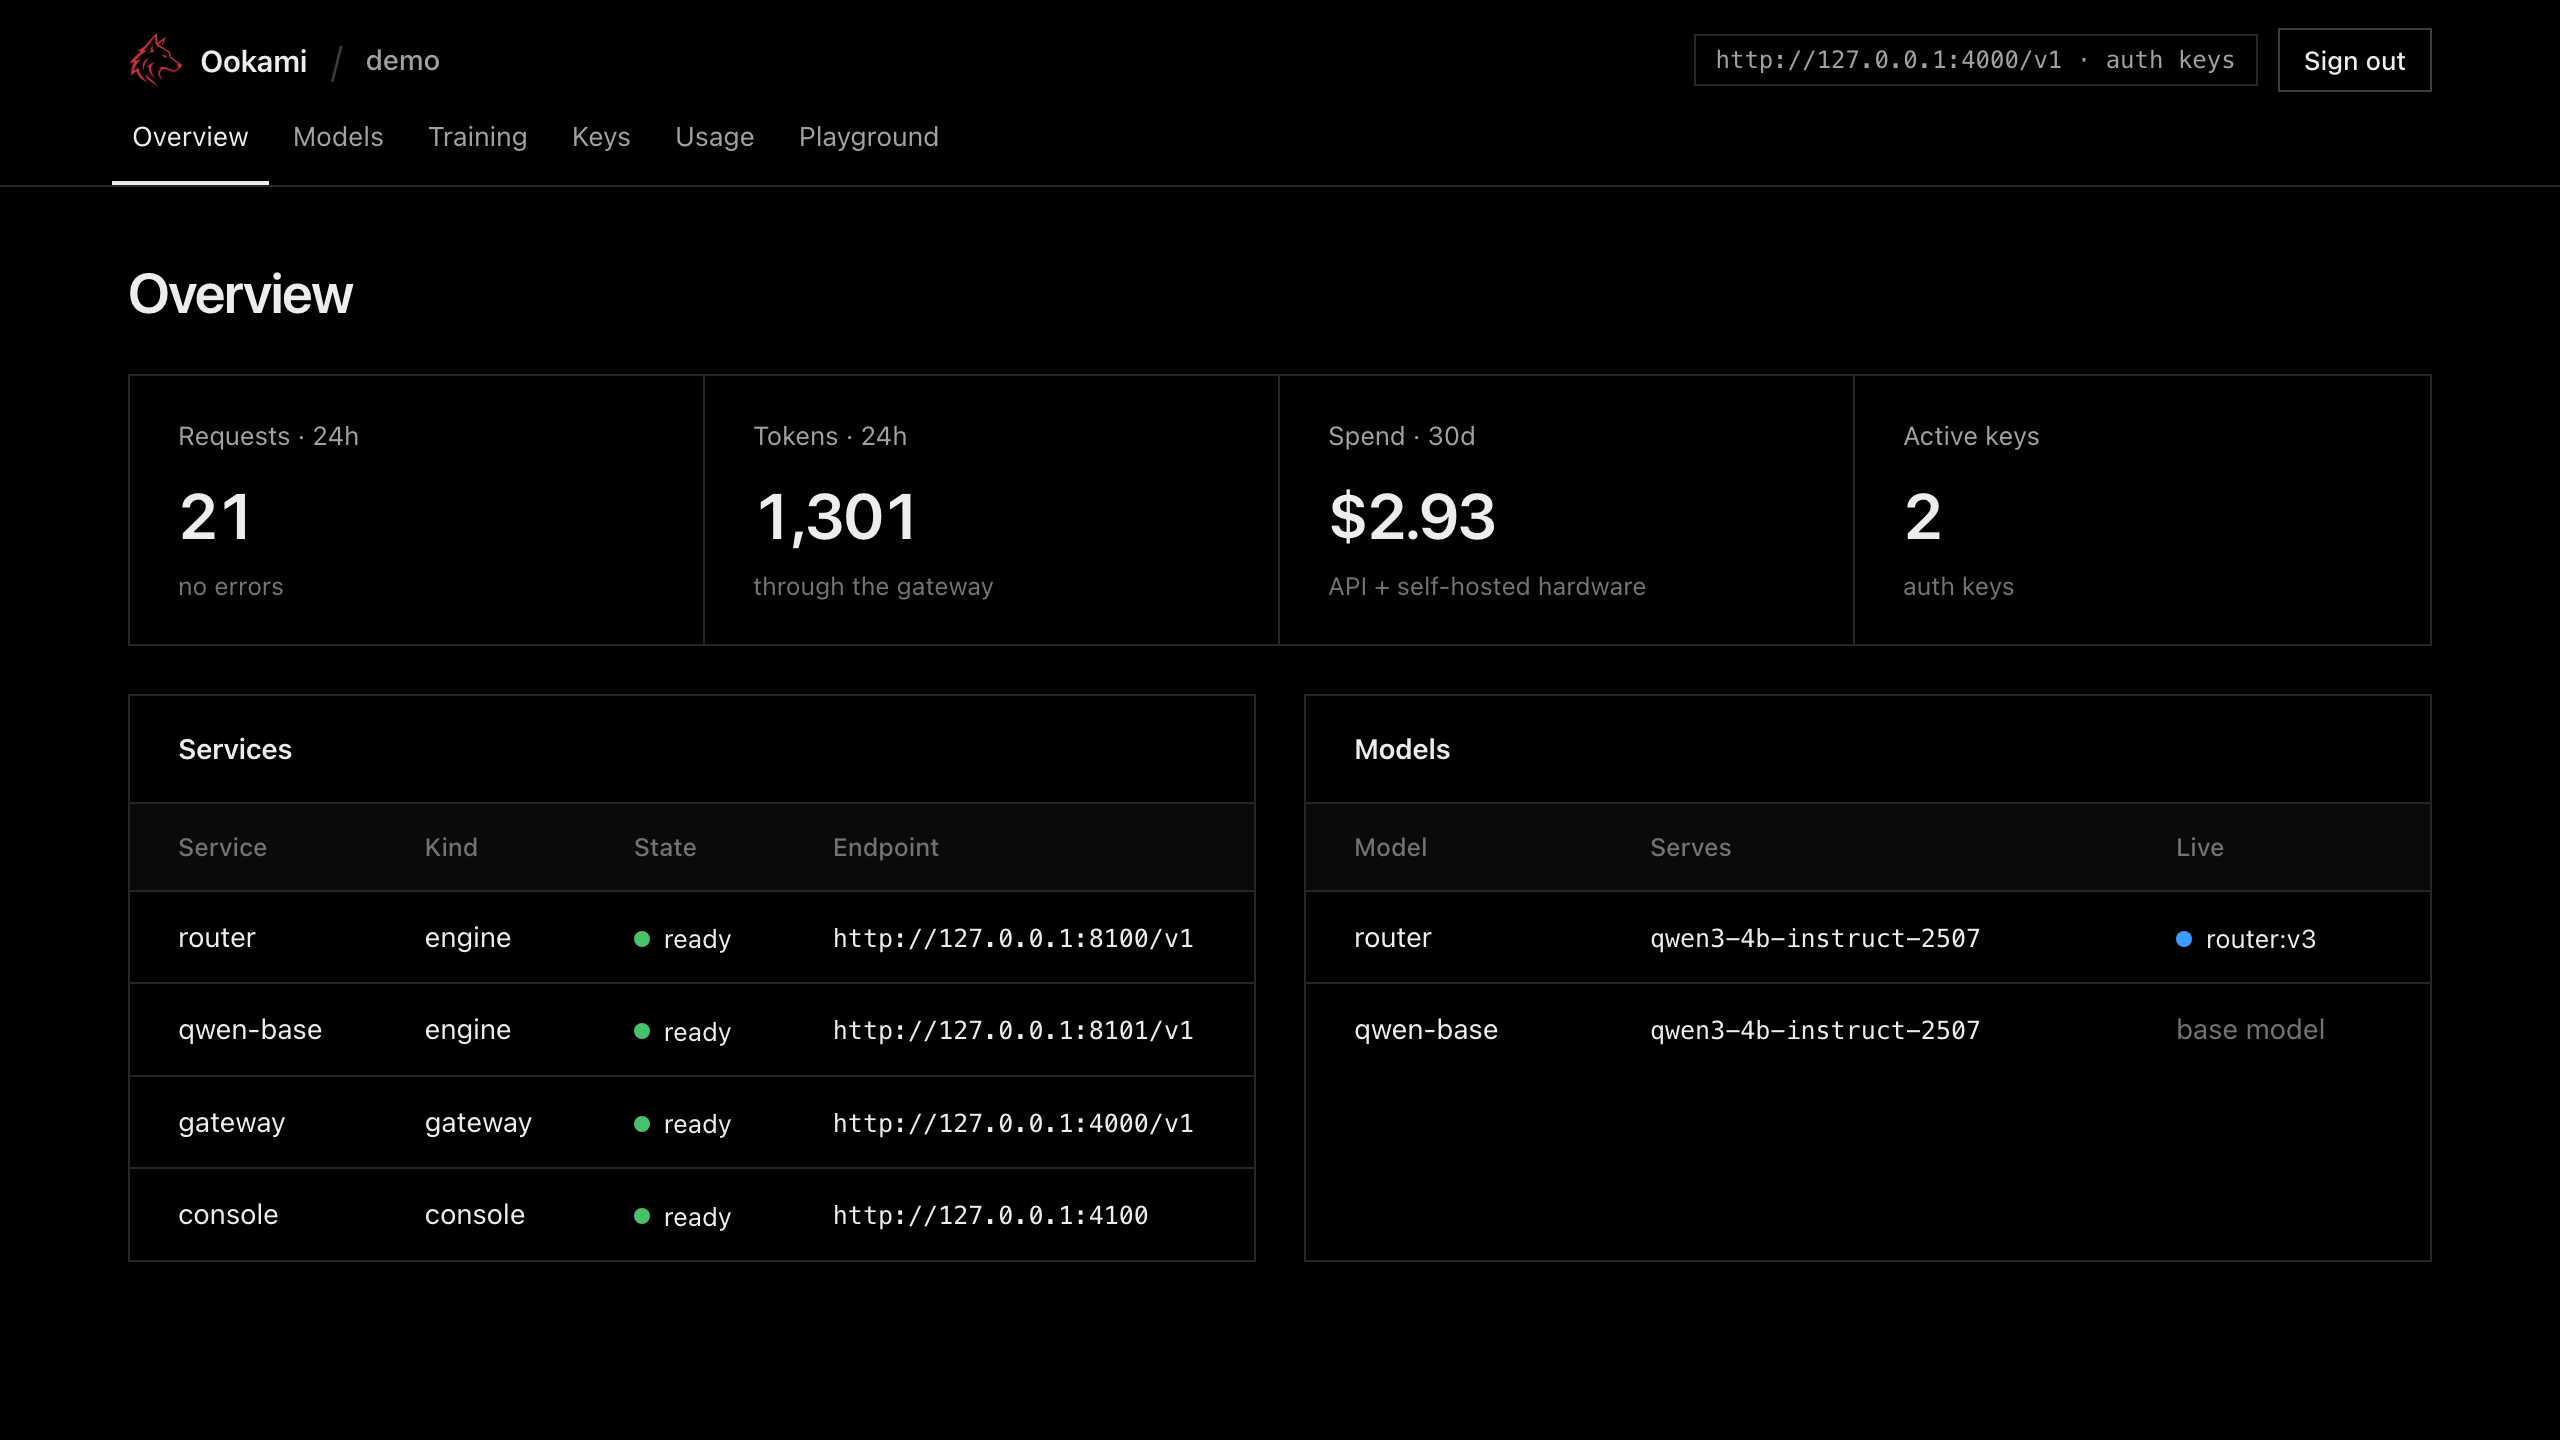
La arquitectura incluye un gateway compatible con OpenAI que soporta autenticación, límites de tasa y presupuestos por clave. El sistema captura trazas mediante Trajectory para entrenar en episodios exitosos. Incluye consola web construida con Python estándar (sin build step) para gestionar modelos, versiones, jobs de entrenamiento y costes.
El despliegue es un solo archivo de configuración (ookami.yaml) adaptado al hardware: Apple silicon usa MLX, NVIDIA usa vLLM, CPU usa llama.cpp. La versión actual es alpha (v0.3), con roadmap hacia Kubernetes, RL (GRPO) y optimización de GPU.
- Unificar modelos locales y API bajo un único endpoint seguro con autenticación por defecto
- Fine-tuning de modelos con LoRA en hardware Apple silicon o NVIDIA con planificación de memoria automática
- Evaluación gated para promover versiones solo cuando superan métricas propias (labels, Python, lm-eval)
- Gestión de costes comparando gastos API vs GPU propia por millón de tokens
- Gateway unificado con autenticación, límites de tasa y presupuestos por clave activados por defecto
- Fine-tuning con LoRA en Apple silicon (MLX) o NVIDIA (TRL) con planificación de memoria y checkpoints
- Evaluación gated contra modelo incumbent con estadísticas bootstrap y rechazo automático de versiones deficientes
- Captura de trazas vía Trajectory para entrenar en episodios exitosos y cerrar el loop de mejora
- Versión alpha (v0.3) sin soporte oficial de Kubernetes (roadmap v0.5)
- Requiere instalación manual de llama.cpp en hardware CPU-only
- Evaluación gated actualmente manual o vía scripts externos (Python, lm-eval, webhook)
- Sin Dockerfile ni compose; despliegue mediante instalador shell o pip
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Usar `ookami init` para generar `ookami.yaml` adaptado al hardware. Ejecutar `ookami up` para iniciar gateway + modelo (+ console si enabled). Configurar `OOKAMI_API_KEY` con `ookami keys master`. Para CPU-only, instalar llama.cpp manualmente (`brew install llama.cpp`). Verificar logs en docs/verification.md.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.