
newsku
Lector RSS auto-alojado que emplea modelos de lenguaje grandes para clasificar y priorizar artículos según preferencias del usuario, disponible con aplicación móvil.
Ficha actualizada 27 sept 2026, 4:33 · upstream 27 sept 2026, 4:22 · release 1.3.3
Qué es newsku
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Newsku es una solución de lectura de noticias auto-alojada diseñada para filtrar el ruido informativo. Utiliza inteligencia artificial mediante LLMs para ordenar los feeds por relevancia personal, permitiendo al usuario centrarse en lo importante sin perder tiempo en contenido irrelevante.
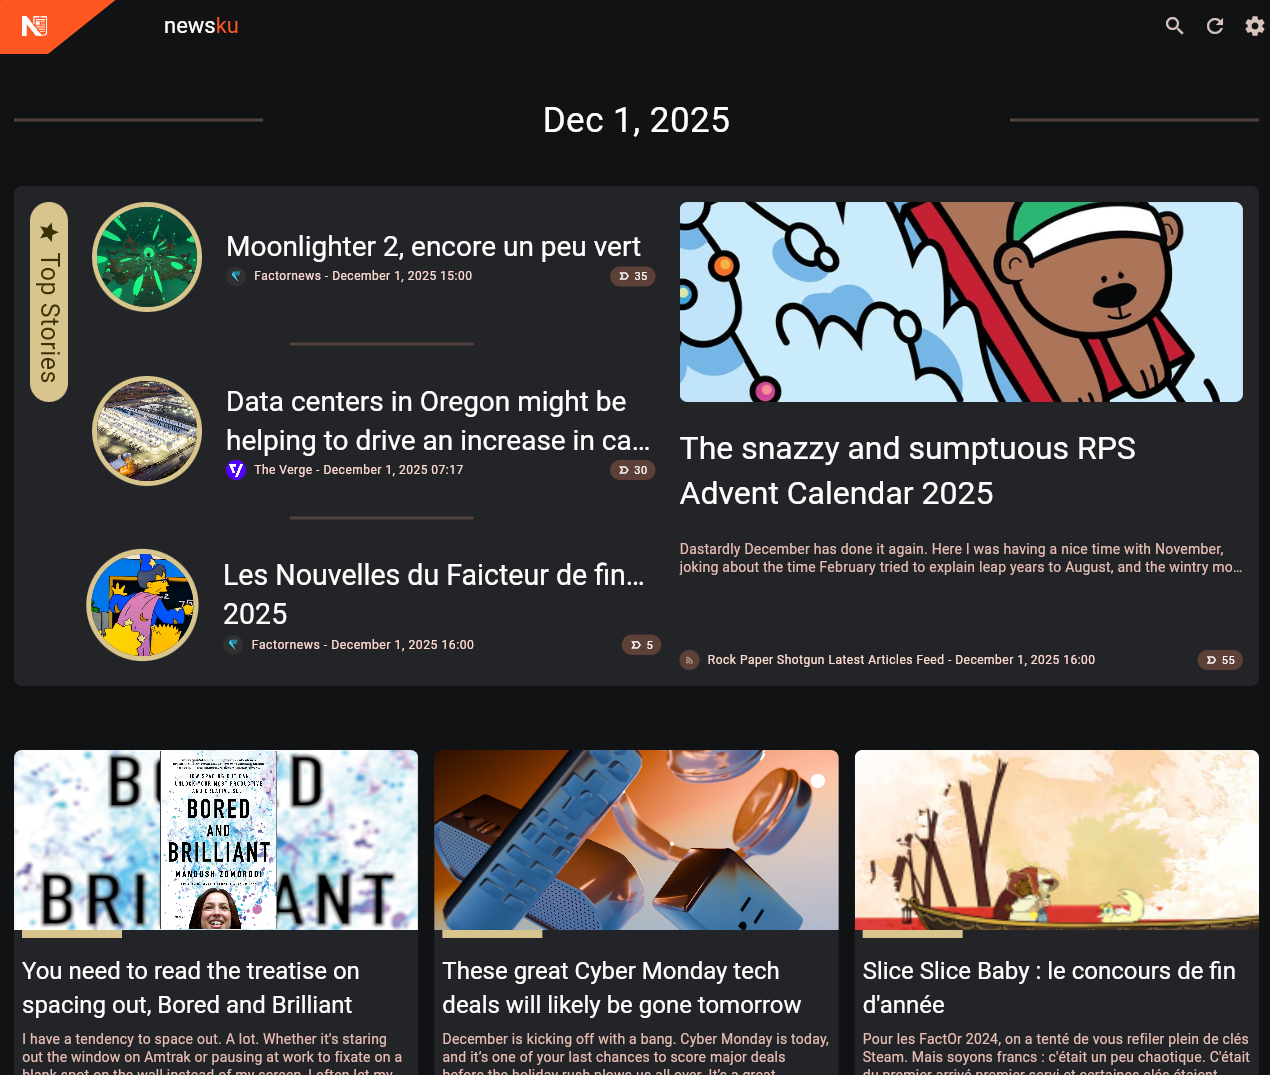
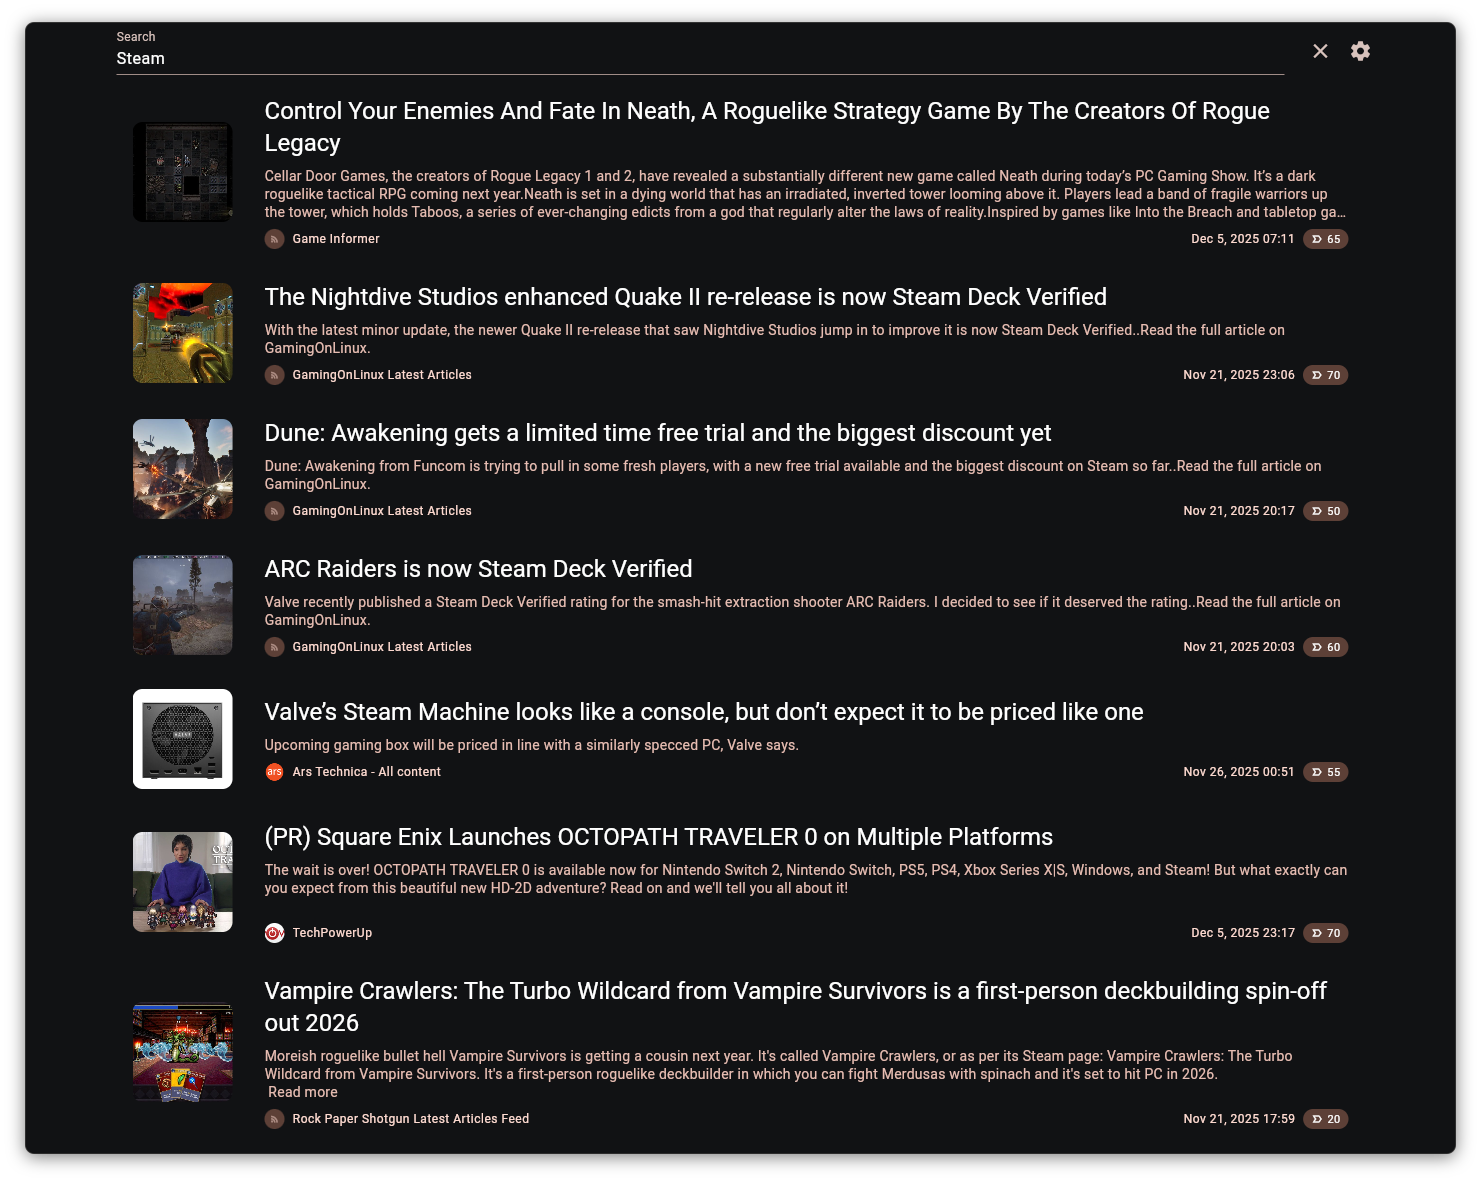
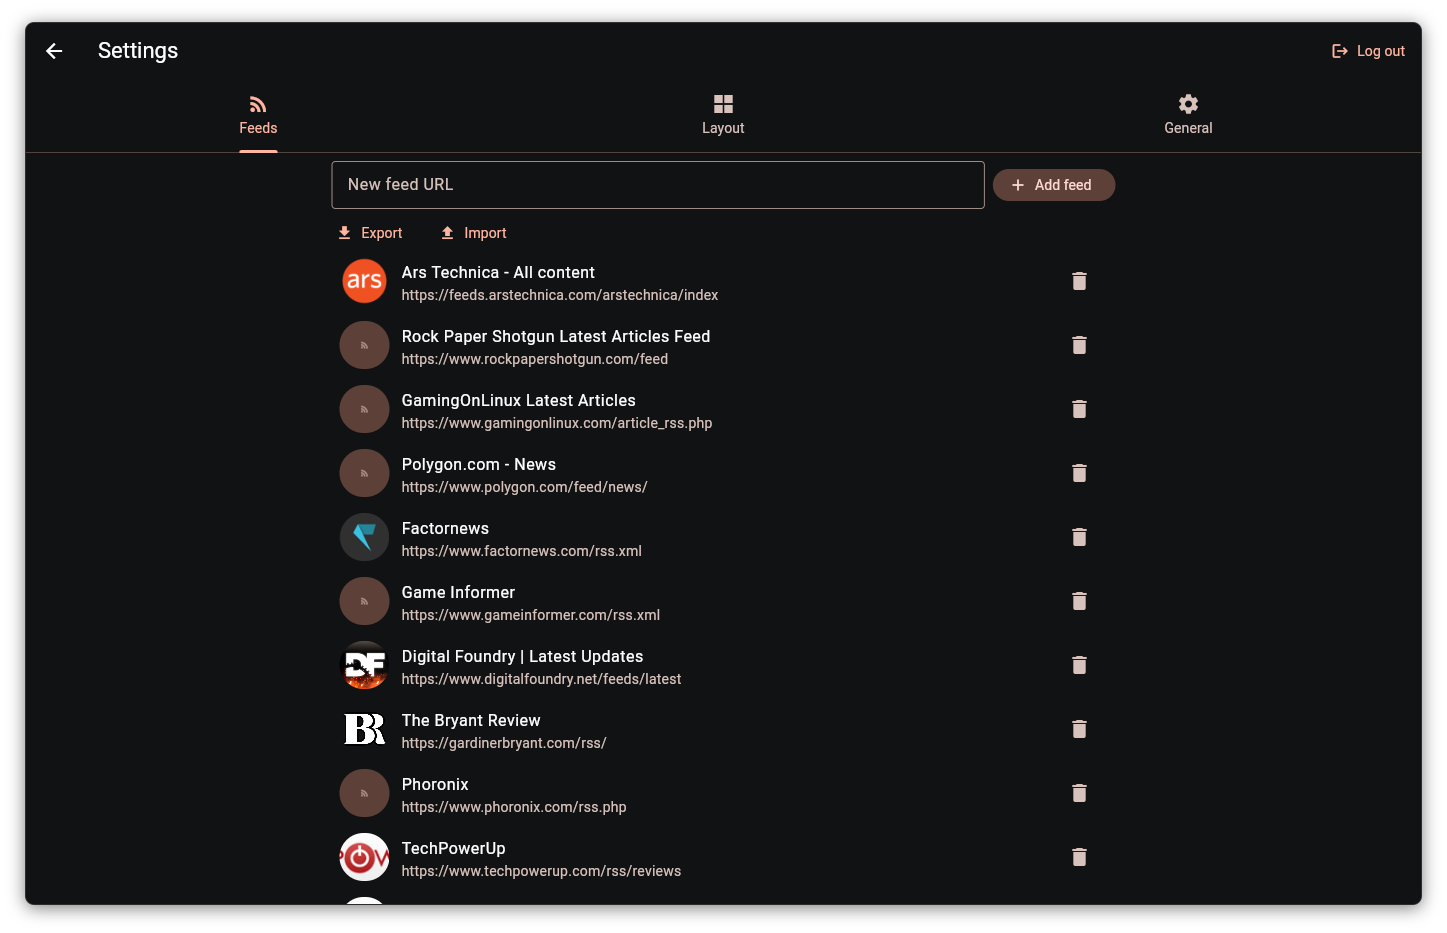
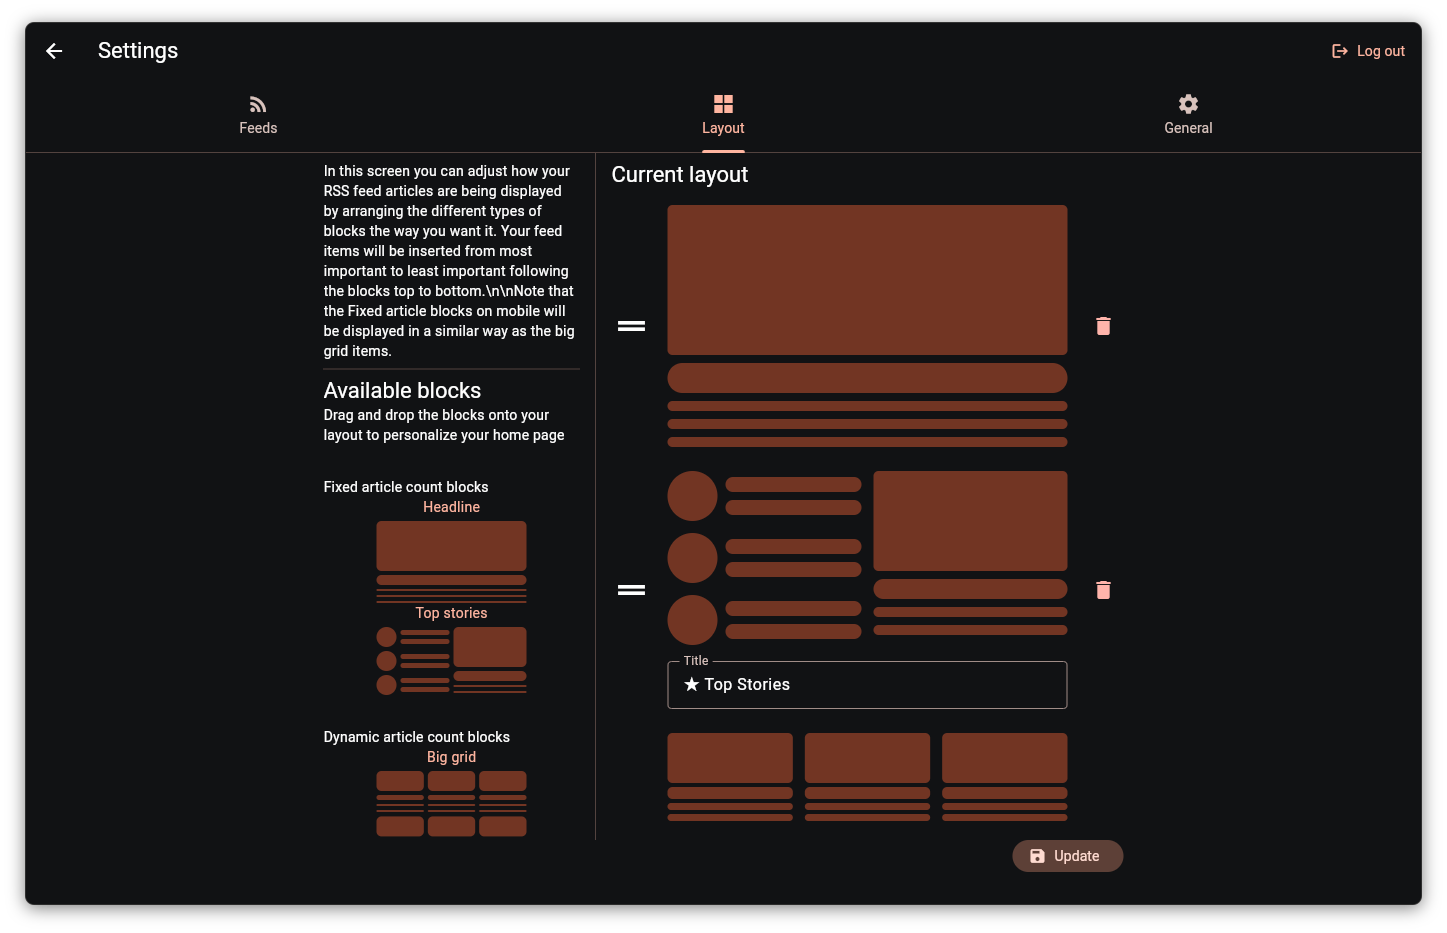
El sistema se integra con dispositivos móviles a través de una aplicación Android oficial disponible en las publicaciones del repositorio. La interfaz permite la gestión de feeds y la personalización del layout para adaptarse a las necesidades de lectura.
- Priorización automática de noticias importantes según intereses personales
- Lectura móvil optimizada mediante aplicación nativa Android
- Gestión centralizada de múltiples fuentes RSS en un solo lugar
- Filtrado inteligente para reducir la fatiga informativa diaria
- Integración nativa con LLMs para clasificación semántica de contenido
- Aplicación móvil Android oficial sincronizada con el servidor
- Interfaz web personalizable y adaptable al usuario
- Arquitectura ligera con requisitos bajos de recursos (1GB RAM, 10GB disco)
- No incluye contenedores Docker ni archivos Compose según análisis técnico actual
- Requiere configuración manual del entorno de ejecución sin orquestación automática
- Dependencia implícita de servicios externos para la inferencia de LLMs
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Instalar manualmente siguiendo la documentación oficial. Asegurar disponibilidad de API keys para los modelos de lenguaje. Considerar el coste de tokens por cada clasificación realizada. El sistema consume aproximadamente 1GB de RAM y 10GB de disco.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.