
MuckScraper
Agregador de noticias auto-alojado que extrae artículos de múltiples fuentes (APIs y RSS), agrupa cobertura relacionada en historias, evalúa sesgos de medios y genera resúmenes locales con IA. Incluye análisis de temas, detección de duplicados y herramientas de administración para gestión de feeds y
Ficha actualizada 27 sept 2026, 7:04 · upstream 27 sept 2026, 6:44 · release sin release detectada
Qué es MuckScraper
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
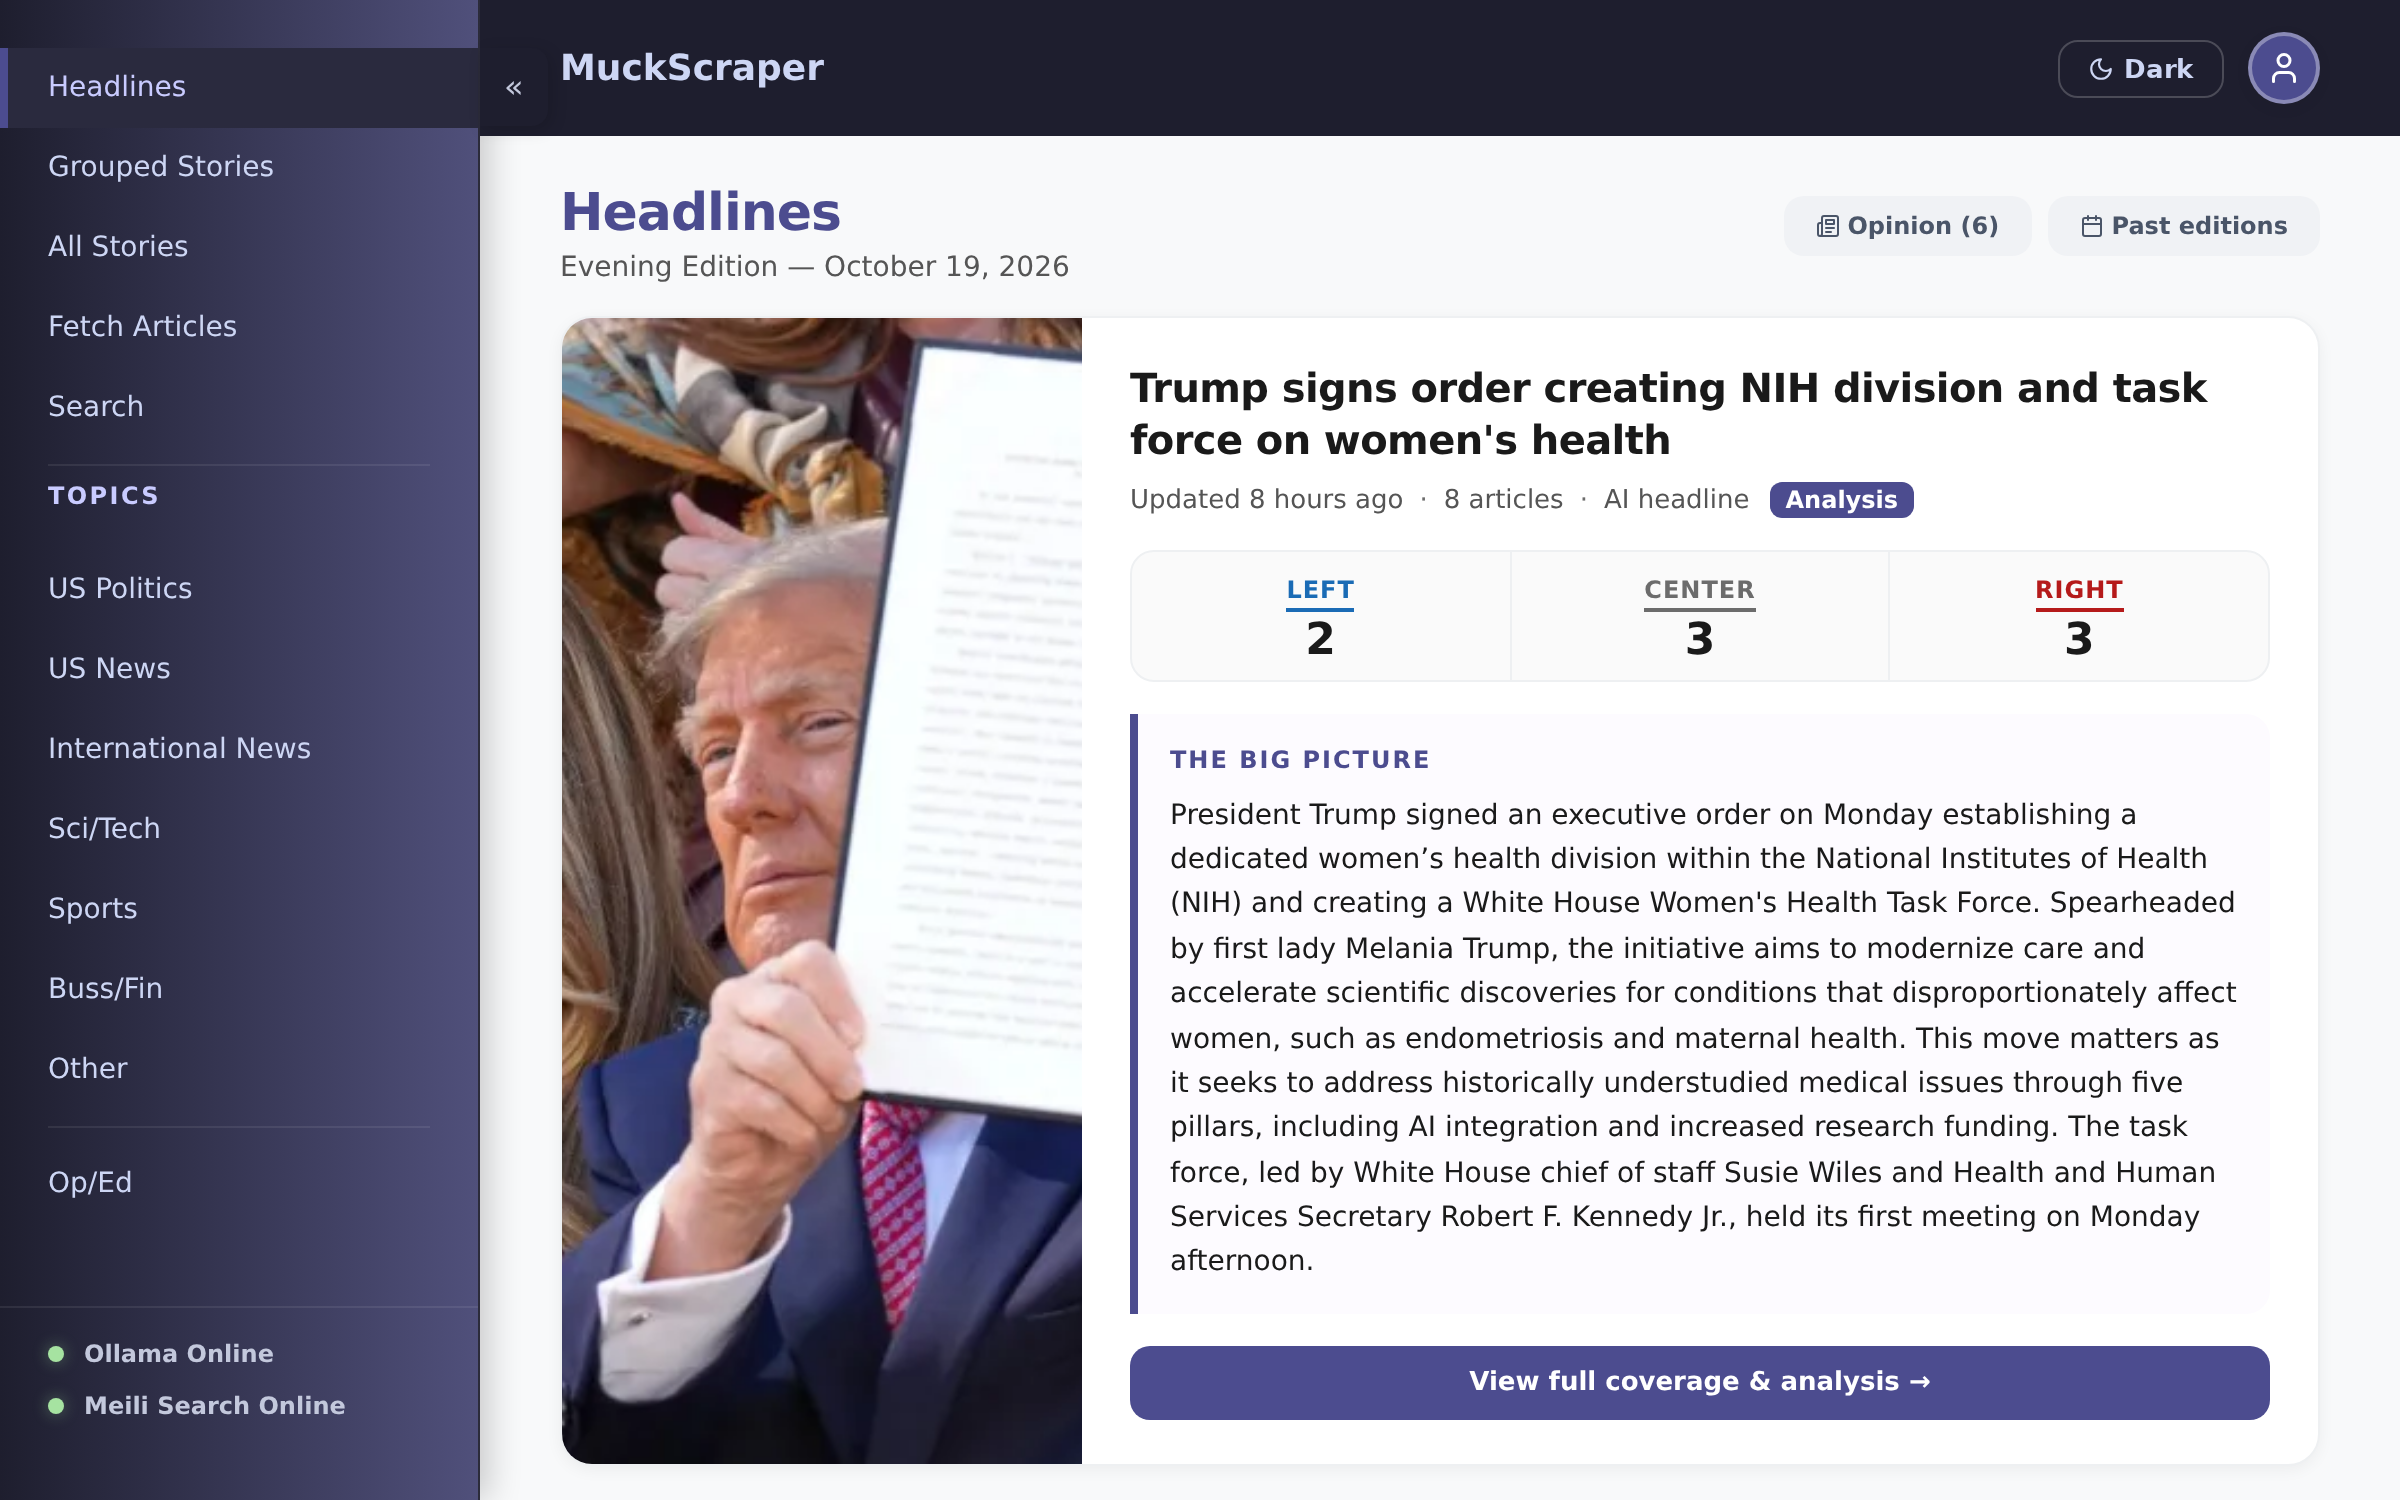
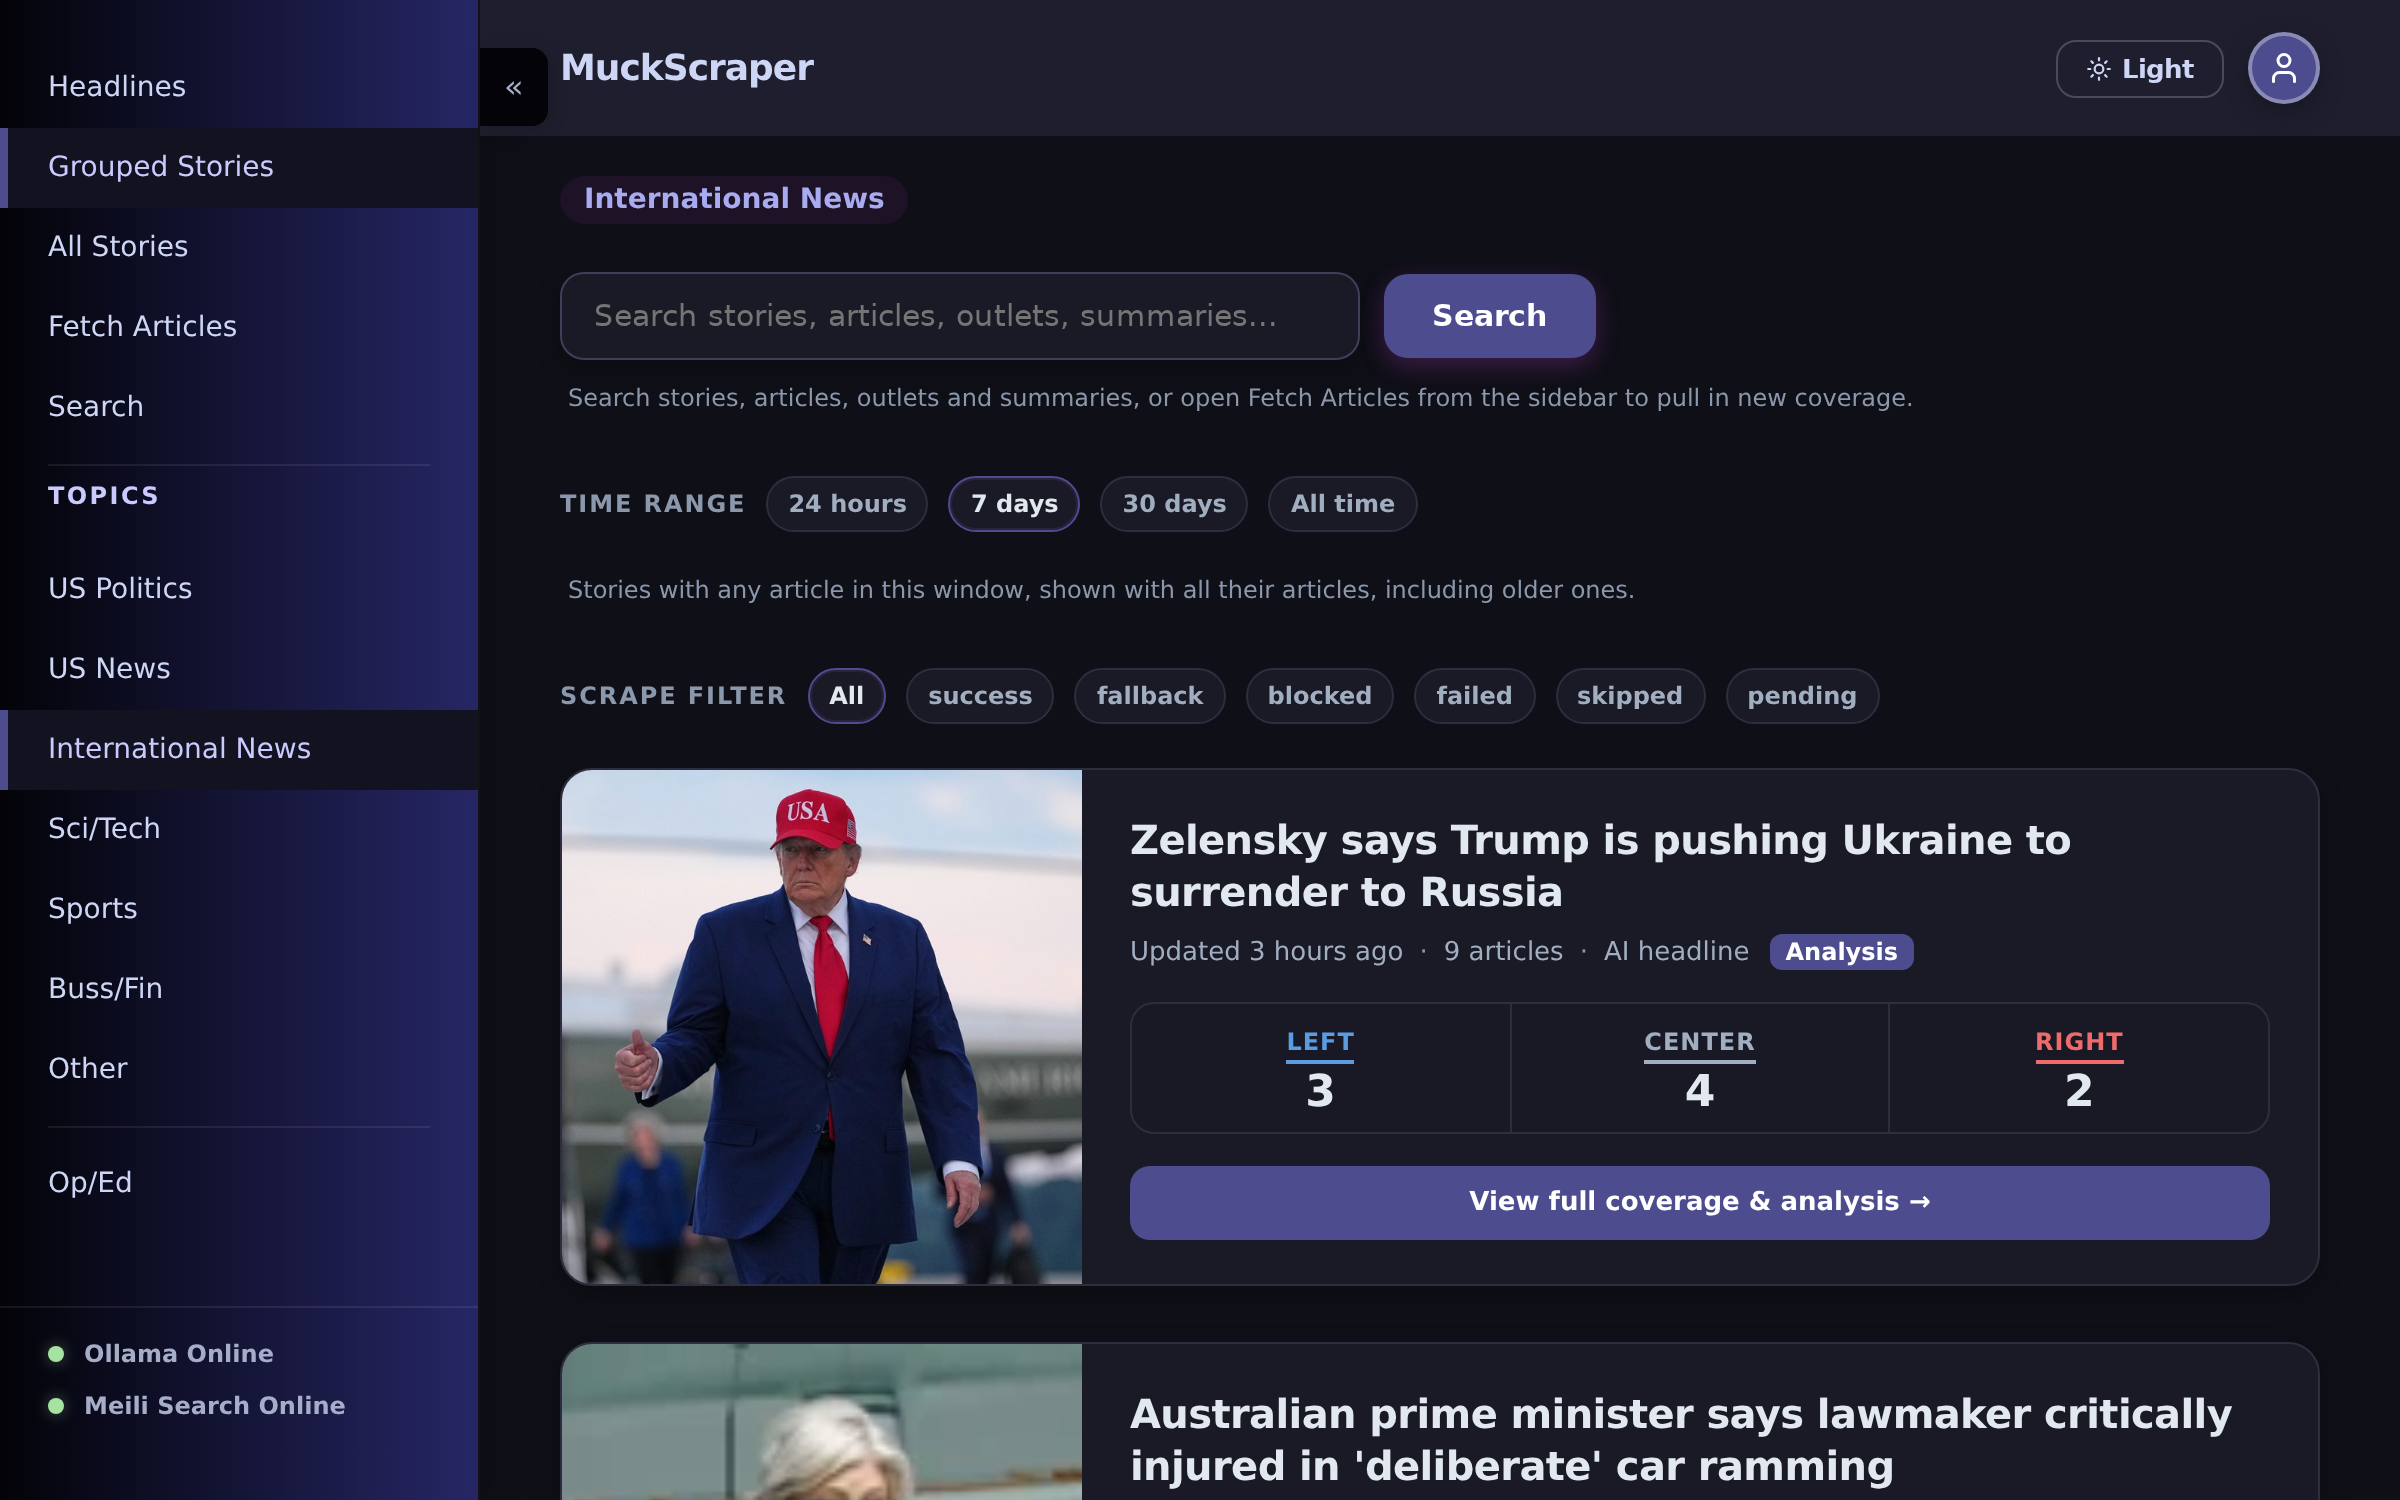
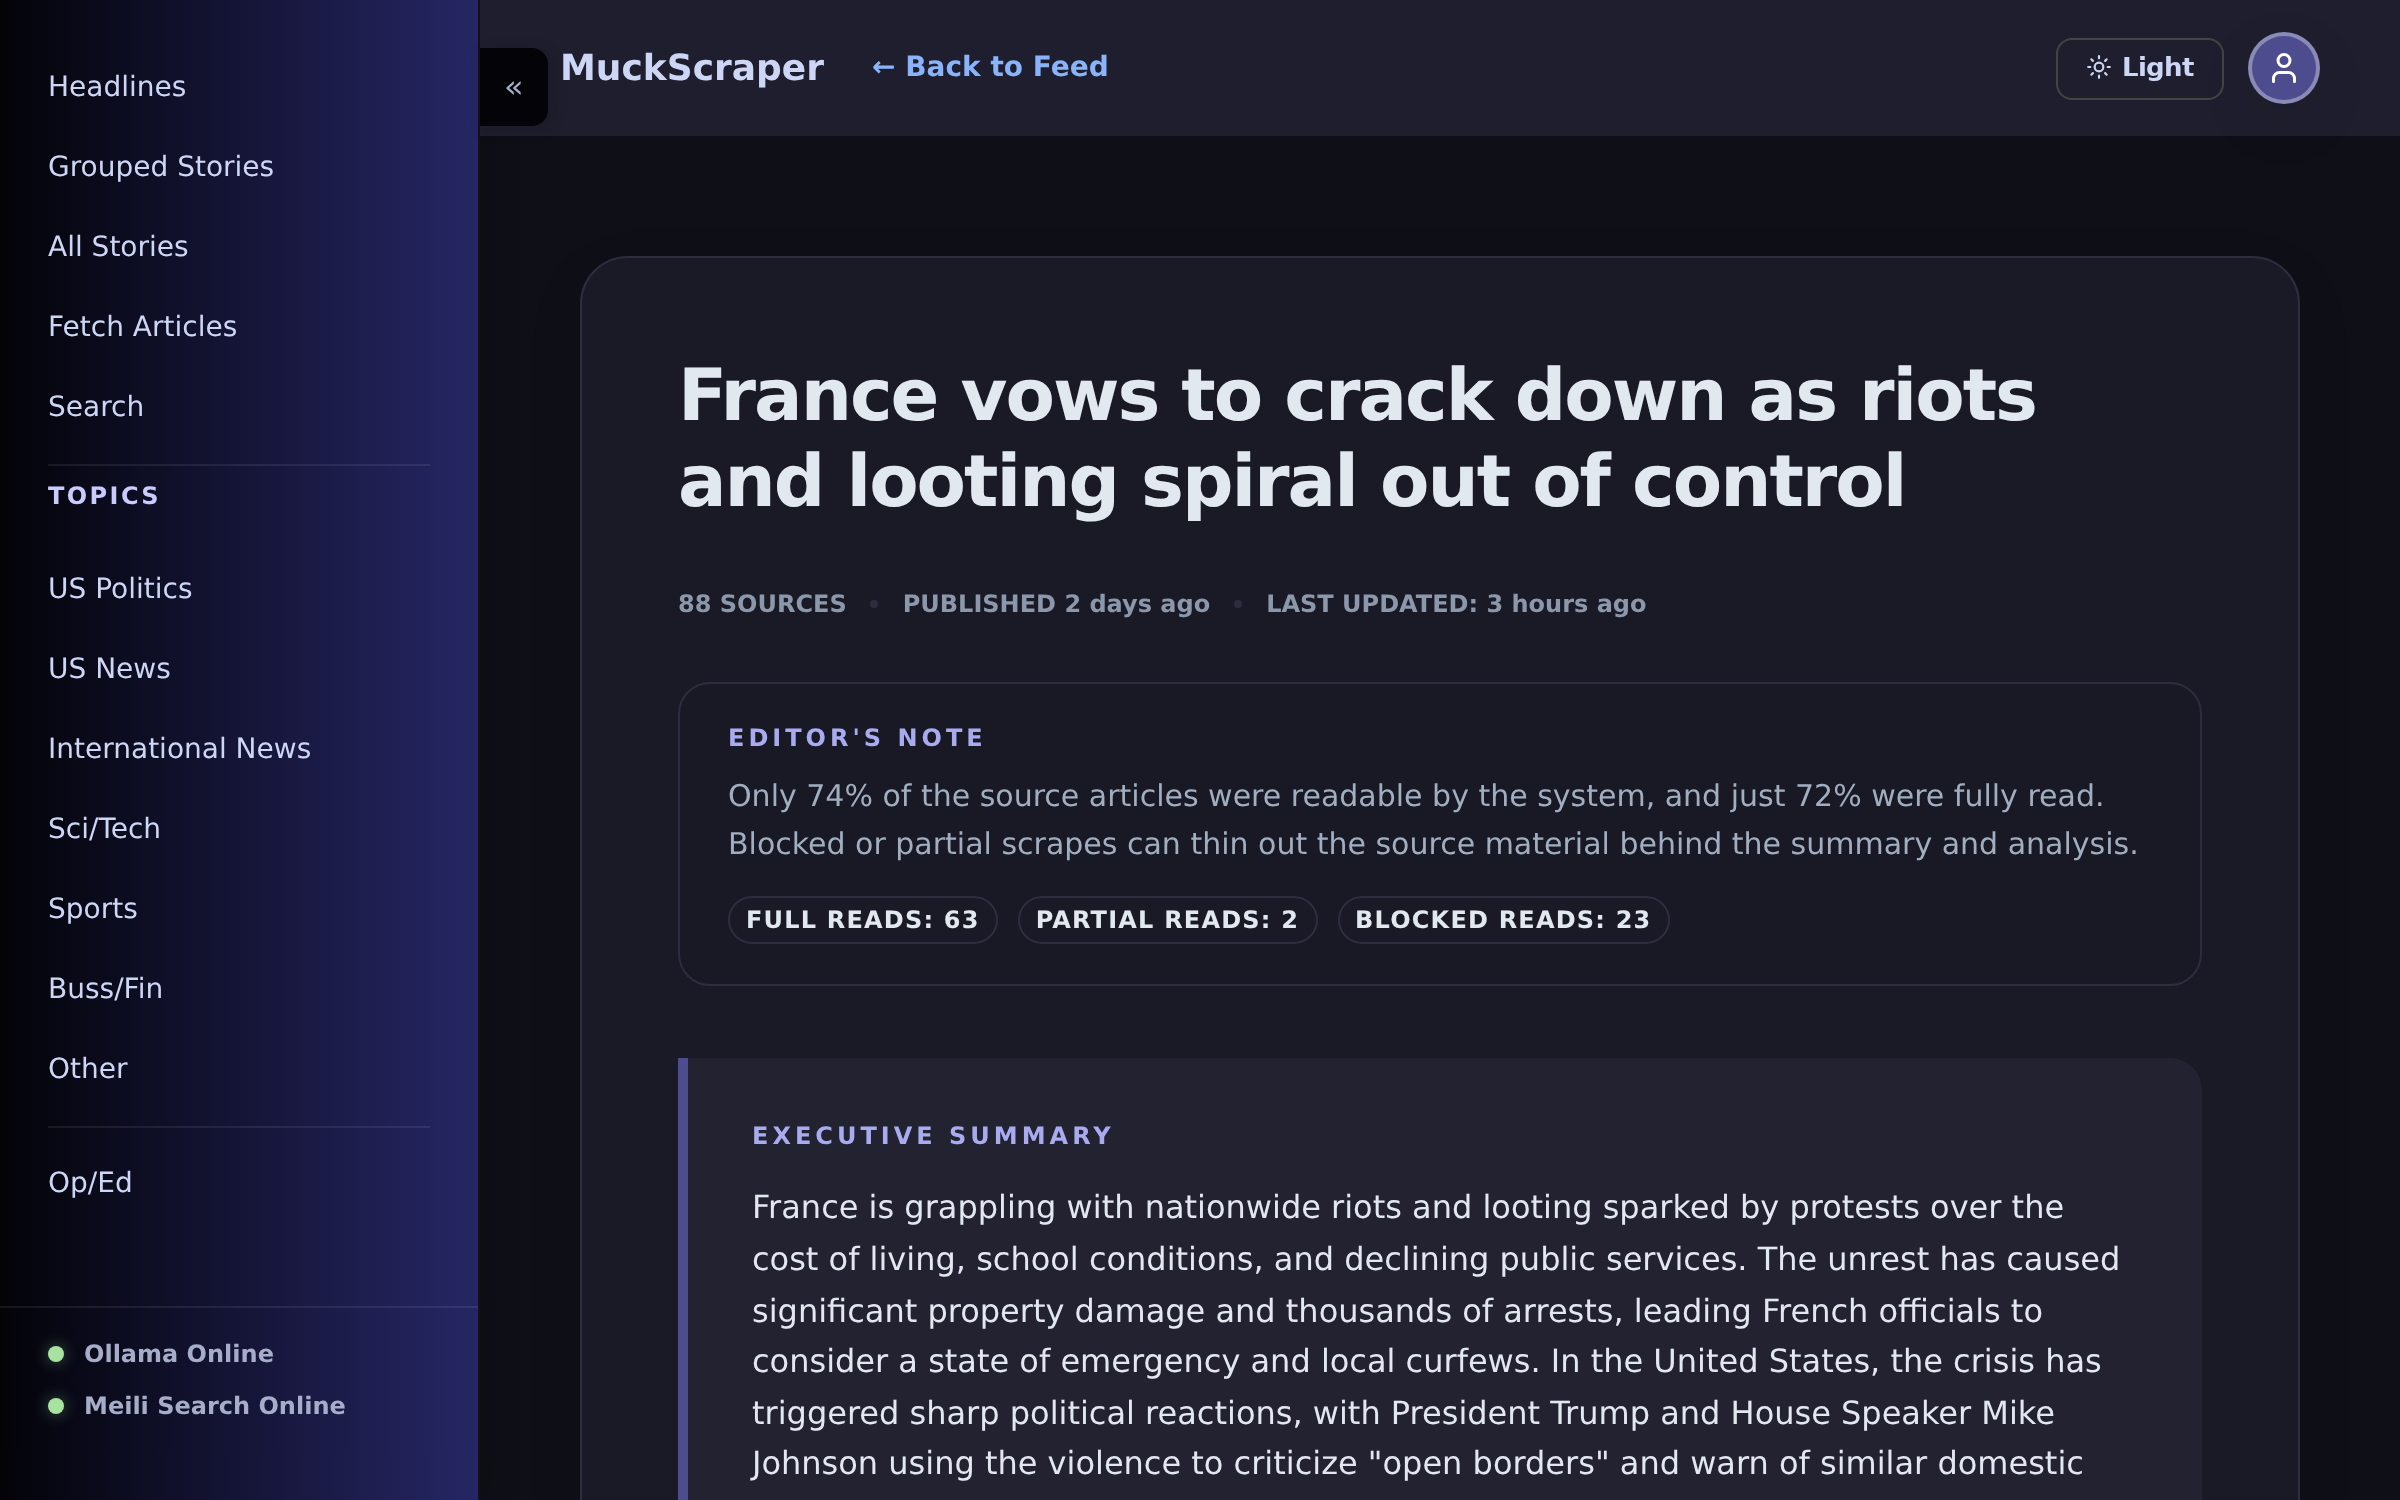
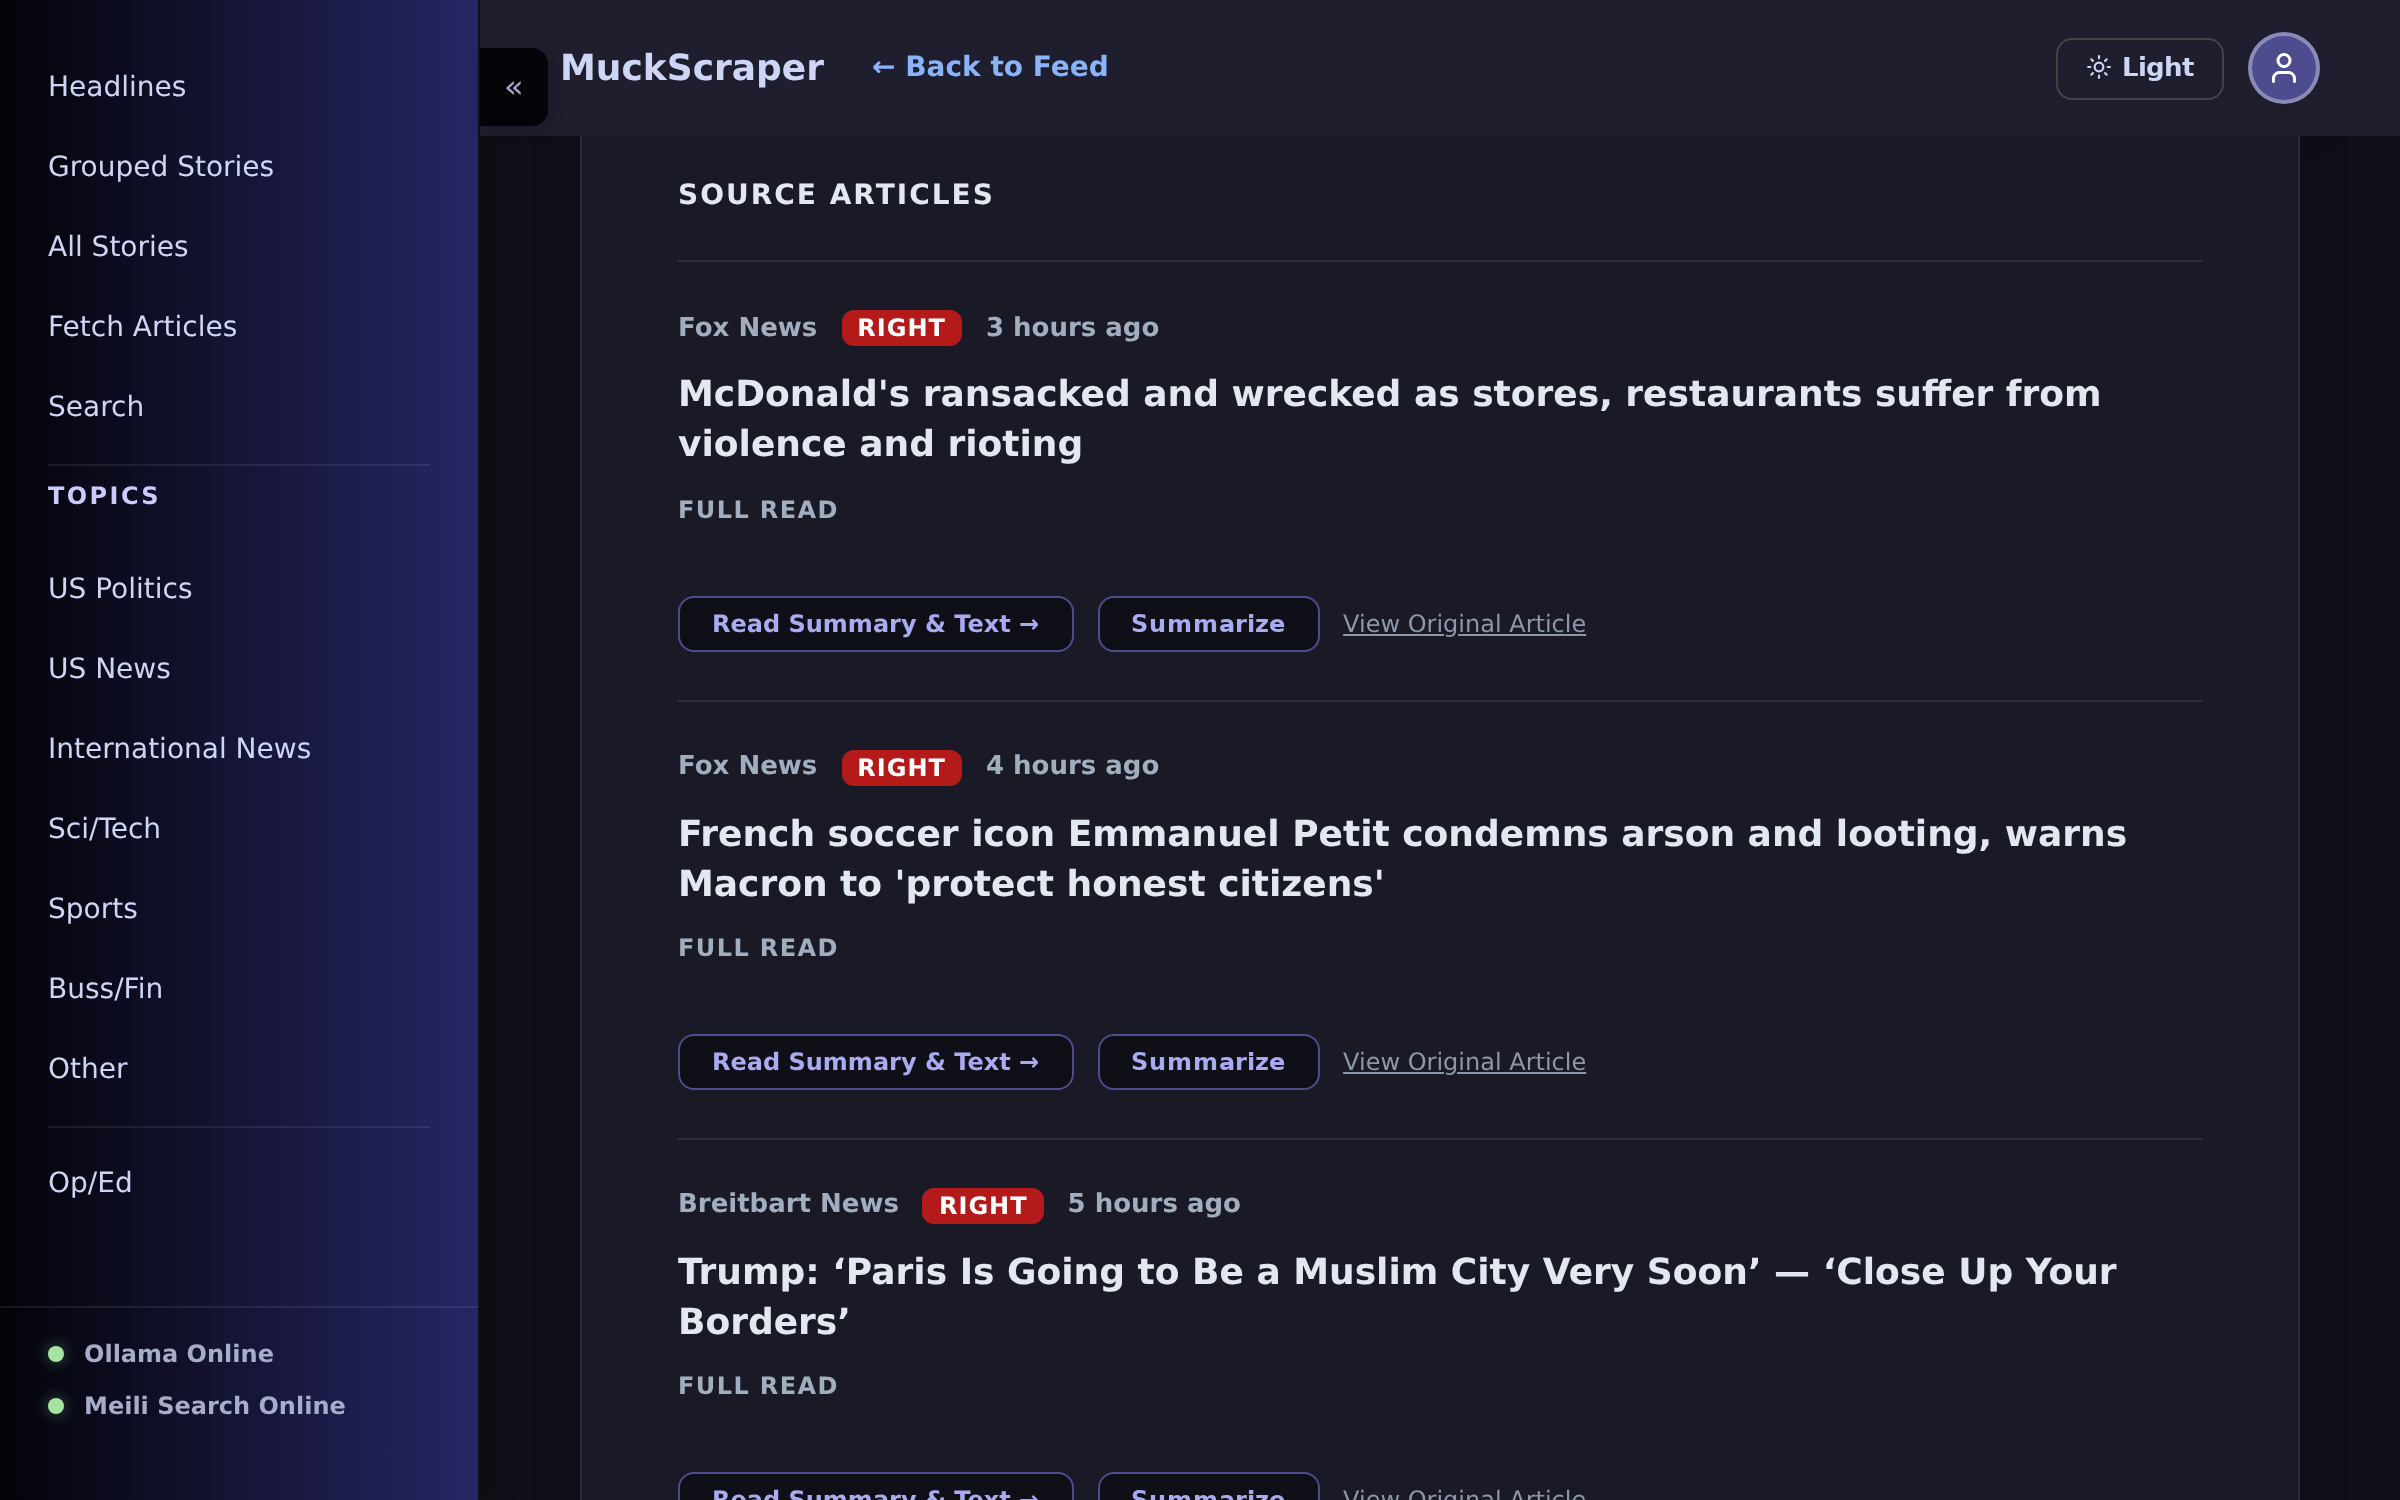
MuckScraper es una plataforma de agregación de noticias auto-alojada diseñada para ofrecer una visión panorámica y analítica del periodismo digital. A diferencia de los agregadores tradicionales que simplemente listan artículos, este sistema agrupa la cobertura relacionada proveniente de múltiples editores en historias unificadas, permitiendo comparar marcos narrativos lado a lado. La arquitectura se basa en Python con Flask como backend, utilizando PostgreSQL con pgvector para almacenamiento vectorial y Meilisearch para capacidades de búsqueda full-text eficientes.
El núcleo analítico del sistema reside en su capacidad de procesamiento local de inteligencia artificial. Por defecto, utiliza modelos locales ejecutados en Ollama para generar resúmenes, clasificar temas y evaluar el sesgo editorial, aunque soporta alternativas como Gemini, Groq o endpoints compatibles con OpenAI (como OpenRouter o vLLM). Esta flexibilidad permite distribuir cargas de trabajo entre proveedores locales y en la nube, optimizando recursos y privacidad. El sistema ingesta datos mediante APIs como NewsAPI y GNews, así como fuentes RSS, aplicando heurísticas para detectar duplicados y gestionar fallos en el raspado web.
La plataforma incluye un panel de administración robusto para la gestión manual de tareas, revisión de resultados de raspado, re-clasificación de historias y edición de prompts de IA. Soporta la publicación de ediciones programadas con límites de tamaño configurable, filtrando contenido repetitivo y priorizando noticias nuevas. Además, ofrece herramientas para auditoría de salud del raspado, gestión de listas negras de dominios y recuperación automática ante fallos en la extracción de texto o imágenes.
- Monitorización política y análisis de cobertura mediática desde múltiples perspectivas ideológicas
- Investigación periodística que requiere agrupación de fuentes para evitar sesgos de confirmación
- Lectura personal sin suscripciones a servicios comerciales ni rastreo publicitario
- Automatización de resúmenes diarios de noticias para equipos de gestión o investigación
- Desarrollo de aplicaciones internas que consuman feeds de noticias procesados y enriquecidos con IA local
- Agrupación de historias basada en vectores (pgvector) para conectar cobertura dispersa en múltiples fuentes
- Evaluación de sesgo editorial mediante datos de AllSides o modelos locales de LLM
- Procesamiento de IA local-first con soporte nativo para Ollama y endpoints compatibles OpenAI
- Arquitectura contenerizada completa con Docker Compose para despliegue simplificado
- Herramientas administrativas para gestión manual de feeds RSS, prompts y edición de historias
- Detección robusta de duplicados por URL y normalización de títulos para evitar redundancias
- Dependencia de claves API externas (NewsAPI, GNews) que pueden tener límites de cuota o costes asociados
- Requiere hardware local con capacidad de cómputo para ejecutar modelos de IA si se usa Ollama localmente
- Las rutas de administración deben protegerse mediante red privada o VPN para evitar exposición pública
- La calidad de los resúmenes y análisis depende directamente del modelo de lenguaje seleccionado y sus capacidades
- El raspado web puede verse afectado por cambios en las estructuras HTML de las fuentes externas no controladas
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
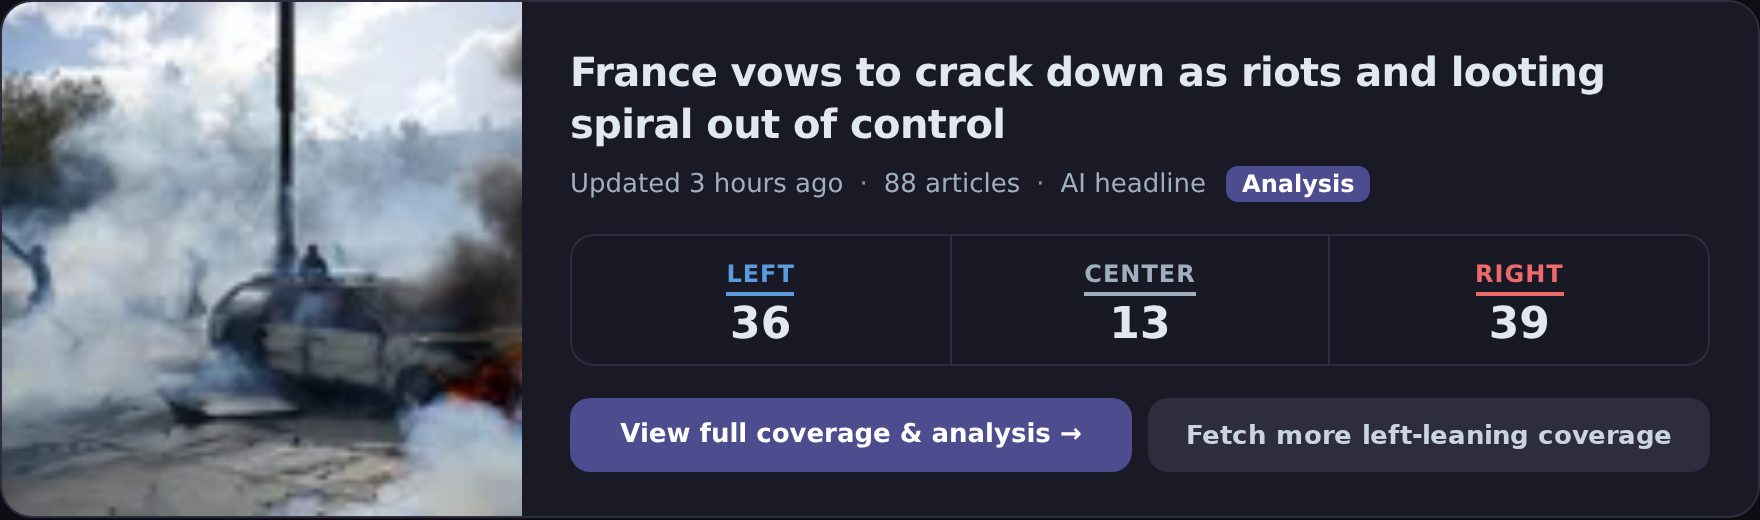
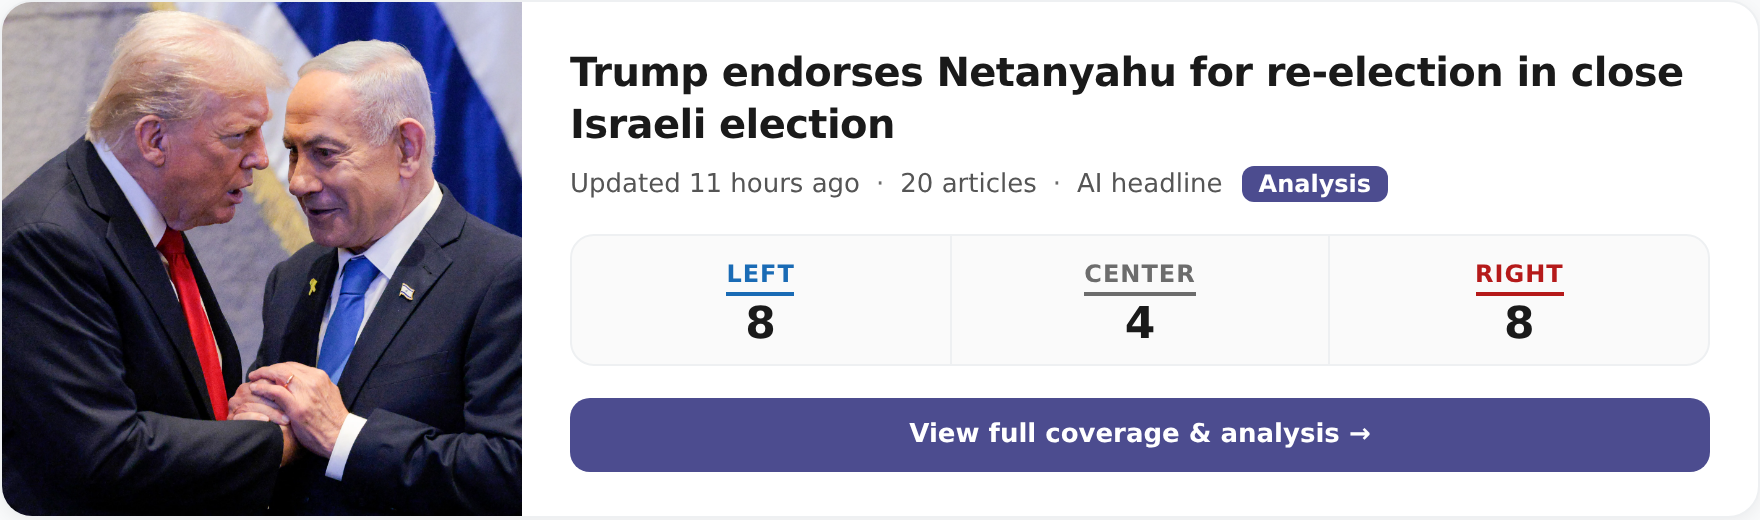
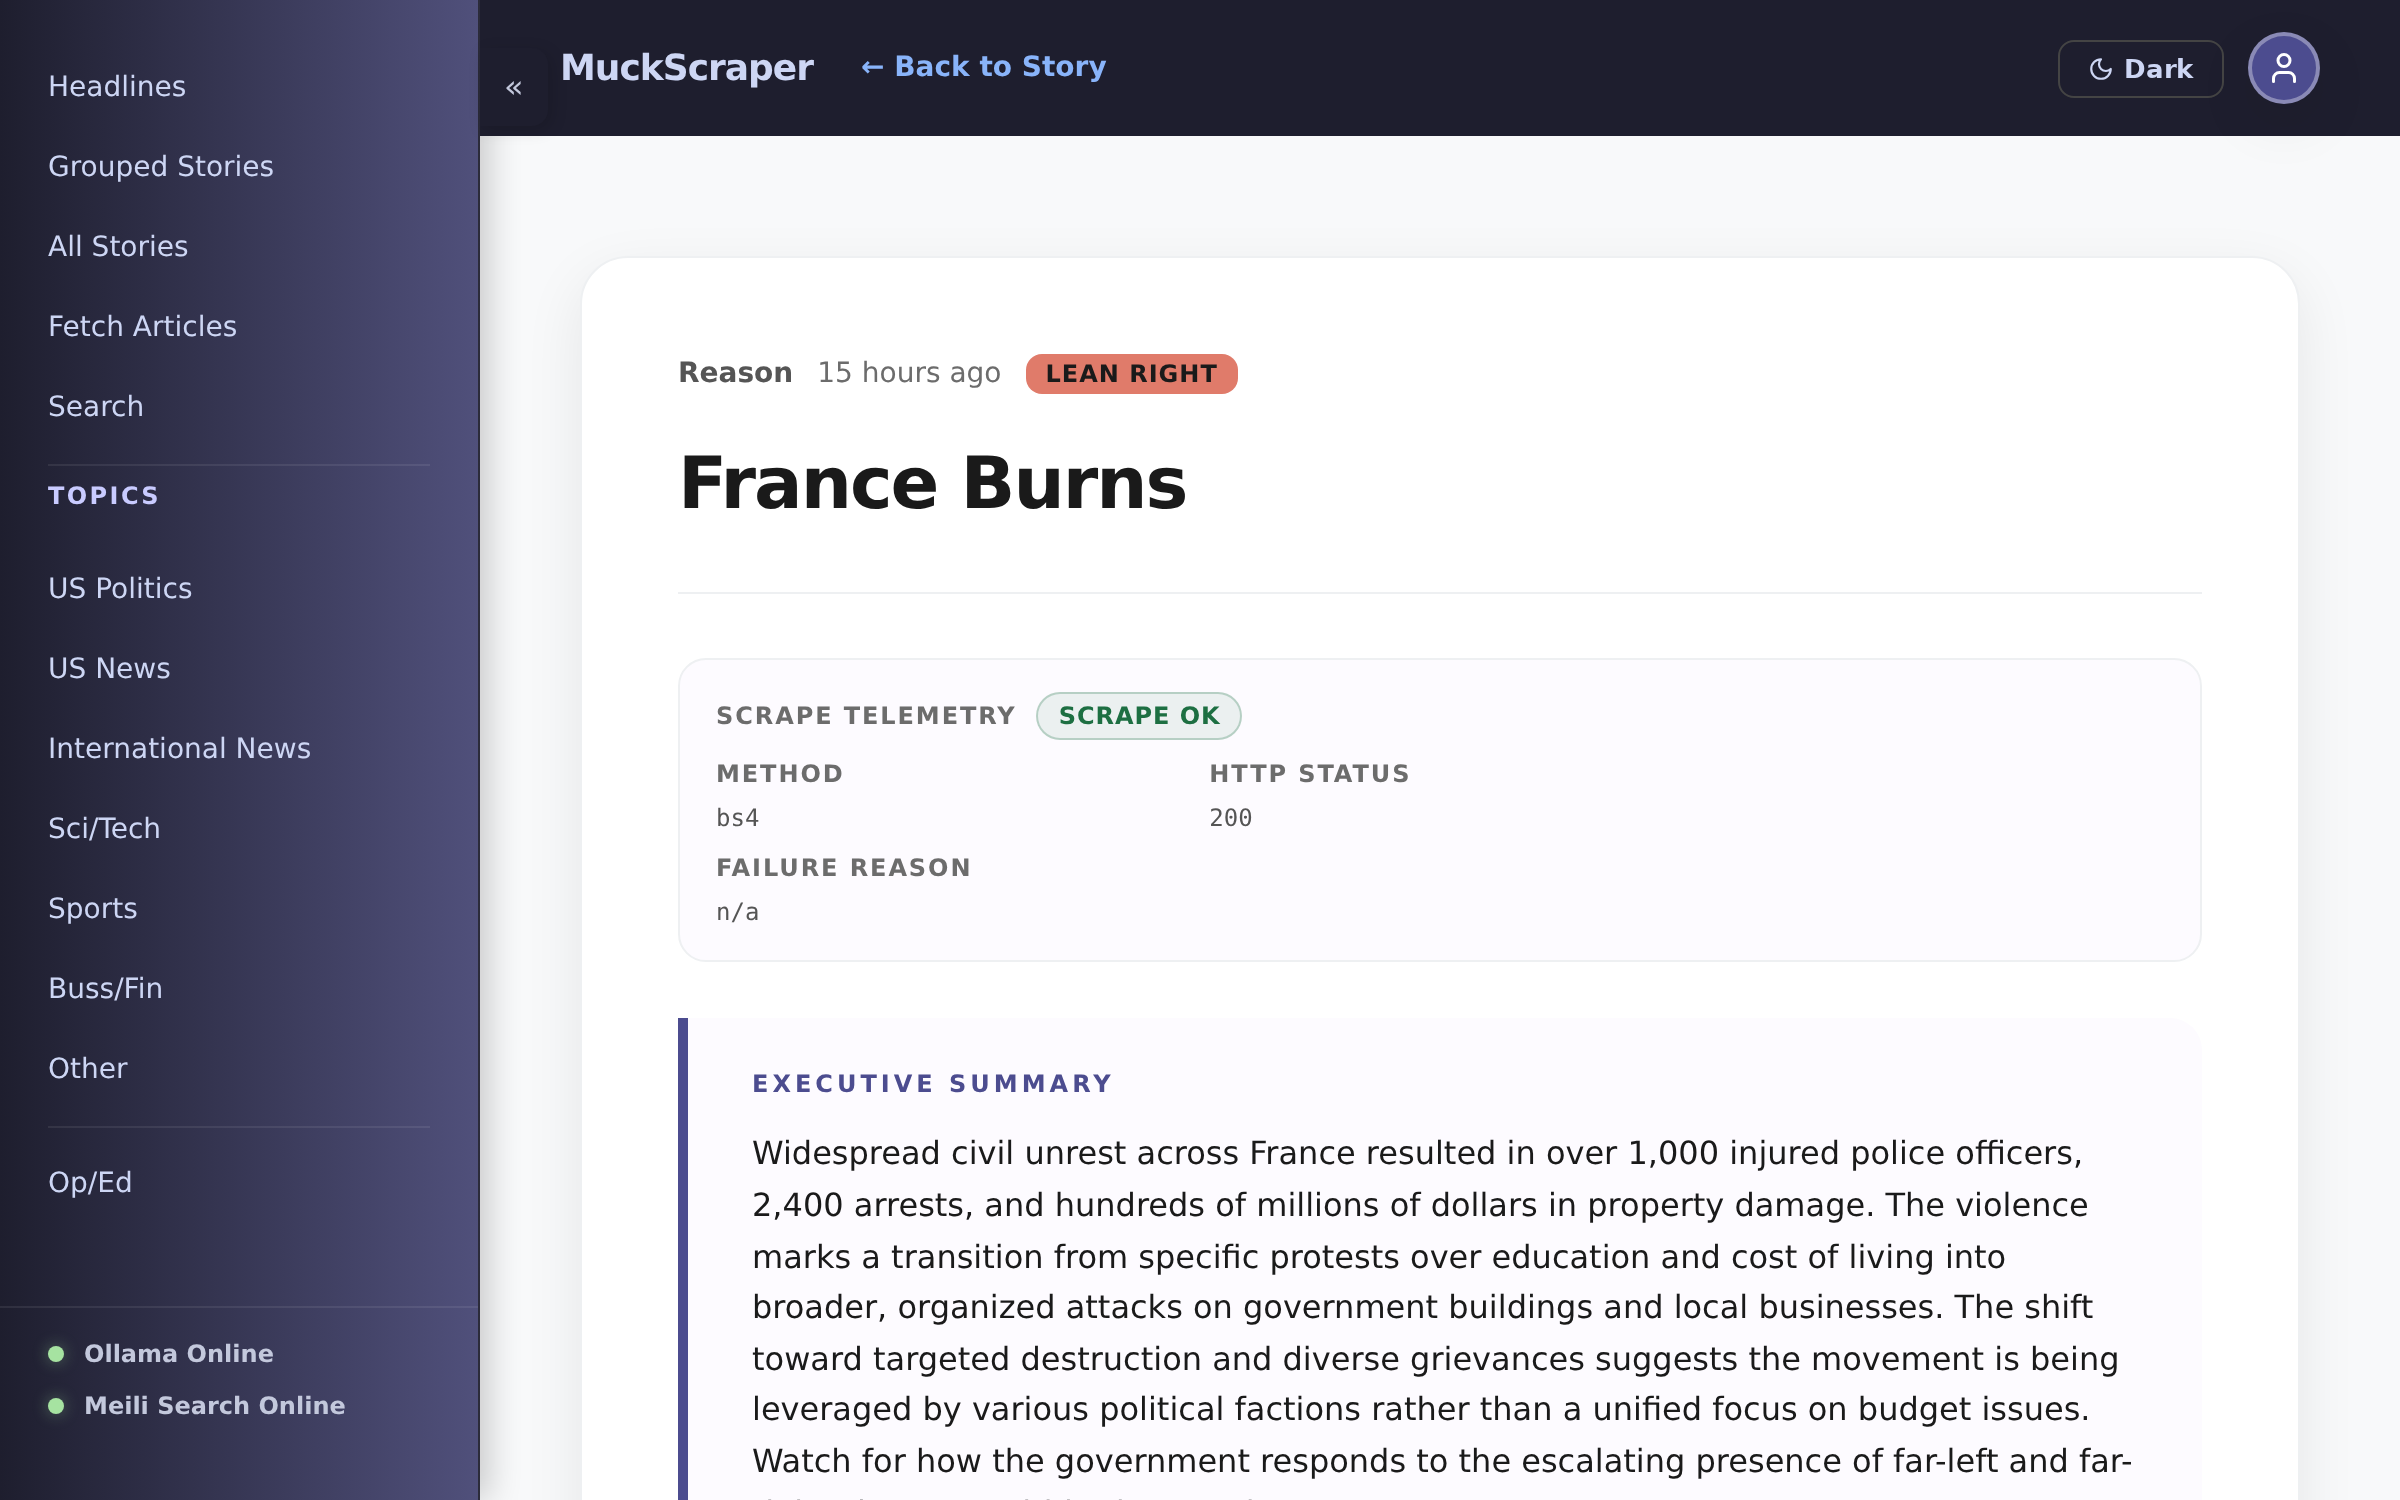
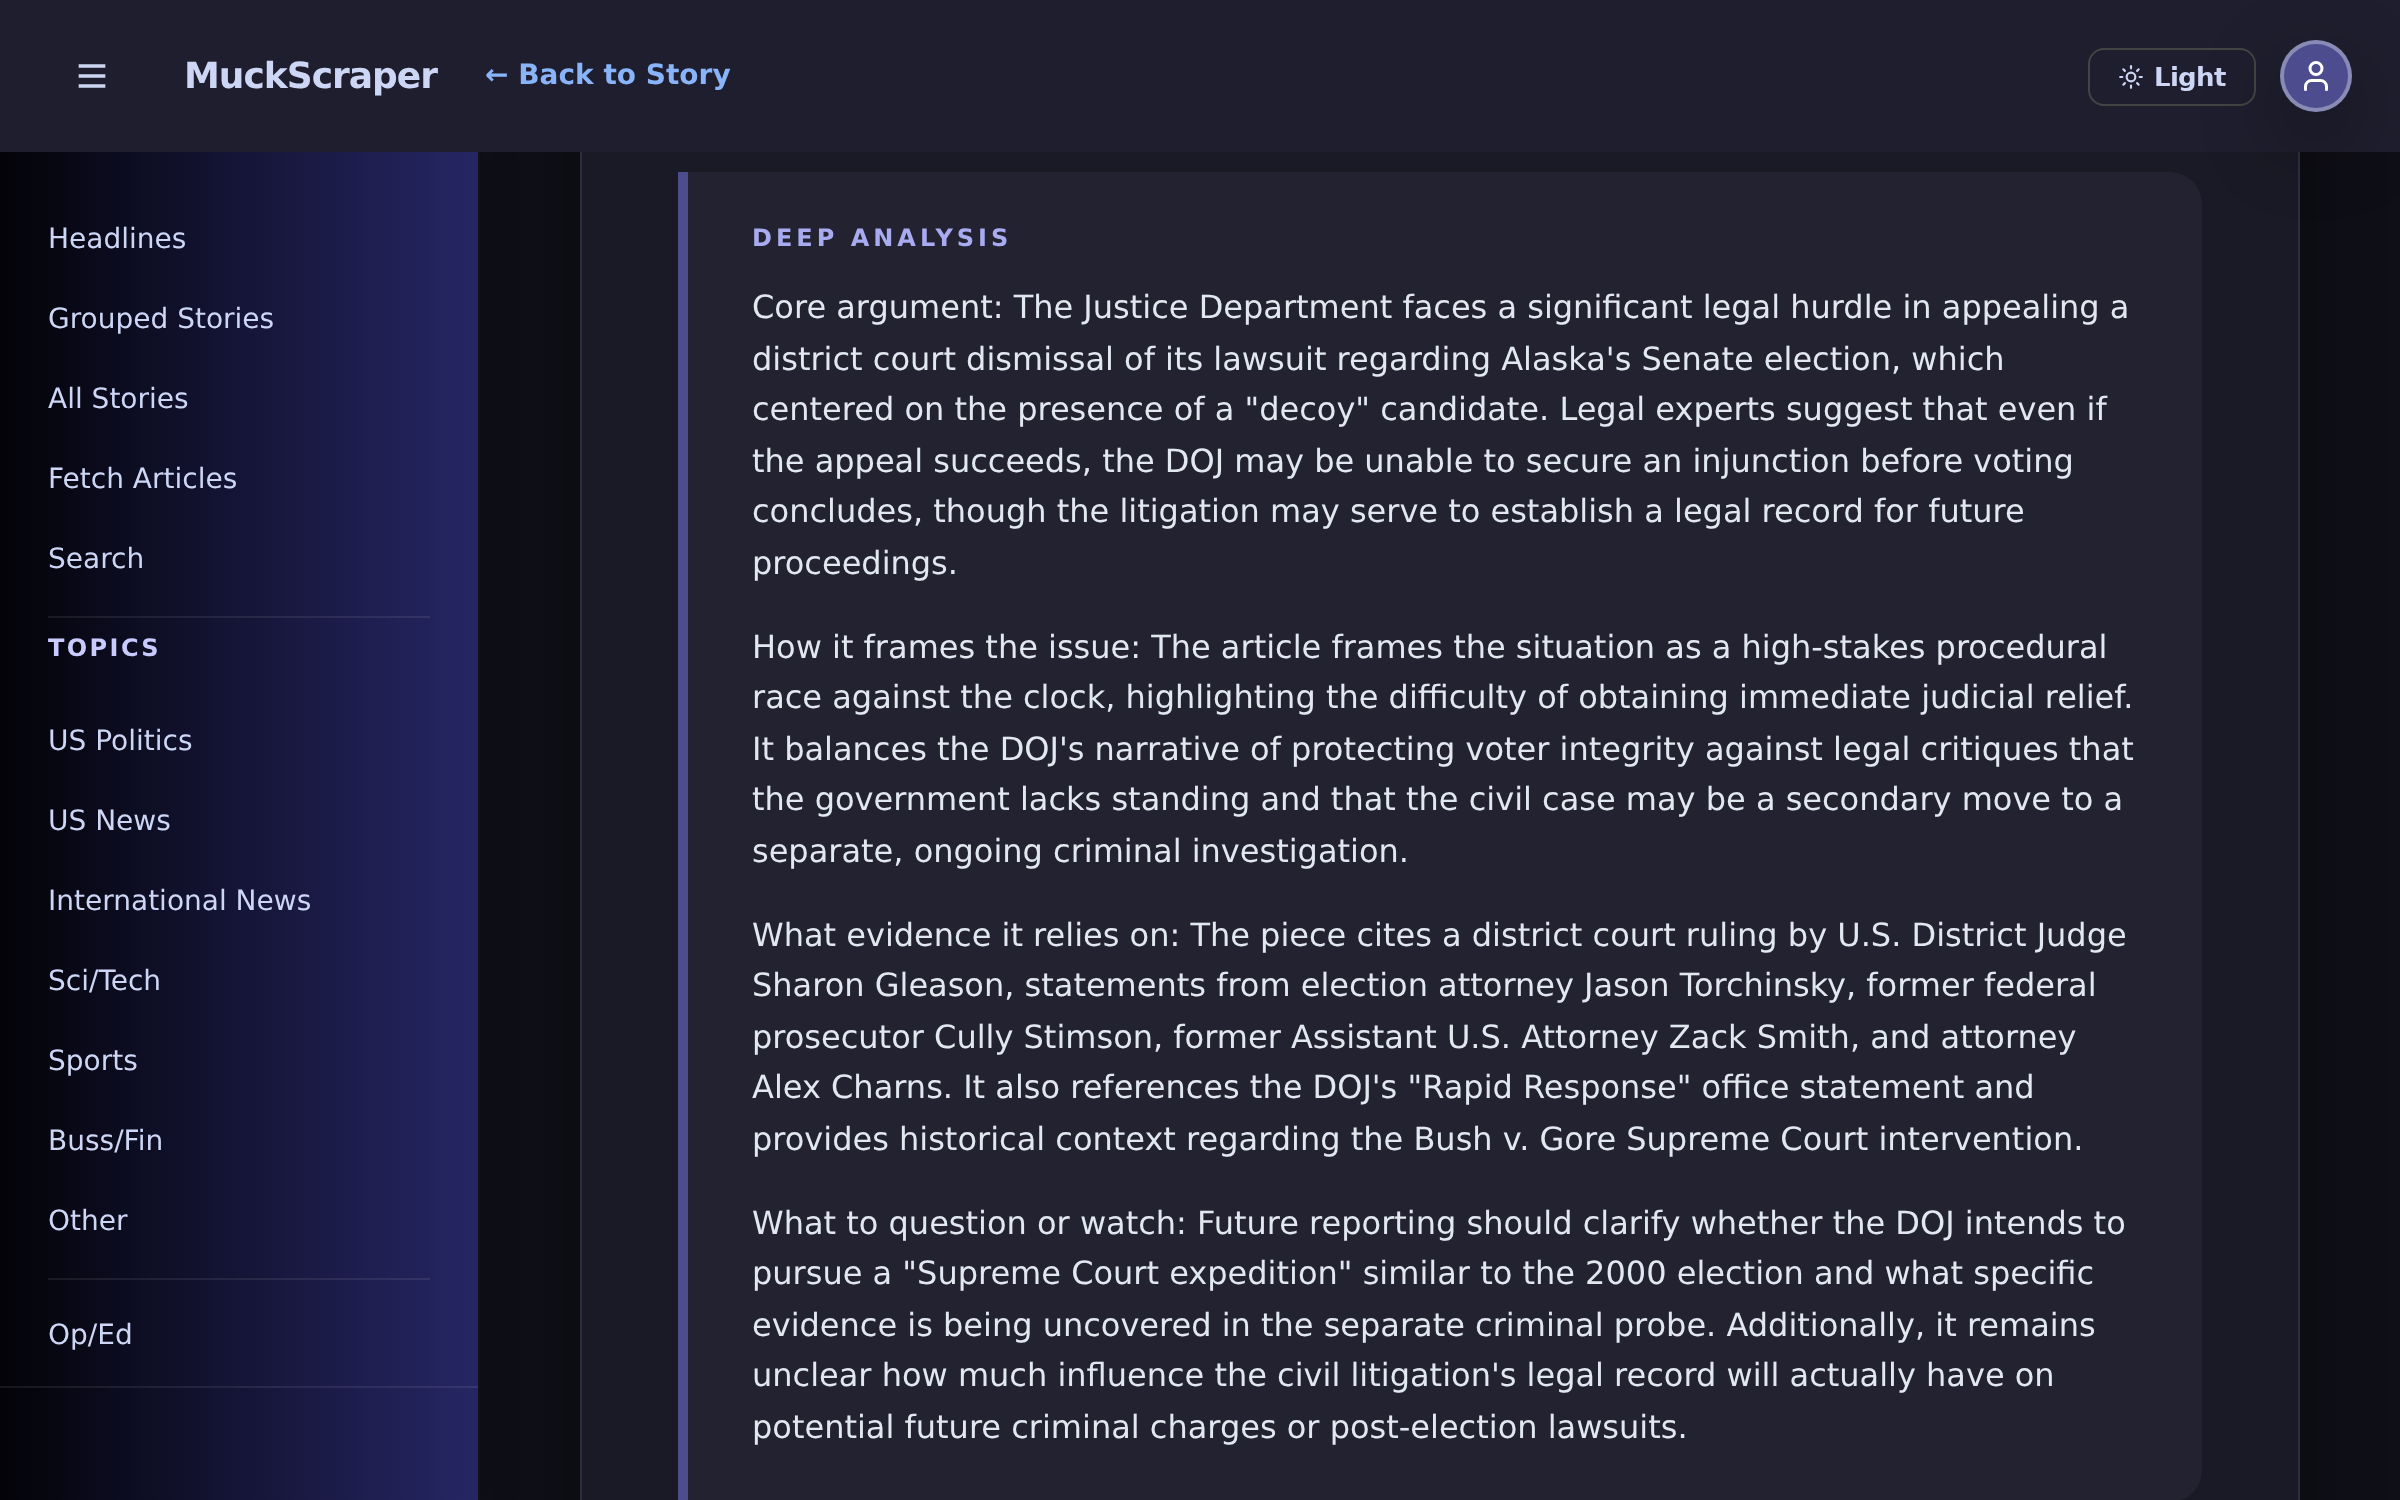
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Desplegar con Docker Compose, asegurando que el admin se mantenga en red local o detrás de VPN (WireGuard/Tailscale). Configurar variables de entorno para claves API y proveedor LLM antes del primer inicio. Ejecutar `flask db upgrade` tras cambios de esquema. No exponer rutas `/admin` a internet público. Asegurar que el host de Ollama esté accesible o usar endpoints compatibles en la nube si no hay GPU local.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.