
monster-search
Herramienta CLI y API en Python que consulta 34 motores de búsqueda simultáneamente mediante fusión RRF inteligente. Soporta categorías como web, académico, código y seguridad sin cuentas ni pagos, ideal para investigación rápida o profunda con auto-hospedaje opcional.
Ficha actualizada 25 sept 2026, 13:57 · upstream 25 sept 2026, 13:51 · release v0.10.0
Qué es monster-search
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
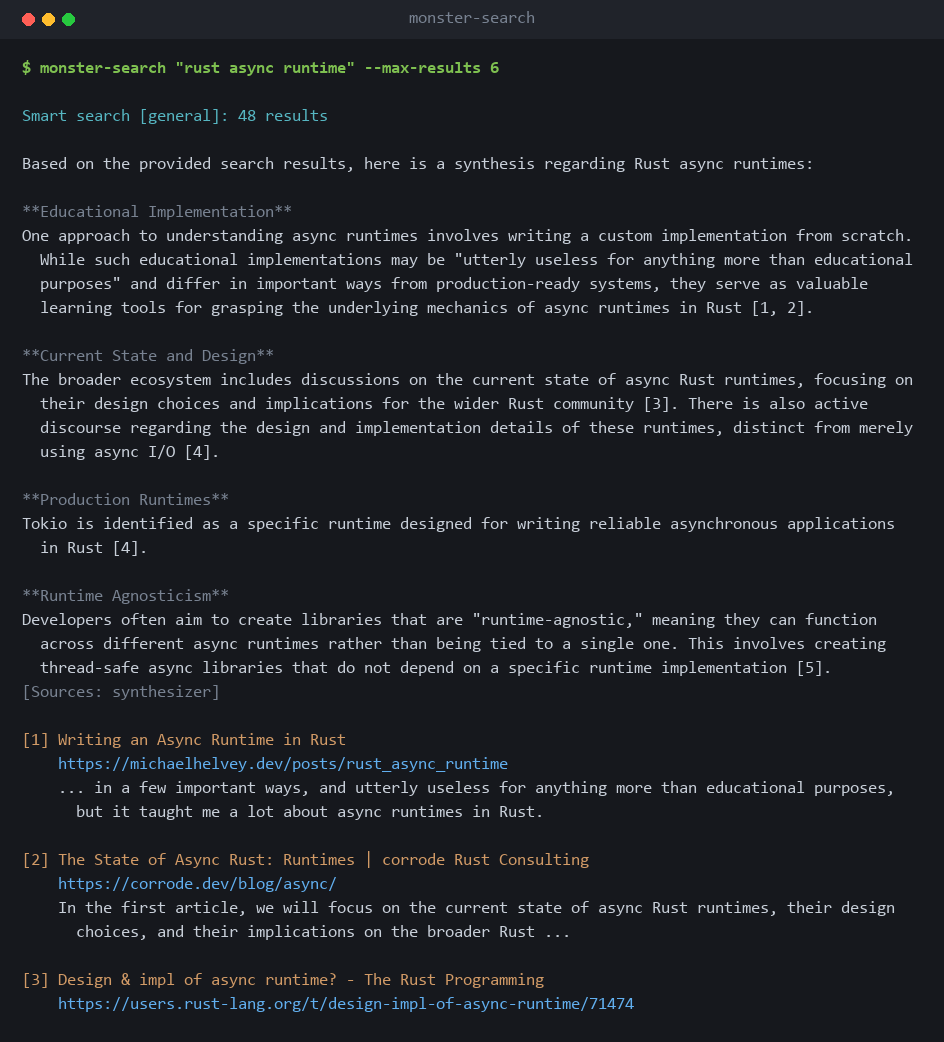
monster-search es una herramienta CLI y API en Python que unifica 34 motores de búsqueda en una sola consulta inteligente. Clasifica la intención del usuario mediante regex y ejecuta motores específicos por categoría (seguridad, académico, código) sin activar todos los servicios innecesariamente. Utiliza fusión RRF ponderada para priorizar resultados relevantes y deduplicación MinHash LSH para eliminar redundancias.
Es gratuita, no requiere registro ni API keys pagas para la mayoría de sus fuentes externas. Soporta modos rápidos (Tier 1) y profundos (Tier 2/3) con circuit breakers para evitar fallos en cascada. Incluye capacidades adicionales como monitoreo de cambios en URLs y extracción de contenido web mediante Crawl4AI.
La arquitectura permite auto-hospedaje de servicios específicos (como Vane o Khoj) junto con motores externos gratuitos, facilitando la privacidad y el control sobre los datos consultados sin depender de infraestructura compleja como Docker por defecto para el núcleo.
- Investigación rápida de noticias y web general sin sesgos de motor único
- Búsqueda de vulnerabilidades (CVE) y dependencias de seguridad automatizada
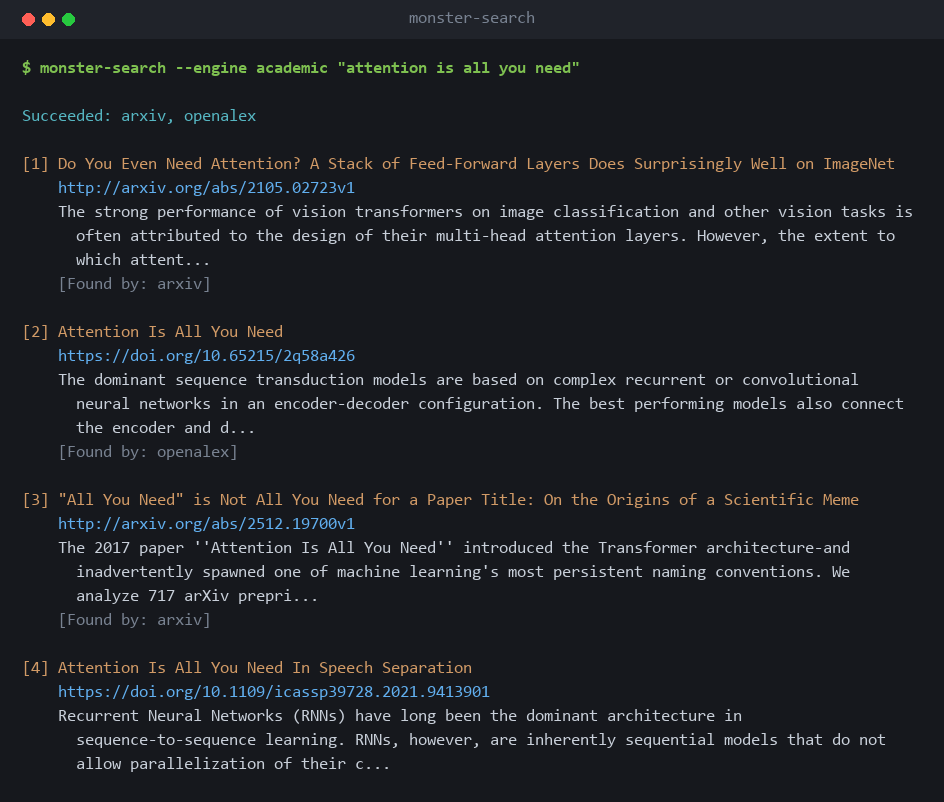
- Análisis académico fusionando arXiv, Semantic Scholar y OpenAlex
- Monitoreo de cambios en sitios web específicos para alertas tempranas
- Extracción de contenido profundo desde URLs mediante Crawl4AI integrado
- Búsqueda de código y repositorios GitHub con fusión de resultados
- Fusión RRF ponderada que mezcla resultados de múltiples fuentes en una lista única
- Ejecución inteligente por capas (Tiered) que activa motores lentos solo si los rápidos fallan o con flag --deep
- Circuit breakers independientes por motor para evitar que un fallo bloquee la búsqueda completa
- Arquitectura híbrida: motores externos gratuitos + auto-hospedaje opcional sin Docker obligatorio
- Deduplicación MinHash LSH basada en similitud de contenido y URL
- API Python asincrónica (asyncio) para integración directa en scripts o aplicaciones
- No incluye Dockerfile ni Compose por defecto, requiriendo configuración manual de servicios auto-hospedados
- Motores Tier 3 (investigación profunda) pueden tardar entre 3 y 8 minutos en ejecutarse
- Algunos motores requieren autenticación externa o cookies (ej. Perplexity) que deben gestionarse por el usuario
- La deduplicación MinHash puede fallar en textos muy cortos, recayendo en deduplicación por URL
- Dependencia de Python 3.12+ para la instalación y ejecución del núcleo
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
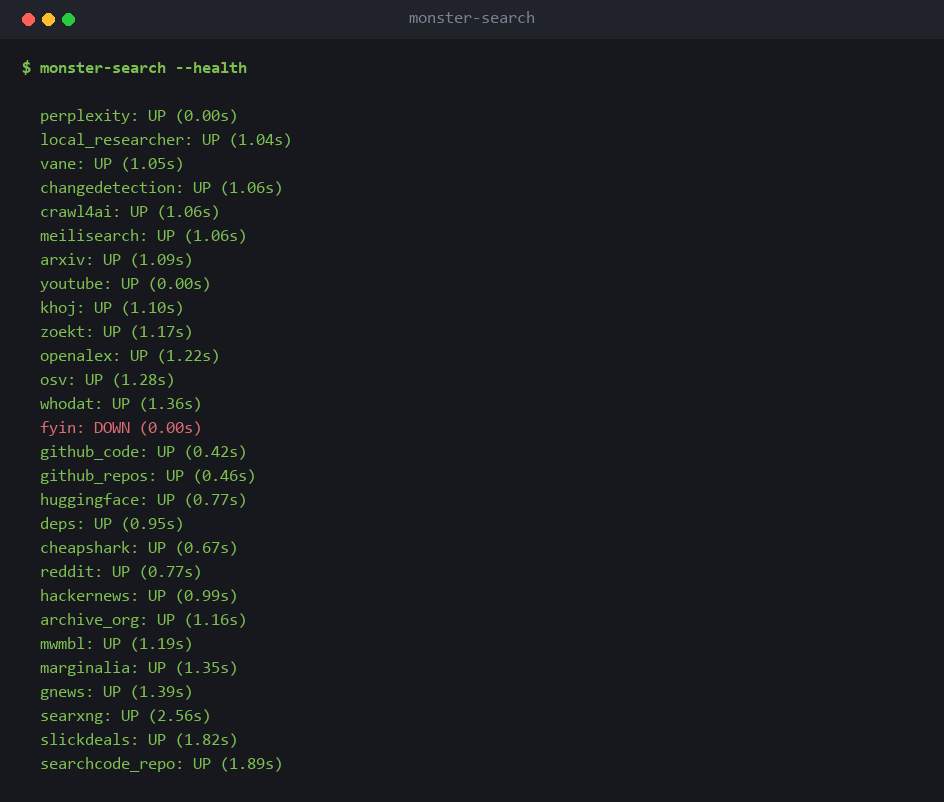
Instalar con `pip install -e ".[dev]"` en entorno Python 3.12+. El núcleo no usa Docker, pero servicios como Vane o Khoj requieren contenedores externos. Configurar variables de entorno según documentación específica de cada motor externo. Para búsqueda rápida usar modo Tier 1; para investigación profunda añadir `--deep`. Verificar salud con `monster-search --health`.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.