
modelship
Modelship es un servicio de inferencia de IA autocontenido que soporta modelos de lenguaje, embeddings, voz y visión por computadora en una arquitectura basada en Ray Serve. Permite ejecutar múltiples modelos en la misma instancia con soporte para GPU y CPU.
Ficha actualizada 23 sept 2026, 14:09 · upstream 23 sept 2026, 13:38 · release v0.7.15
Qué es modelship
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
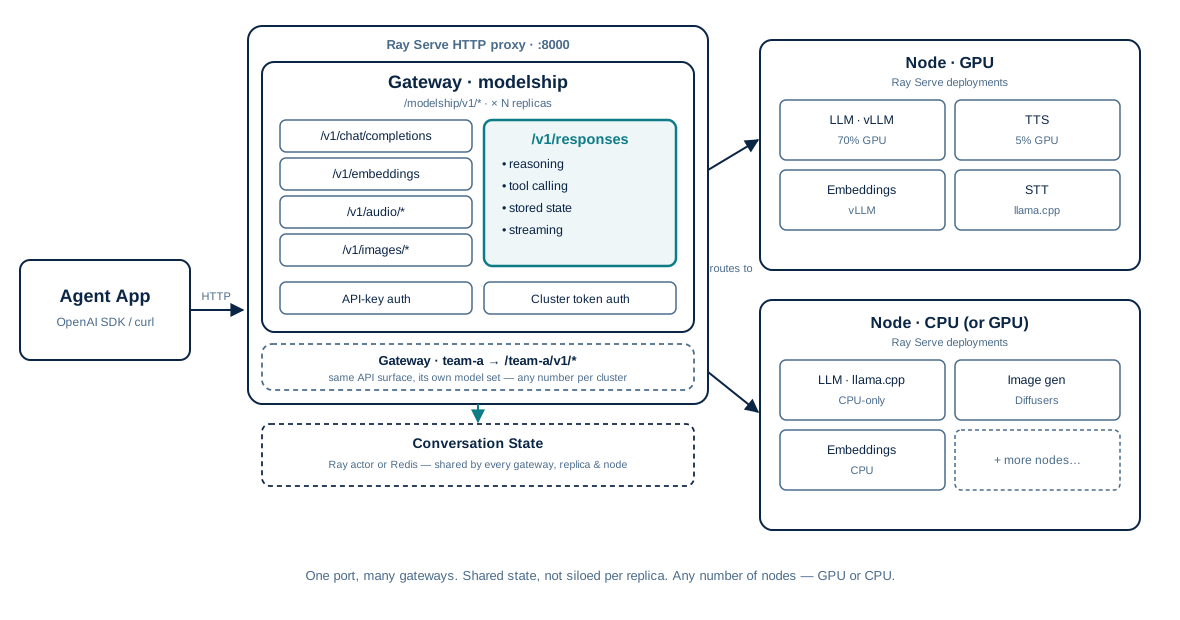
ModelShip es un framework de inferencia de IA autocontenido que proporciona un endpoint OpenAI-compatible (v1) para generar respuestas del lenguaje, embeddings, transcripción de voz, traducción de audio y generación de imágenes. Su arquitectura basada en Ray Serve permite escalar horizontalmente con múltiples instancias compartiendo el mismo estado de conversación, mientras que cada modelo tiene su propia configuración de recursos. Soporta modelos GGUF (llama.cpp), vLLM, Diffusers, sherpa-onnx y whisper.cpp, permitiendo elegir entre CPU o GPU según la disponibilidad del hardware.
- Generación de respuestas conversacionales para asistentes virtuales
- Procesamiento de lenguaje natural con razonamiento paso a paso
- Transcripción automática de audio a texto
- Traducción de voz entre idiomas
- Generación de imágenes mediante modelos de difusión
- Análisis de sentimiento y detección de emociones en texto
- Soporta conformance completa al estándar Open Responses (17/17 tests)
- Diseñado para escalar horizontalmente sin perder consistencia del estado
- Permite múltiples gateways por cluster compartiendo un único puerto
- Soporte nativo de inferencia en CPU y GPU con backends optimizados
- Modelos GGUF (llama.cpp) ofrecen rendimiento superior a vLLM para modelos pequeños
- API RESTful completa con streaming SSE para respuestas en tiempo real
- Requiere un entorno de ejecución externo como Docker o Kubernetes
- No incluye el modelo base por defecto (necesita instalación manual)
- La inferencia CPU puede ser más lenta que la GPU en modelos grandes
- El estado de conversación se guarda en Redis o memoria del Ray, no persiste entre instancias sin configuración adicional
- Soporte limitado para modelos muy grandes (>7B) con backends GGUF por rendimiento
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.

Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Instala el contenedor Docker con `docker run --rm -p 8000:8000 ... start`. Para múltiples gateways usa `--gateway-name` en cada flag. Configura modelos mediante un archivo YAML separado por backend (vLLM, llama_server, diffusers). Usa `uv tool install mship && mship bootstrap --metal` para Apple Silicon. Activa observabilidad con Prometheus metrics y OpenTelemetry export. Reconcilia cambios de modelo incrementalmente sin downtime.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.