
minimax-music-ui
Interfaz web estilo Suno para MiniMax-Music3 autoalojado. Permite generar música con prompts y letras, gestionar cola de renders, reproducir en vivo y mantener una biblioteca local. Incluye panel de configuración para servidores inference.
Ficha actualizada 26 sept 2026, 8:16 · upstream 26 sept 2026, 7:59 · release v0.1.0
Qué es minimax-music-ui
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
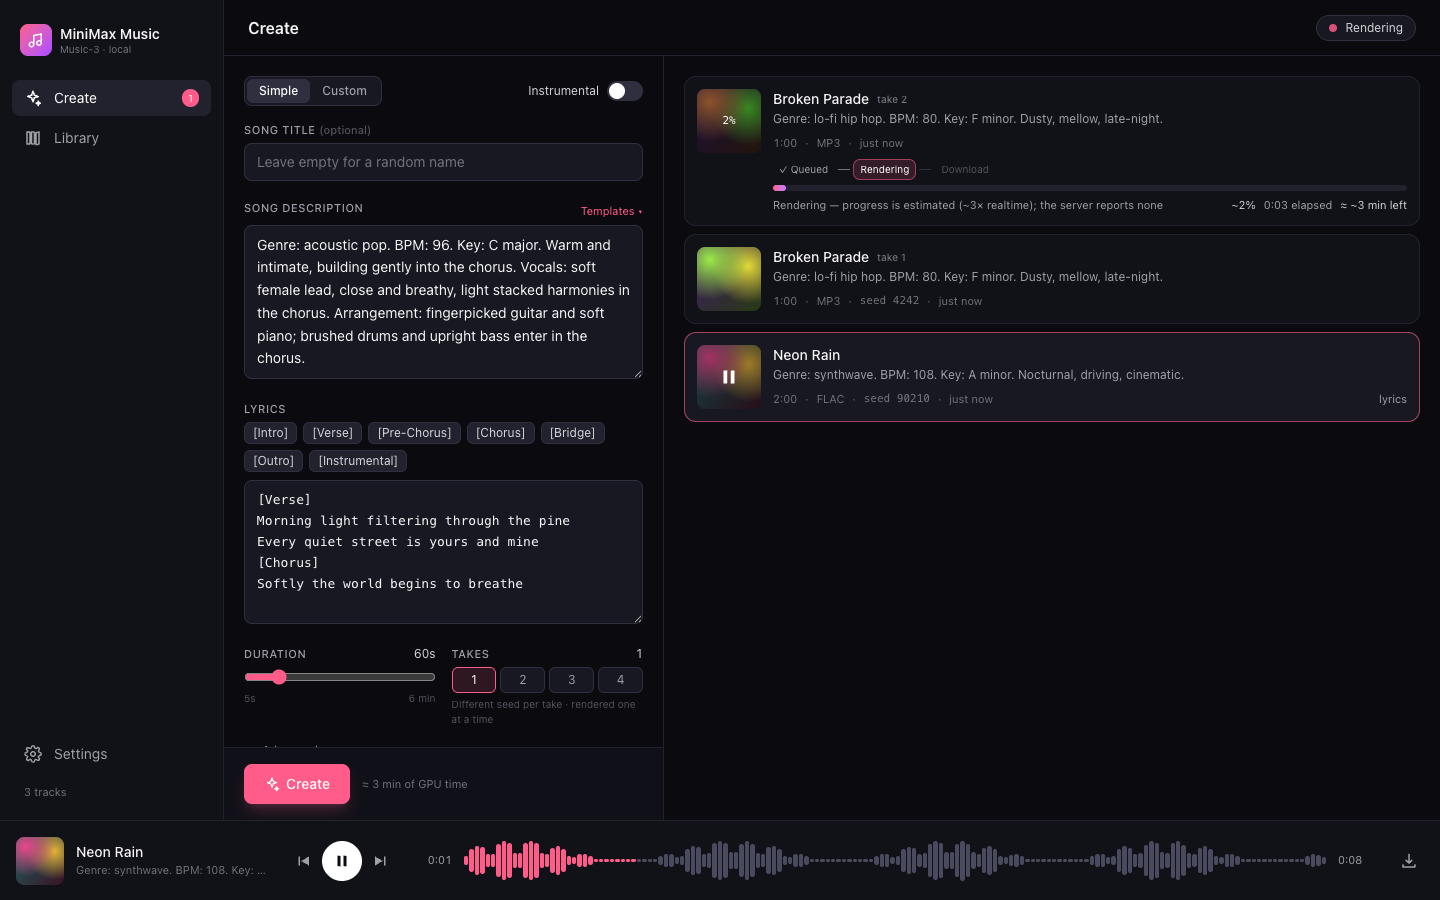
Este repositorio ofrece una interfaz web estilo Suno diseñada para un servidor de inferencia MiniMax-Music3 autoalojado. La aplicación utiliza React 19, Vite y Tailwind CSS 4 en el frontend, mientras que el backend está construido con Express 5 y TypeScript. Permite escribir prompts de estilo y letras, gestionar una cola de renders y mantener una biblioteca local con reproductor de ondas.
La arquitectura separa la UI (puerto 8787) del servidor de inferencia (por defecto 7862), proxyando las solicitudes a la ruta estándar POST /v1/audio/speech. Soporta streaming en vivo cuando el servidor lo anuncia, permitiendo reproducir mientras se genera. Incluye mejora automática de prompts mediante LLMs externos opcionales y persistencia de datos en directorios locales o volúmenes Docker.
Los requisitos incluyen Node.js 20+ para la UI y una GPU con ~24 GB VRAM para el modelo bundled. El despliegue es sencillo vía Docker, NPM o scripts Python, con soporte para variables de entorno para configurar la API del servidor de inferencia y modelos LLM externos sin tocar código.
- Generación musical local sin enviar datos a servicios en la nube
- Gestión de una biblioteca personal de pistas generadas con metadatos completos
- Experimentación con ingeniería de prompts y estilos musicales específicos
- Despliegue en infraestructura propia (self-hosted) para privacidad y control total
- Reproducción en vivo de audio mientras el modelo genera la pista
- Uso como interfaz web para servidores inference compatibles con sgl-omni
- Interfaz web responsiva estilo Suno con panel lateral y reproductor persistente
- Soporte nativo para streaming en tiempo real (SSE/PCM) cuando el servidor lo anuncia
- Mejora automática de prompts usando LLMs externos configurables vía API OpenAI-compatible
- Cola de renders persistente que sobrevive a reinicios del servidor UI
- Compatibilidad directa con MiniMax-Music3 y sgl-omni sin cambios en la API
- Persistencia local de biblioteca, plantillas y configuración en archivos JSON
- Requiere GPU con ~24 GB VRAM para ejecutar el modelo bundled incluido
- La salida predeterminada es WAV; formatos FLAC/MP3 aparecen pero están deshabilitados
- La mejora de prompts depende de un LLM externo configurado y no es obligatoria
- El servidor UI necesita acceso a la ruta POST /v1/audio/speech del backend inference
- No incluye el modelo por defecto; debe descargarse manualmente al iniciar el servidor bundled
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Usar Docker o NPM. Configurar MUSIC_API y DATA_DIR en entorno. Asegurar GPU para modelo bundled. Verificar puertos 8787 (UI) y 7862 (Inference). Para demo, usar imagen ghcr.io con modo read-only.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.