
lyra
Lyra es un asistente DevOps impulsado por voz que funciona localmente por defecto. Integra Ollama para LLMs, Whisper para reconocimiento de voz y Piper para síntesis.
Ficha actualizada 24 sept 2026, 1:50 · upstream 24 sept 2026, 1:33 · release v1.3.1
Qué es lyra
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
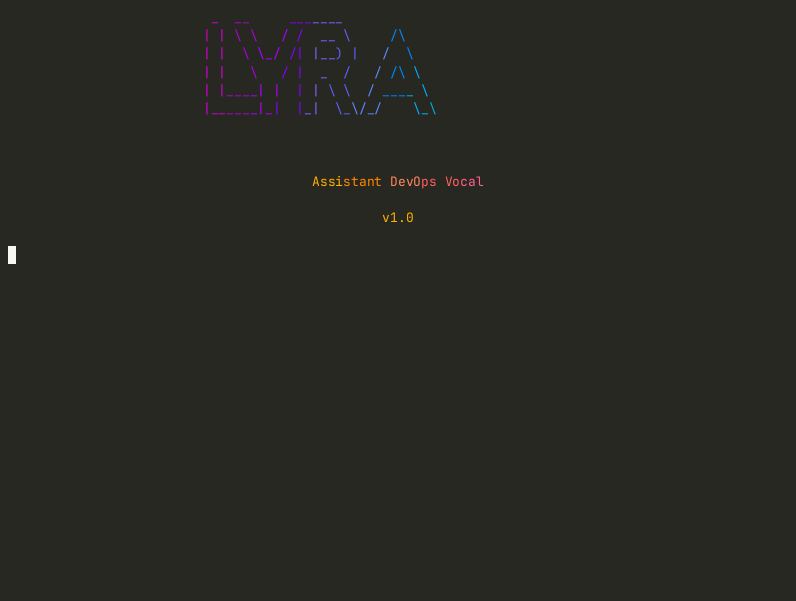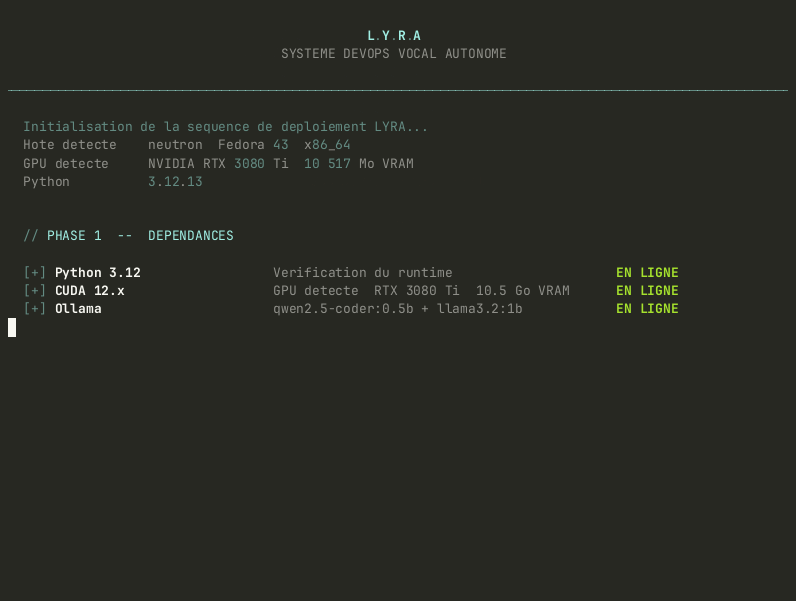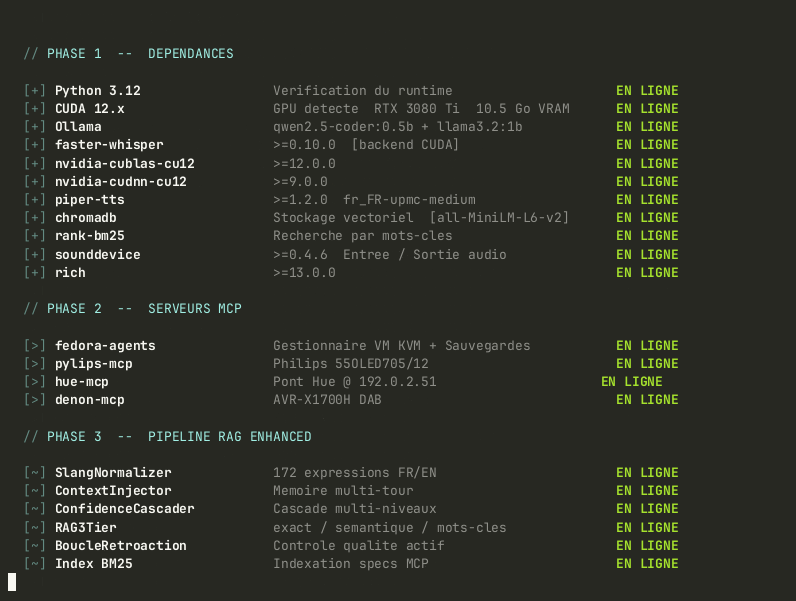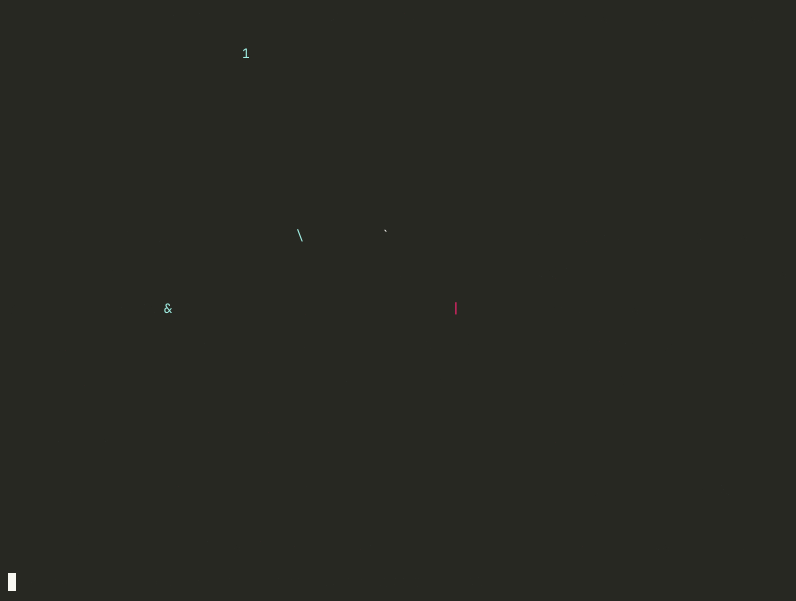
Lyra es un asistente DevOps autónomo y soberano diseñado para homelabs. Funciona localmente utilizando Ollama para modelos de lenguaje, faster-whisper para transcripción y Piper para voz. Su arquitectura incluye un demonio residente con socket Unix, pipeline RAG de tres niveles sobre especificaciones MCP y enrutamiento basado en reglas para evitar consultas innecesarias al LLM, logrando latencias inferiores a un segundo tras el arranque.
Gestiona tareas críticas como máquinas virtuales KVM (inicio, clonación, snapshots), copias de seguridad con Timeshift o Borg y control domótico (Hue, Chromecast, TV Philips). Cuenta con un modo vocal completo y un modo performance para automatización rápida en dispositivos seguros. La interfaz es nativa en Python 3.11+ y prioriza el francés, aunque soporta texto.
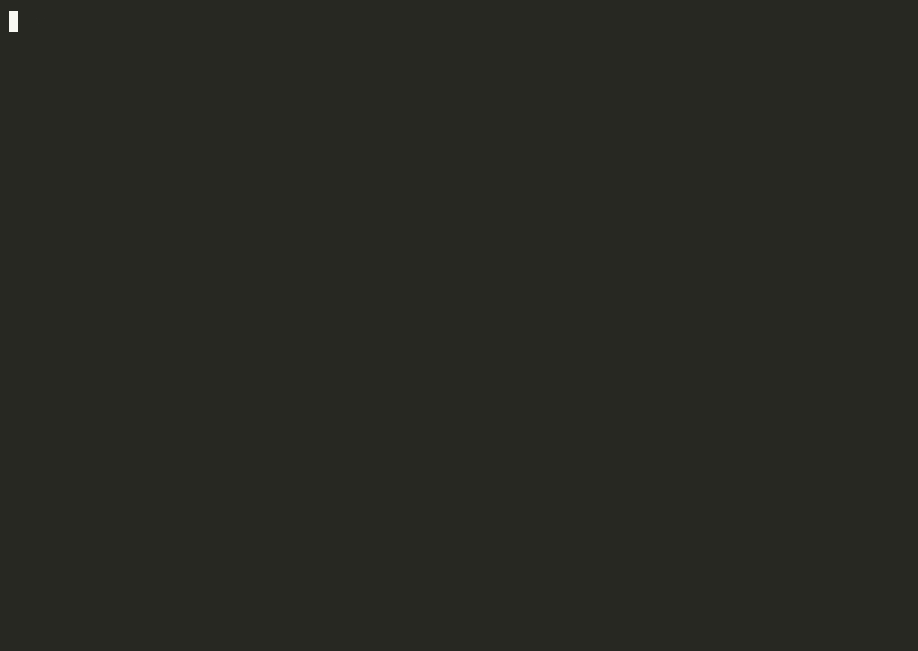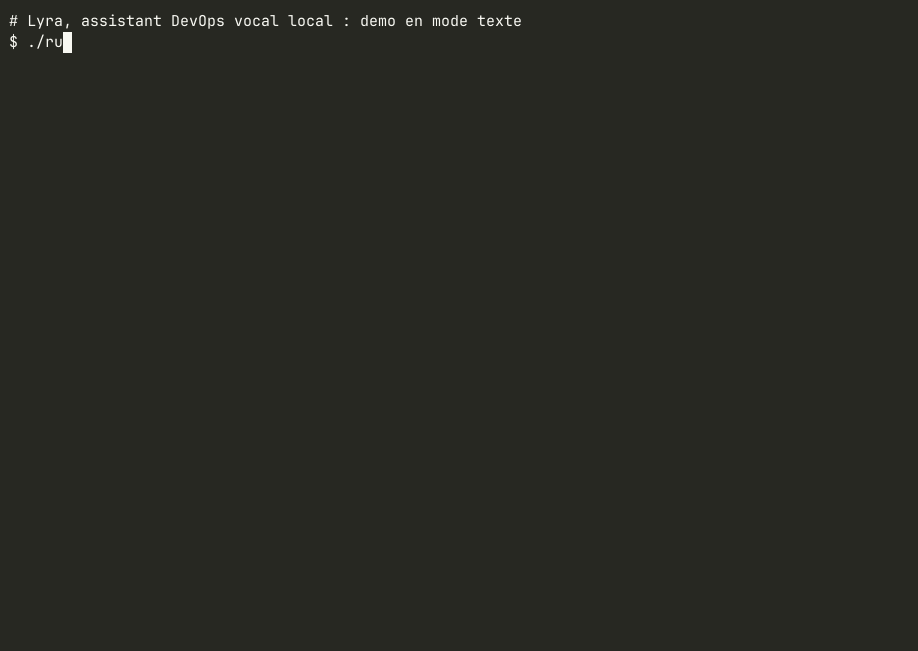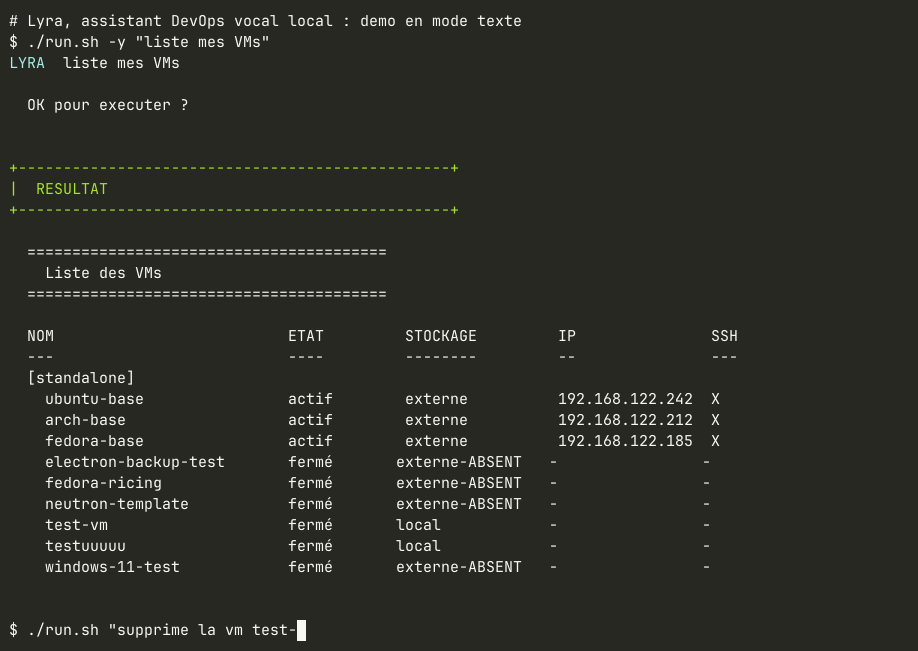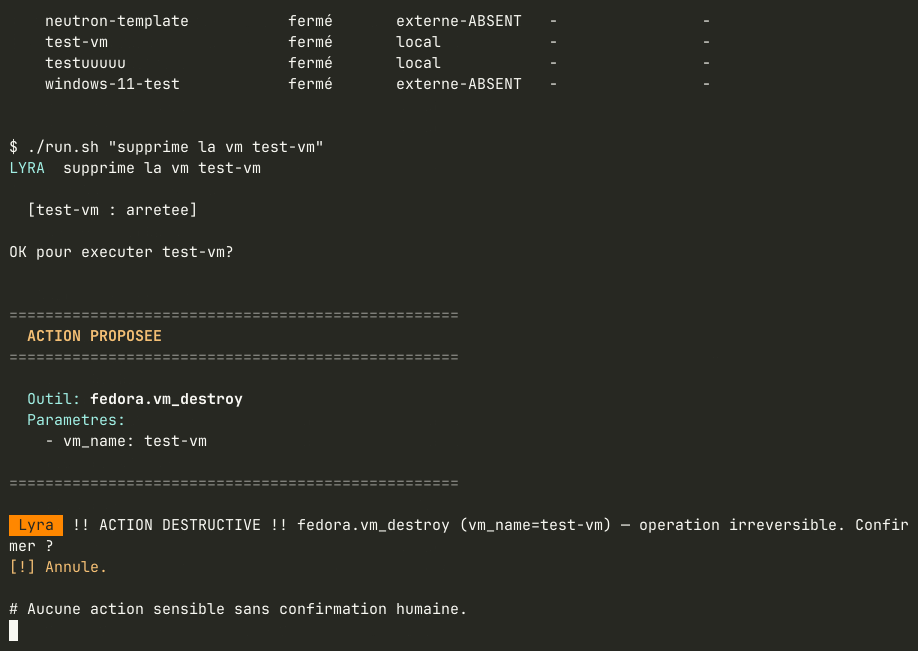
Su filosofía local-first evita facturas de API cloud. Implementa un bucle humano obligatorio para acciones destructivas o sensibles, como borrar VMs. Los datos no salen del equipo salvo configuraciones explícitas. Incluye mascottes ASCII animadas en el instalador y una PWA hermana llamada neutroncore para acceso web.
- Gestión de máquinas virtuales KVM (arrancar, clonar, snapshots)
- Automatización de copias de seguridad y restauración local
- Control domótico por voz (luces Hue, TV Philips, Chromecast)
- Asistente de terminal interactivo para scripts y comandos
- Monitorización de estado del sistema con confirmación humana
- Ejecución local sin API cloud por defecto (privacidad)
- Latencia <1s tras inicializar el demonio residente
- Confirmación humana obligatoria para acciones sensibles
- Soporte nativo para Python 3.11+ y múltiples distros Linux
- Pipeline RAG de tres niveles sobre especificaciones MCP
- Instalador interactivo TUI con mascottes ASCII animadas
- Requiere Python 3.11+ y al menos 8GB RAM
- Depende de Ollama local o remoto para modelos LLM
- Interfaz principal en francés (aunque soporta texto)
- No incluye GPU dedicado por defecto (funciona en CPU)
- Requiere configuración de servidores MCP externos que no se instalan automáticamente
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Instalar con ./installer/install.sh para detectar distro y crear venv. Usar --ollama-host si no hay GPU local. Verificar reglas sudo generadas automáticamente. Para producción, considerar modelos más pesados en config.yaml.example. Asegurar acceso a micrófono/salida de audio para modo vocal. Requiere Python 3.11+ y 8GB RAM mínimo.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.