
LocalLLMServerManager
LocalLLMServerManager es un gestor de orquestación local para modelos de IA (Ollama, Stable Diffusion Forge/ComfyUI, Kokoro TTS) con API MCP nativa, dashboard en Avalonia UI y gestión automática de VRAM GPU. Soporta Windows/Linux, despliegue headless como servicio y acceso remoto vía WebAssembly.
Ficha actualizada 29 sept 2026, 1:24 · upstream 29 sept 2026, 1:12 · release v3.16.0
Qué es LocalLLMServerManager
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
LocalLLMServerManager es un servicio .NET/C# que orquesta motores locales de IA: Ollama para LLMs, Stable Diffusion Forge y ComfyUI para generación de imágenes/video/3D, y Kokoro TTS para síntesis de voz. Incluye API REST en puerto 5246 con proxy inverso YARP, servidor MCP oficial (especificación 2026-07-28) en /mcp, y orquestador automático de VRAM que libera modelos inactivos antes de cargas pesadas.
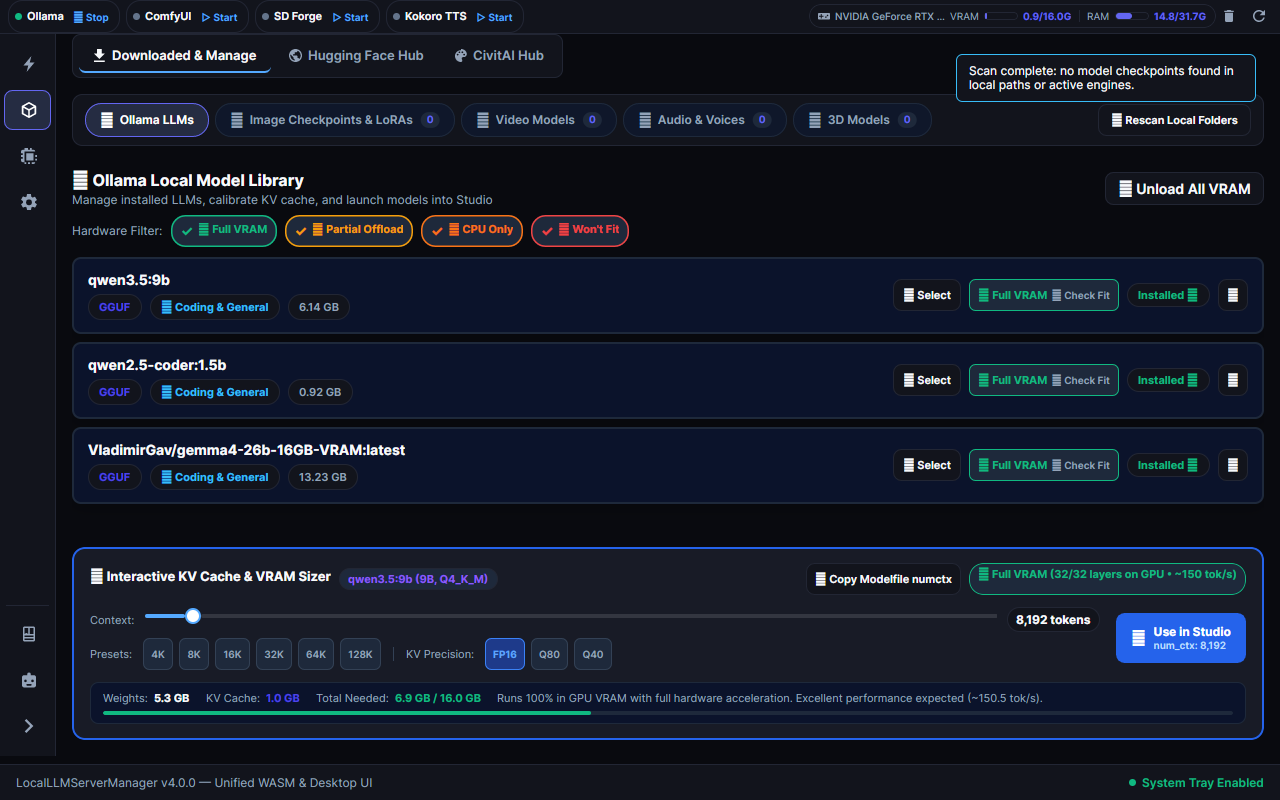
La interfaz usa Avalonia UI con tema Matte Carbon (#0F172A), ventanas acompañantes magnéticas y calculadora interactiva de contexto KV cache. Soporta descubrimiento automático de herramientas, búsqueda en Hugging Face GGUF y CivitAI, y validación de rutas multi-unidad con badges de estado.
Arquitectura dual-sesión: servicio headless (Windows Service/systemd) que inicia antes del logon, y cliente System Tray que se adjunta automáticamente. Incluye paquetes modulares (--with-video, --with-audio), cliente WebAssembly para acceso remoto, y framework Playwright para pruebas E2E.
- Orquestar múltiples motores de IA locales (Ollama, ComfyUI, Forge, Kokoro) desde un único dashboard con telemetría en tiempo real de VRAM GPU
- Integrar modelos locales con asistentes AI vía Model Context Protocol (MCP) para Claude Desktop, Cursor, Antigravity y agentes autónomos
- Gestionar descargas de modelos GGUF desde Hugging Face y checkpoints de difusión desde CivitAI con filtrado por categoría y streaming directo a disco
- Ejecutar generación multimodal: imágenes (Stable Diffusion), video (Wan 2.2, LTX-2.5, HunyuanVideo), audio (Kokoro TTS, Stable Audio Open) y mallas 3D (TRELLIS V2, Hunyuan3D)
- Operar en modo headless como servicio de Windows o systemd en Linux con acceso remoto vía cliente WebAssembly y SSH port forwarding
- API MCP nativa con 11 herramientas oficiales (get_gpu_vram, check_health, list_models, pull_model, unload_vram, start_engine, stop_engine, detect_tools, generate_video, synthesize_speech, generate_audio)
- Orquestador automático de VRAM que monitorea memoria GPU vía NVML CUDA y libera modelos inactivos para evitar OOM en cargas pesadas
- Interfaz Avalonia UI con ventanas acompañantes magnéticas, calculadora interactiva de KV cache y telemetría en tiempo real de hardware
- Arquitectura dual-sesión: servicio headless que inicia antes del logon y cliente System Tray que se adjunta automáticamente al inicio de sesión
- Descubrimiento automático de herramientas con escaneo multi-unidad, validación de rutas y badges de estado (Valid/Missing)
- Paquetes modulares opcionales (--with-video, --with-audio) para instalar funcionalidades específicas y preservar espacio en disco
- Requiere GPU con soporte CUDA/NVML para telemetría VRAM precisa; AMD ROCm tiene limitaciones de detección
- Algunas funcionalidades multimodales (video, audio) dependen de extensiones opcionales que deben instalarse explícitamente
- El cliente WebAssembly requiere configuración manual de SSH port forwarding para acceso remoto seguro
- Dependencia de motores externos (Ollama, ComfyUI, Forge, Kokoro) que deben estar previamente instalados y configurados
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Instalar como Windows Service (--service) o systemd daemon en Linux. Asegurar puertos 5246 (API), 11434 (Ollama), 7860 (Forge), 8188 (ComfyUI), 8880 (Kokoro). Crear reglas de firewall para LAN/MCP endpoints. Instalar paquetes modulares con --with-video o --with-audio según necesidades. Para acceso remoto, configurar SSH port forwarding al puerto 5246.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.