
local-llmup
Herramienta nativa en Rust que verifica qué LLMs locales pueden ejecutarse en tu hardware antes de descargarlos. Proporciona veredictos yes/slow/no, estimaciones de tok/s y gestión de modelos para Ollama, llama.cpp, MLX y LM Studio con CLI, TUI y GUI.
Ficha actualizada 26 sept 2026, 19:57 · upstream 26 sept 2026, 19:44 · release v0.11.3
Qué es local-llmup
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
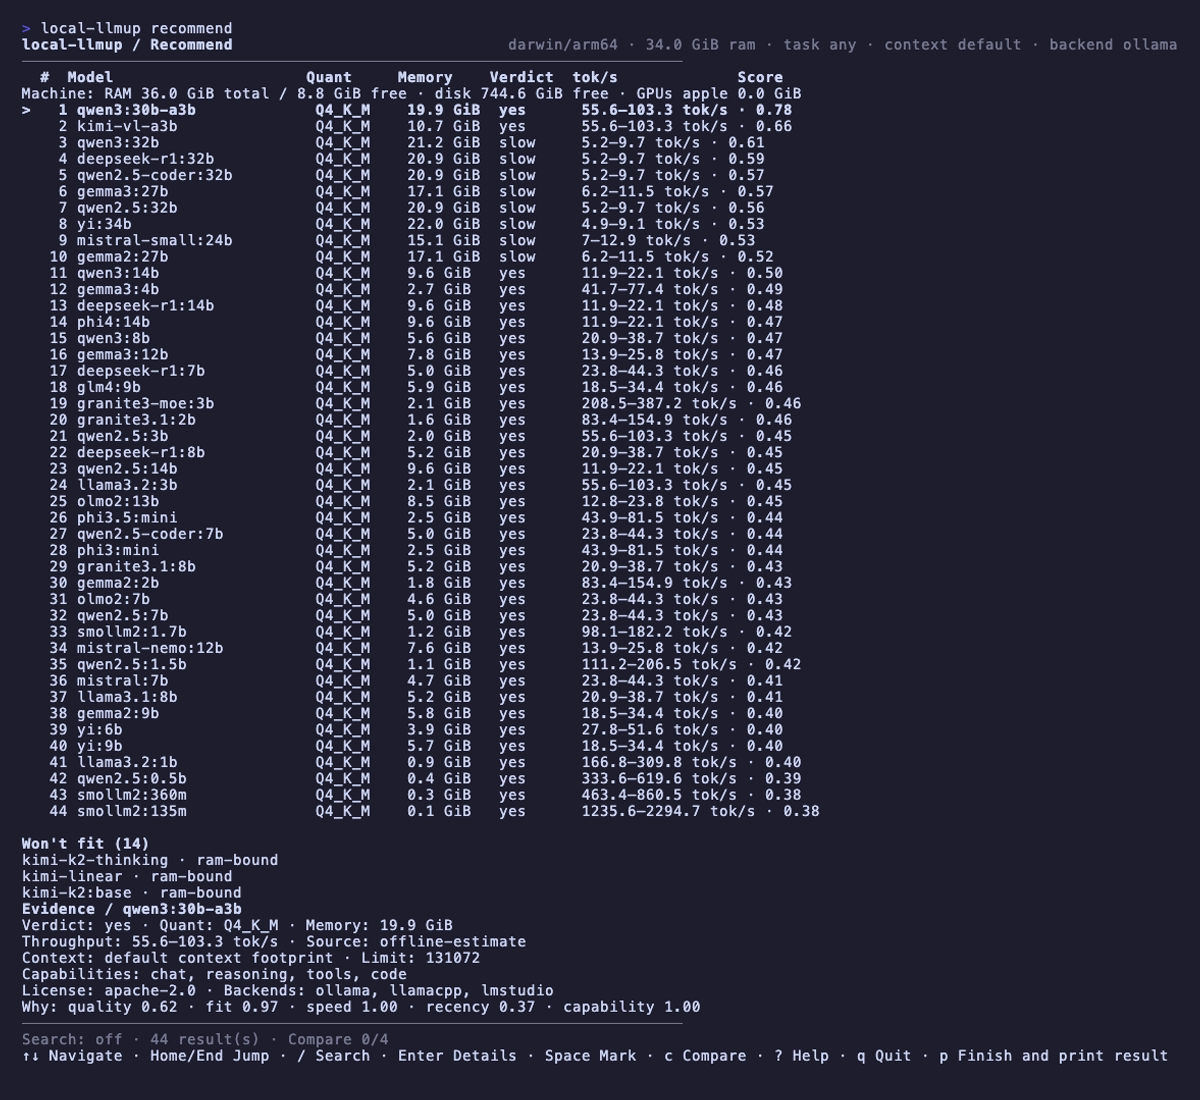
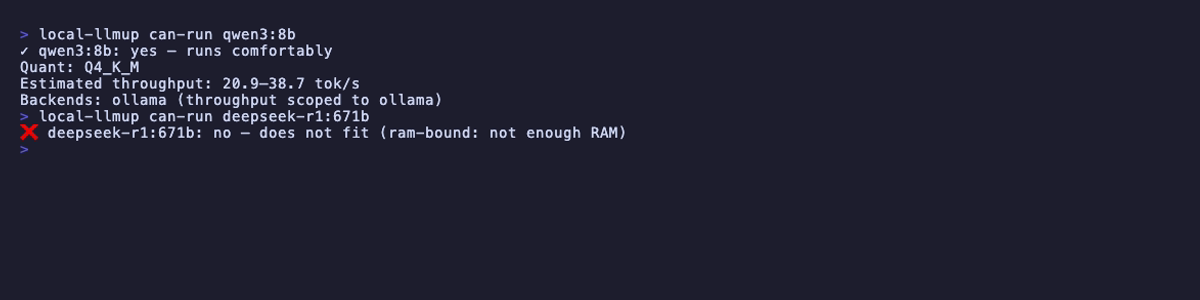
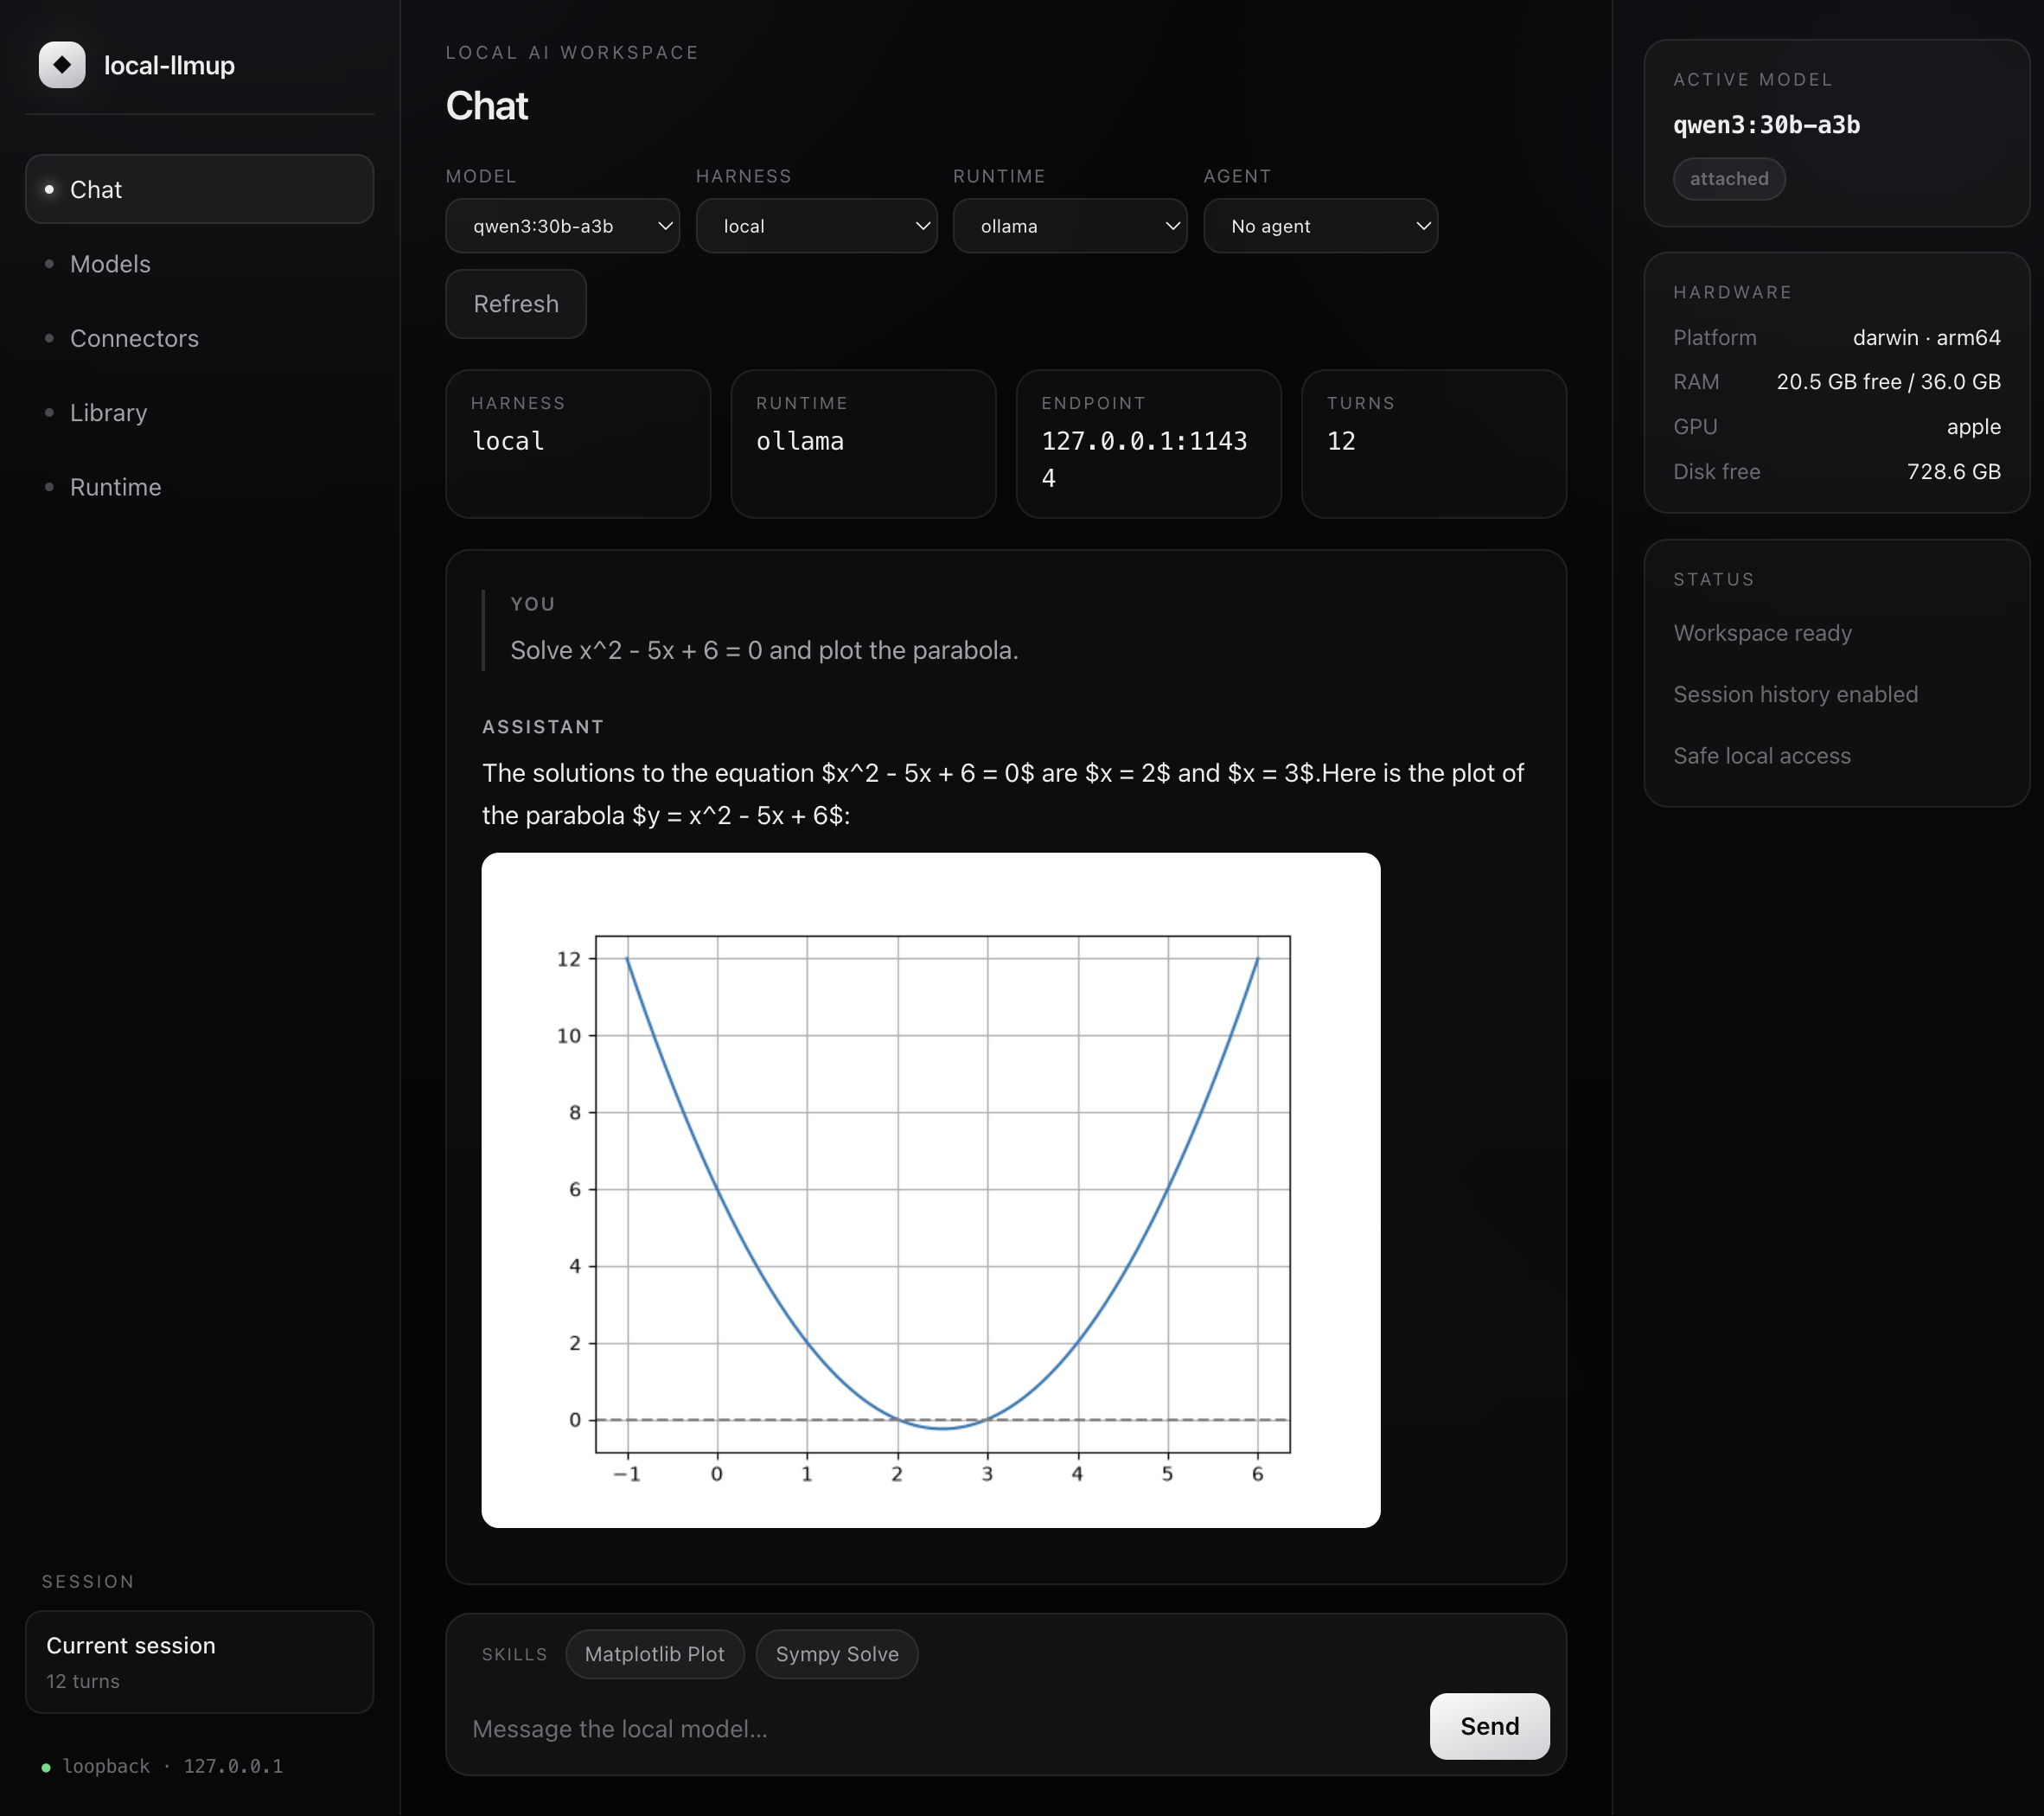
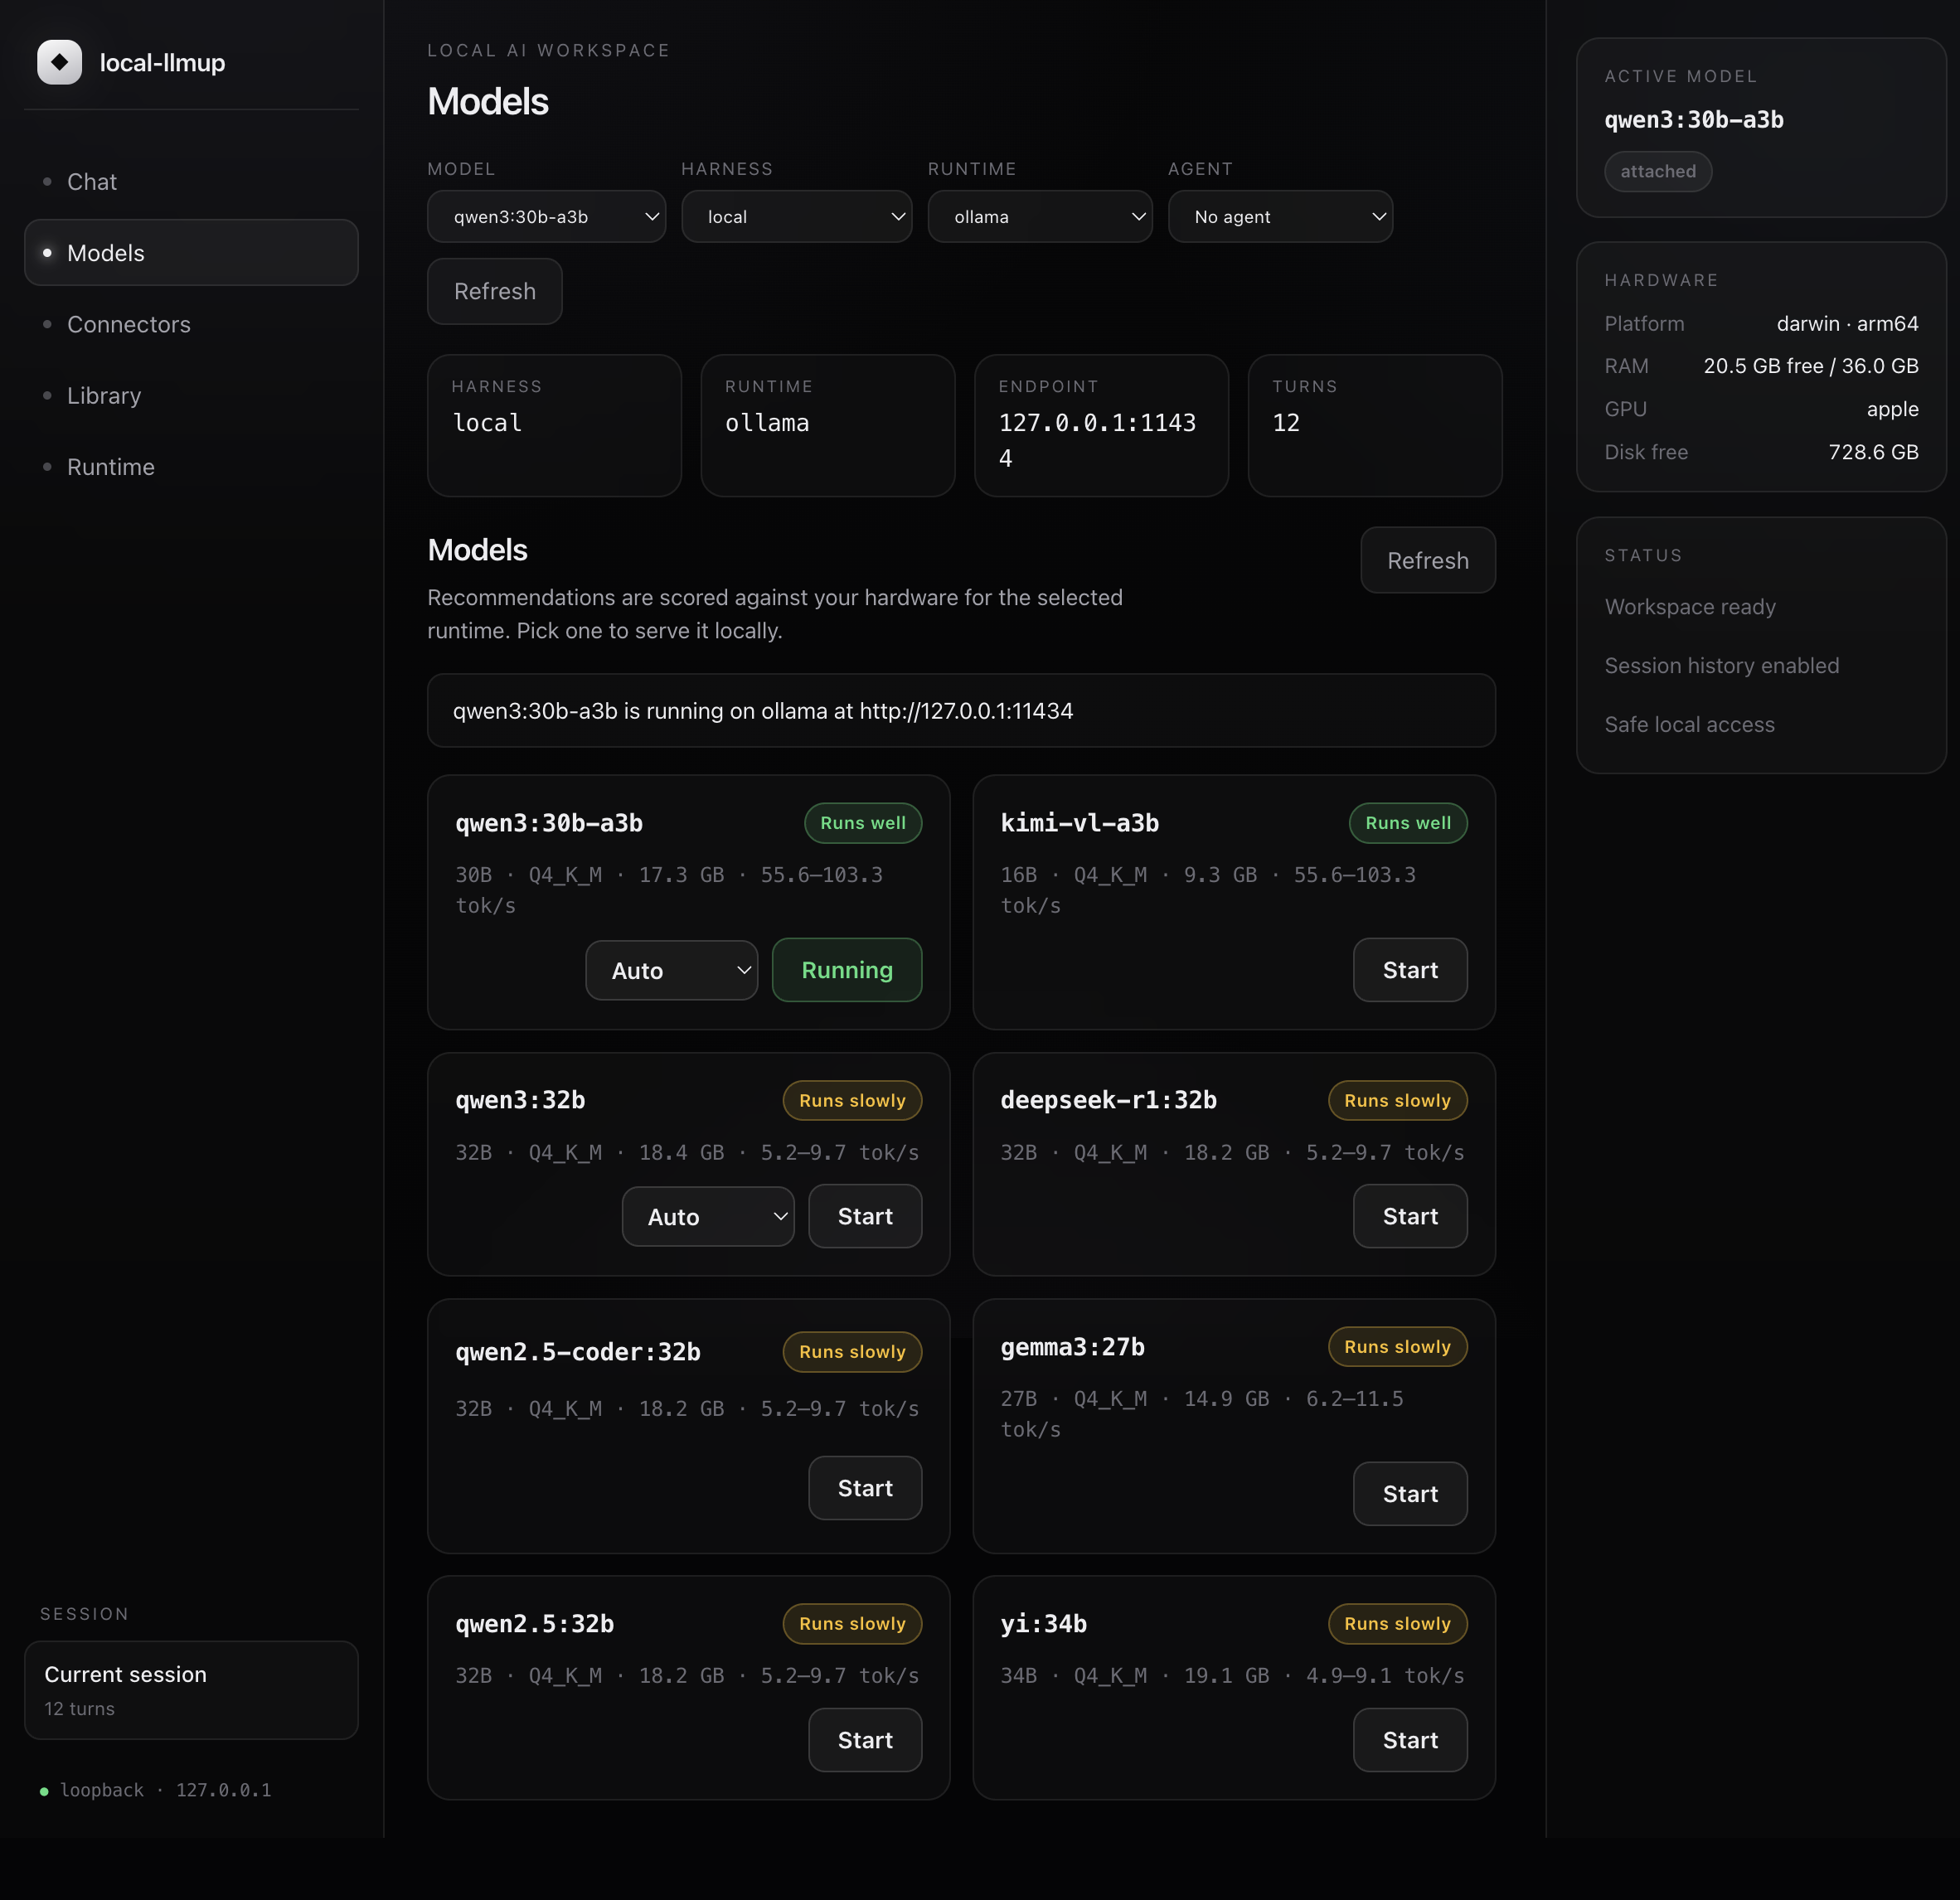
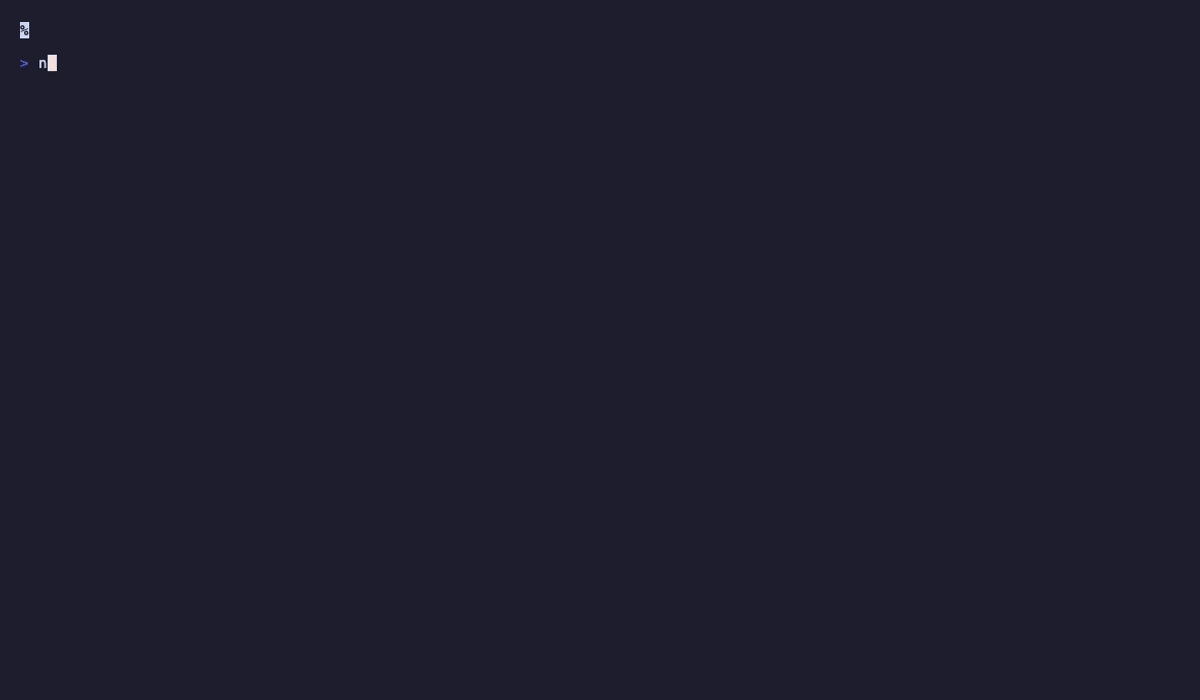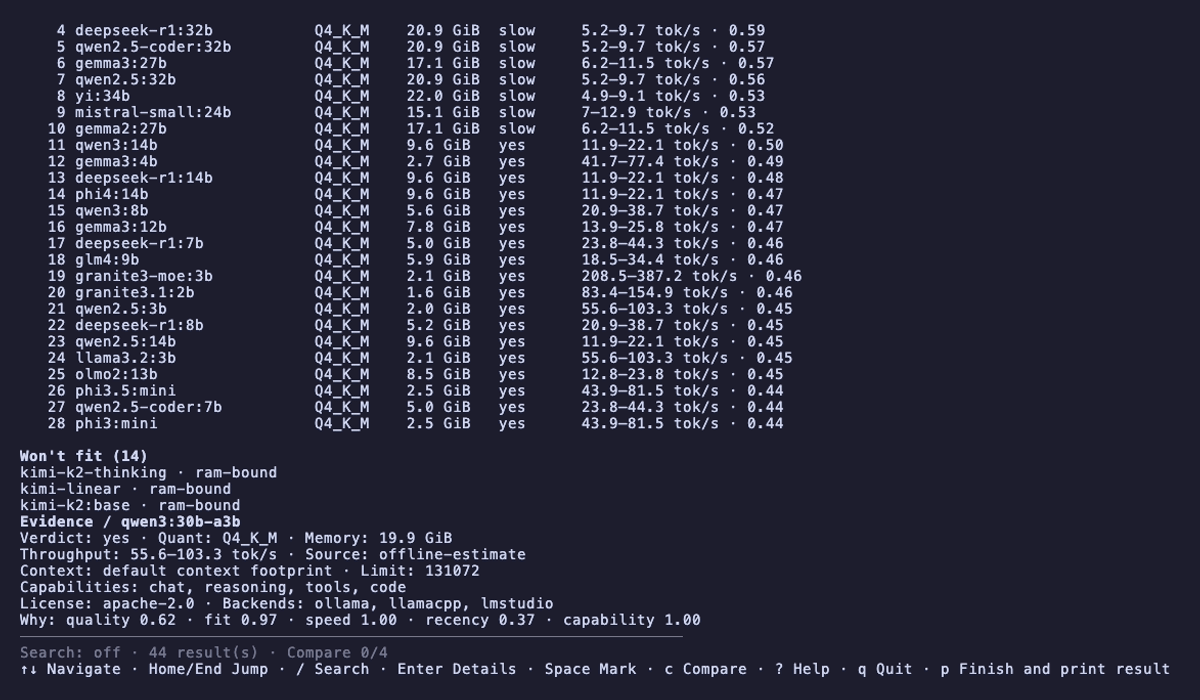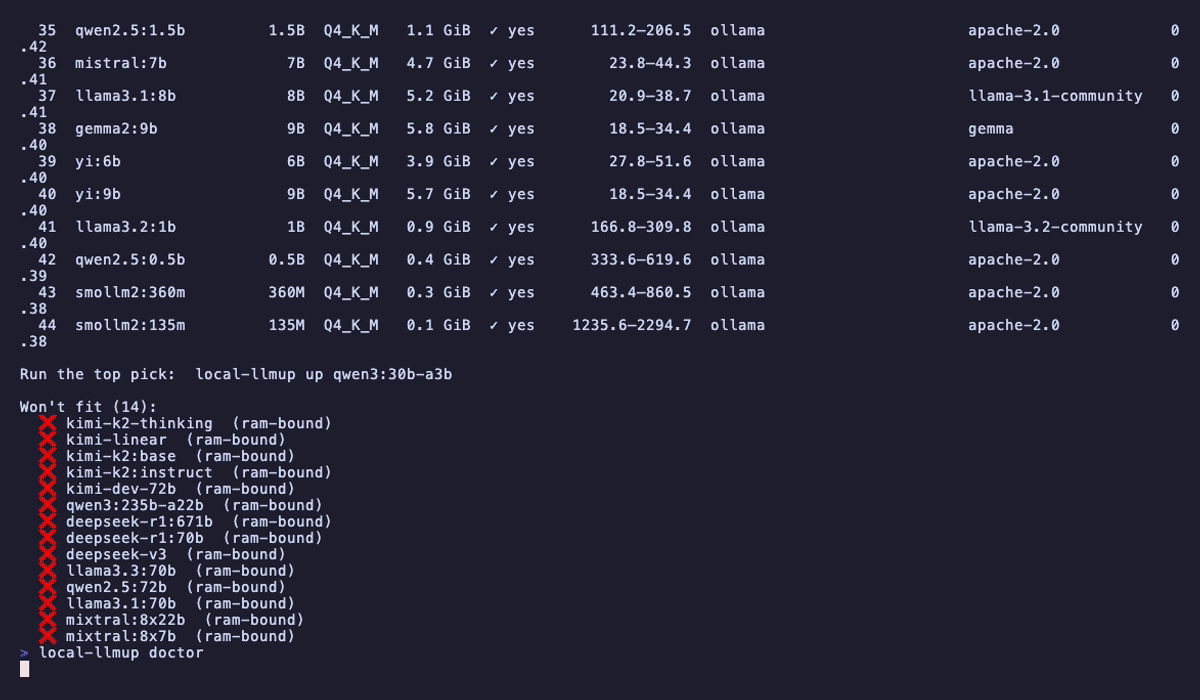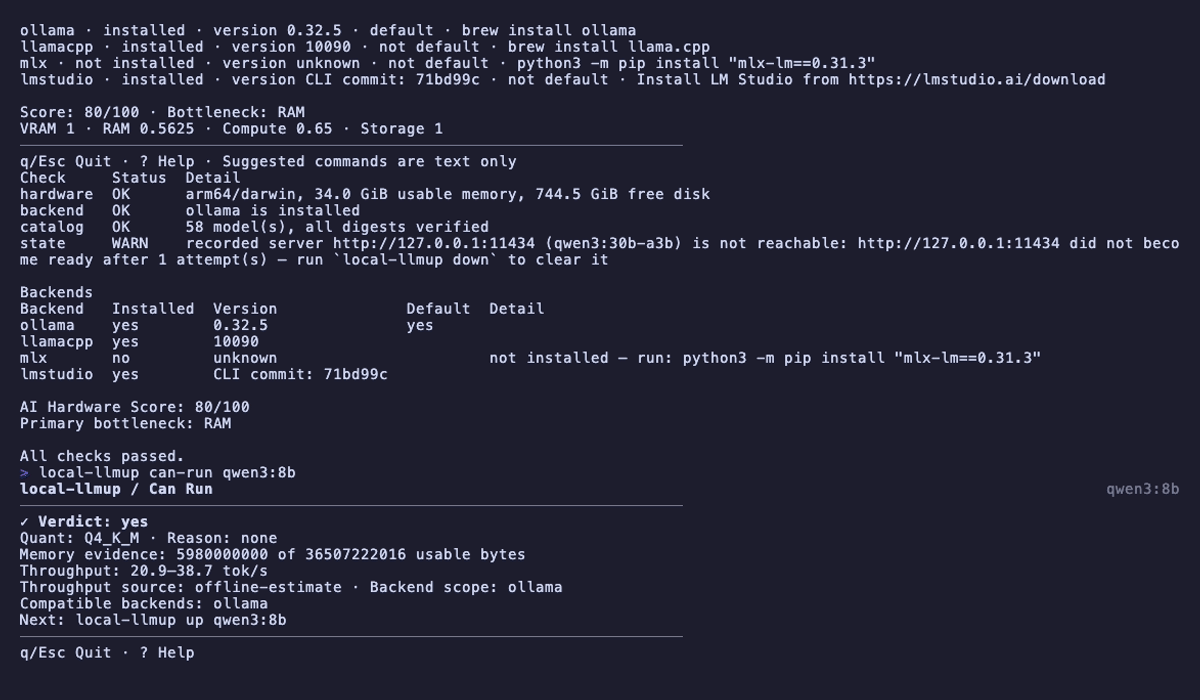
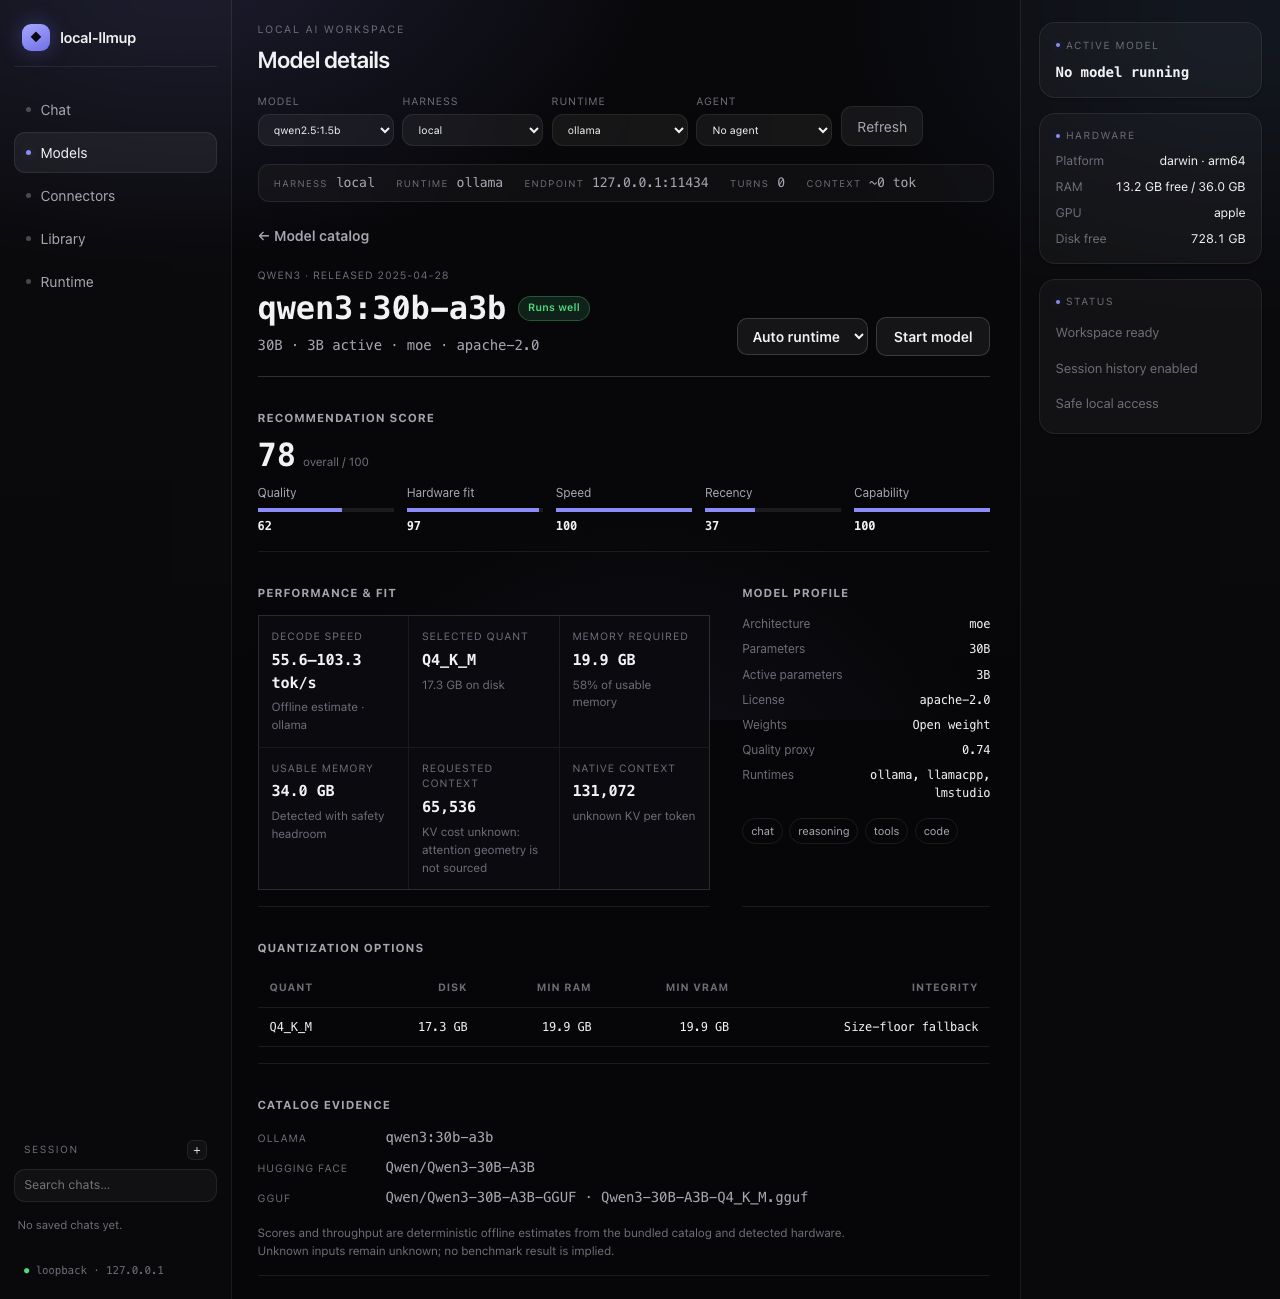
local-llmup es una herramienta de hardware-aware para LLMs locales que determina qué modelos pueden ejecutarse en tu máquina antes de descargarlos. Analiza GPU VRAM, memoria unificada, RAM y disco para dar veredictos yes/slow/no con estimaciones de tokens por segundo. Incluye CLI nativa en Rust, interfaz TUI accesible y GUI web loopback-only.
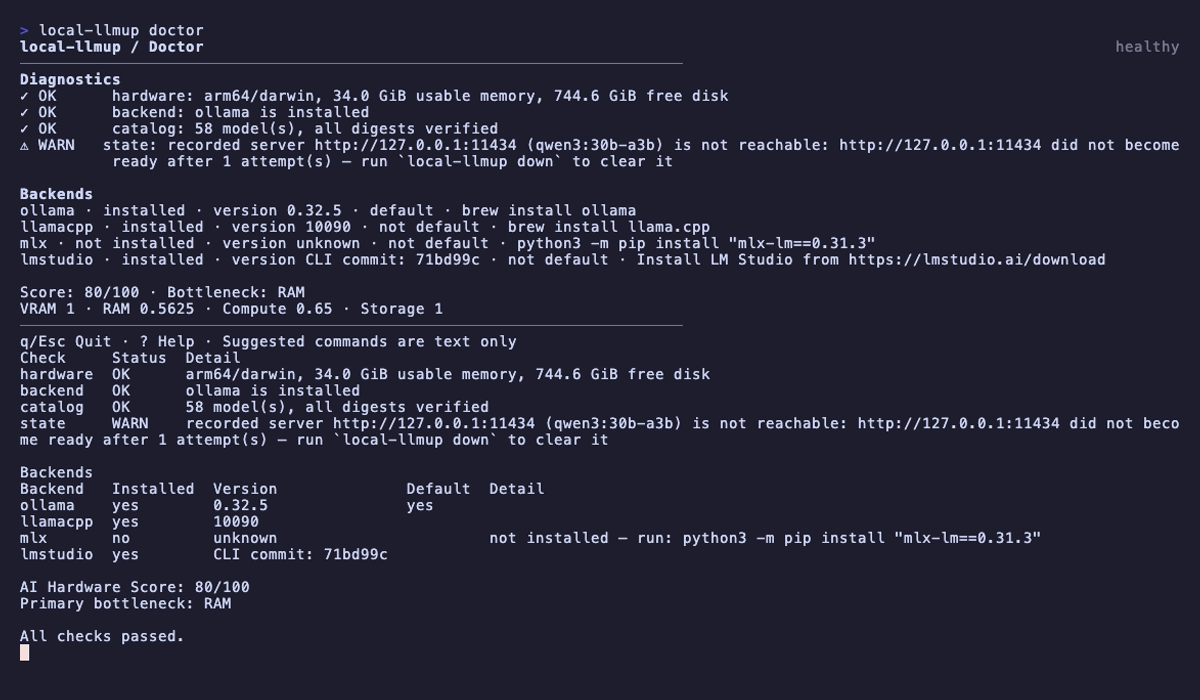
La herramienta soporta cuatro backends: Ollama (recomendado), llama.cpp, MLX (Apple Silicon) y LM Studio (attach-only). Verifica integridad con SHA-256, gestiona migración de memoria entre modelos y ofrece puntuación AI Hardware Score 0–100 para diagnosticar cuellos de botella. El catálogo curado incluye 66 variantes de modelos con metadata conservadora.
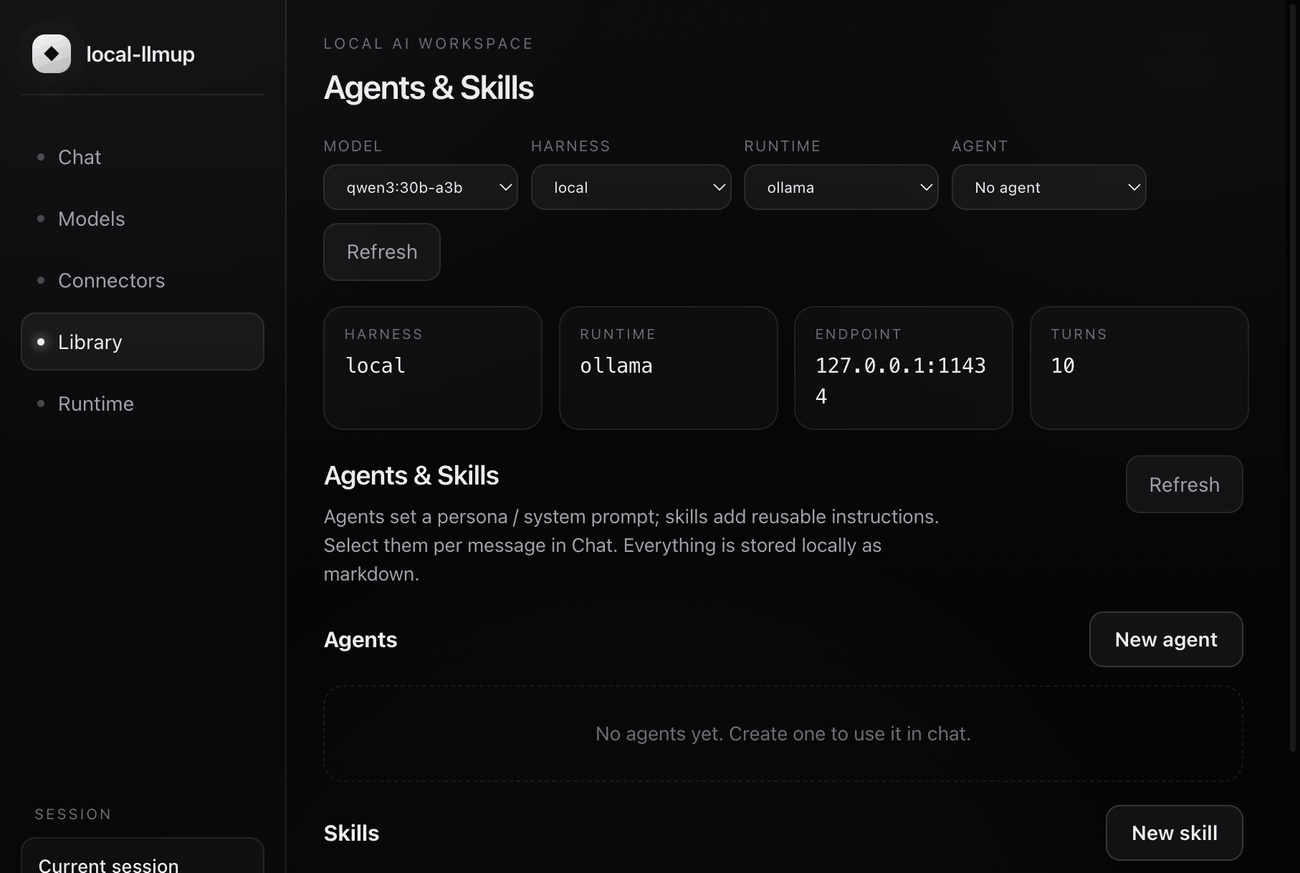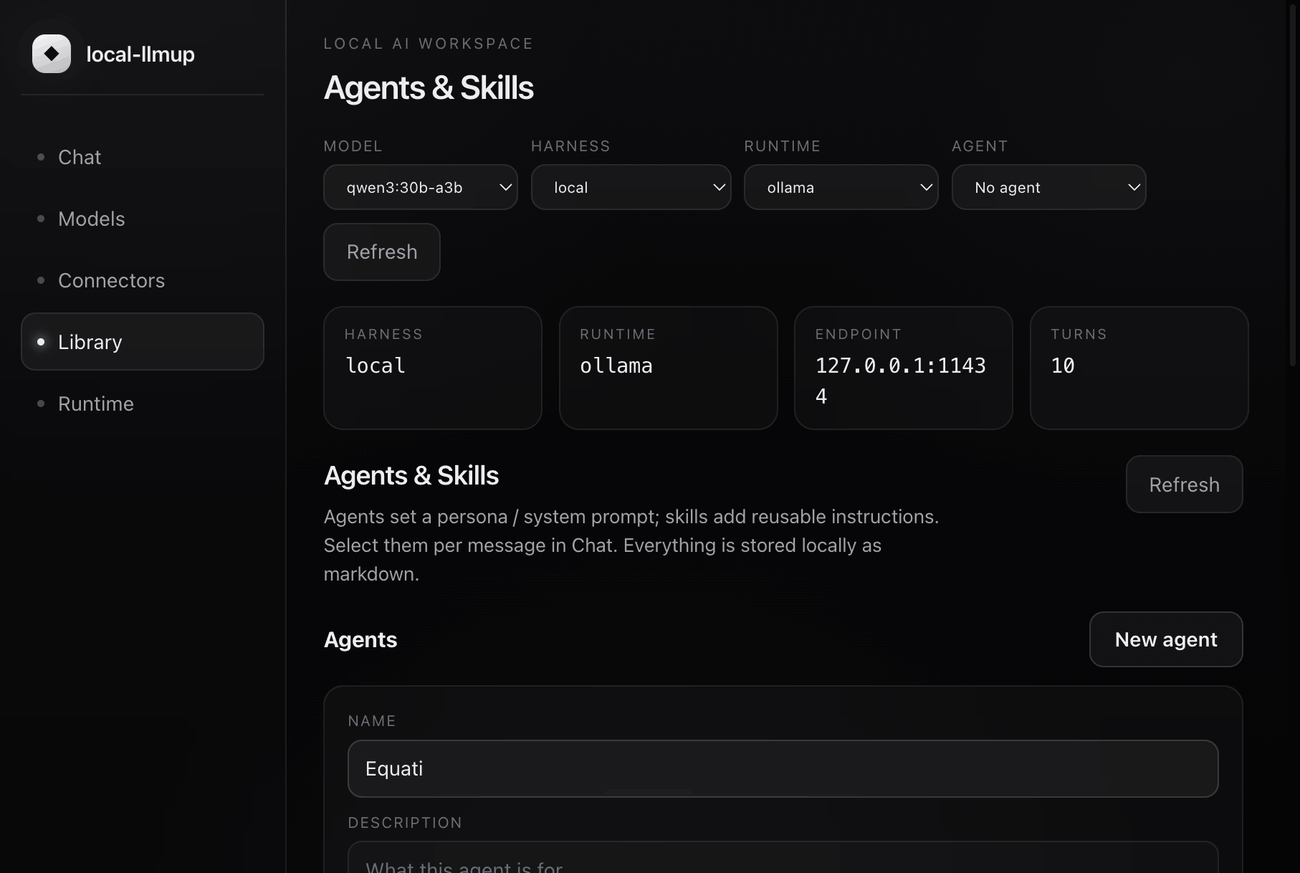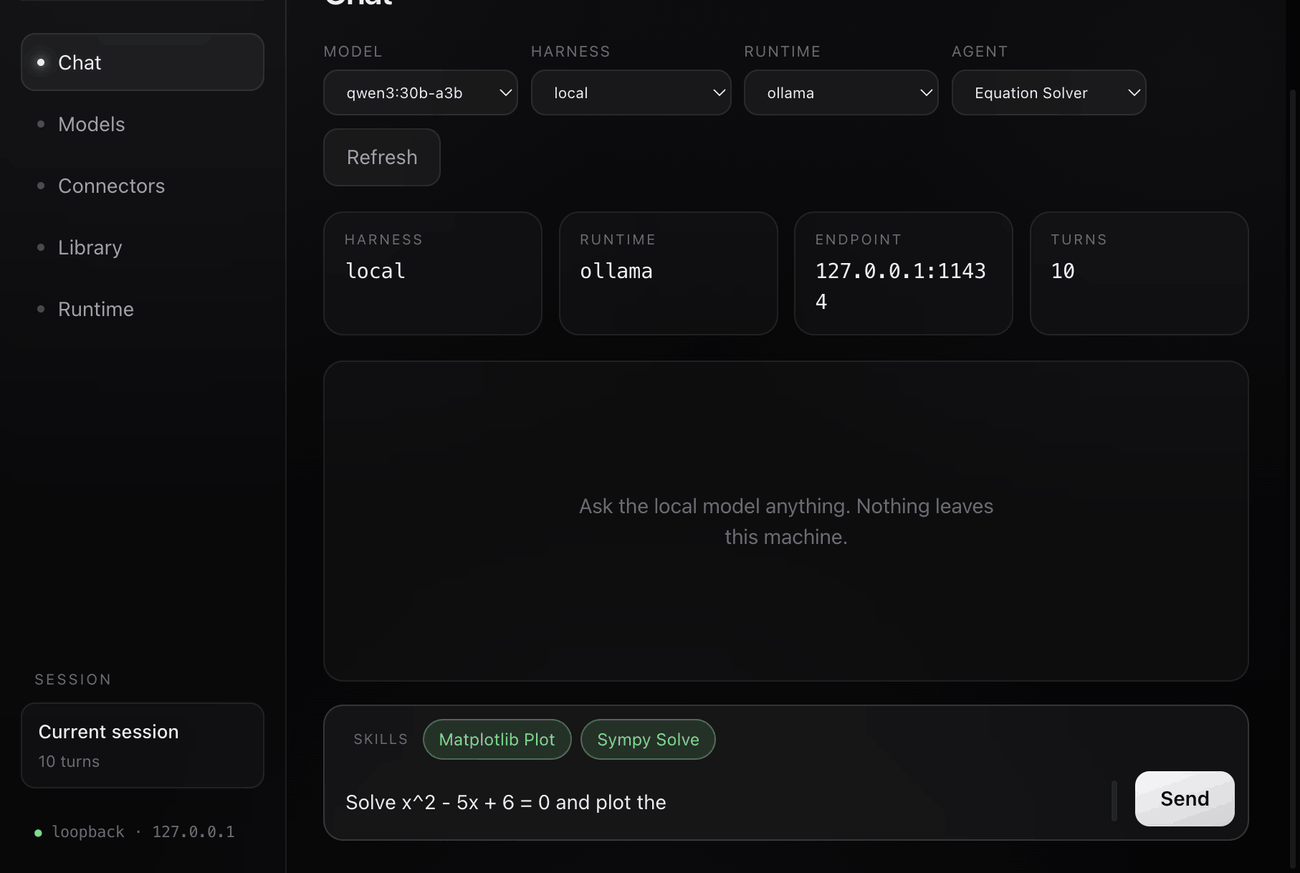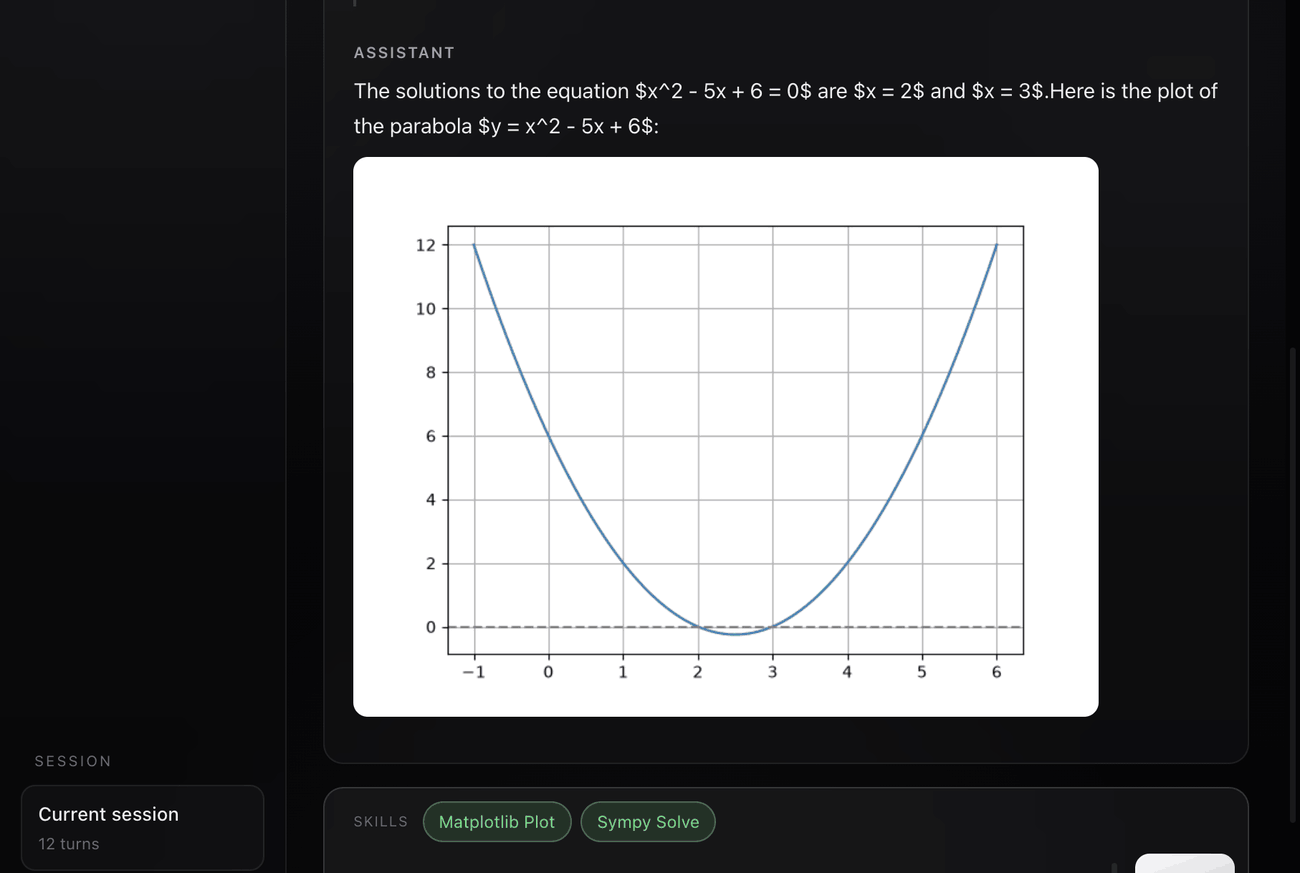
Funcionalidades clave incluyen agentes reutilizables con MCP connectors, renderizado inline de imágenes/gráficos, context-window sizing con corrección GQA-correct y salida machine-readable (--json). La versión 1.0 nativa en Rust muestra mejoras de rendimiento respecto a la versión anterior en Node.js.
- Verificar compatibilidad hardware antes de descargar modelos LLM locales
- Gestionar ciclo de vida completo: pull, verify, serve, chat, migrate, switch
- Desplegar workspace local de IA con chat y herramientas MCP en loopback-only
- Migrar memoria de chat entre modelos para mantener contexto histórico
- Diagnosticar cuellos de botella hardware con AI Hardware Score 0–100
- Scripting automatizado con salida JSON y códigos de salida limpios
- Veredictos yes/slow/no con estimación tok/s antes de cualquier descarga
- Integridad verificada con SHA-256, fail-closed en mismatch
- Solo loopback (127.0.0.1), nada expuesto a red externa
- Migración portable de memoria entre modelos vía migrate
- 4 backends soportados: Ollama, llama.cpp, MLX, LM Studio
- Catálogo curado offline con 66 variantes y metadata conservadora
- Requiere backend instalado (Ollama/llama.cpp/MLX/LM Studio) para lifecycle commands
- Docker solo histórico, no hay Docker Compose ni imagen nativa publicada
- Catálogo requiere revisión manual de repositorios, no es automático
- Figuras desconocidas se muestran como unknown, nunca fabricadas
- Archivos precompilados sin firma en macOS requieren quitar quarantine
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Instala vía Homebrew (macOS/Linux), Cargo o archivos precompilados. Para lifecycle commands necesitas backend instalado: Ollama recomendado, llama.cpp vía brew, MLX solo Apple Silicon con pip, LM Studio attach-only. Usa native installation para recomendaciones precisas de hardware. Archivos sin firmar en macOS requieren xattr -dr com.apple.quarantine. GUI y CLI usan ~/.local-llmup para estado.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.