
lm-warden
LM Warden es un plano de control autoalojado compatible con la API OpenAI que gestiona motores de inferencia LLM (vLLM y llama.cpp) detrás de una única interfaz web y puerto.
Ficha actualizada 25 sept 2026, 3:19 · upstream 25 sept 2026, 3:09 · release sin release detectada
Qué es lm-warden
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
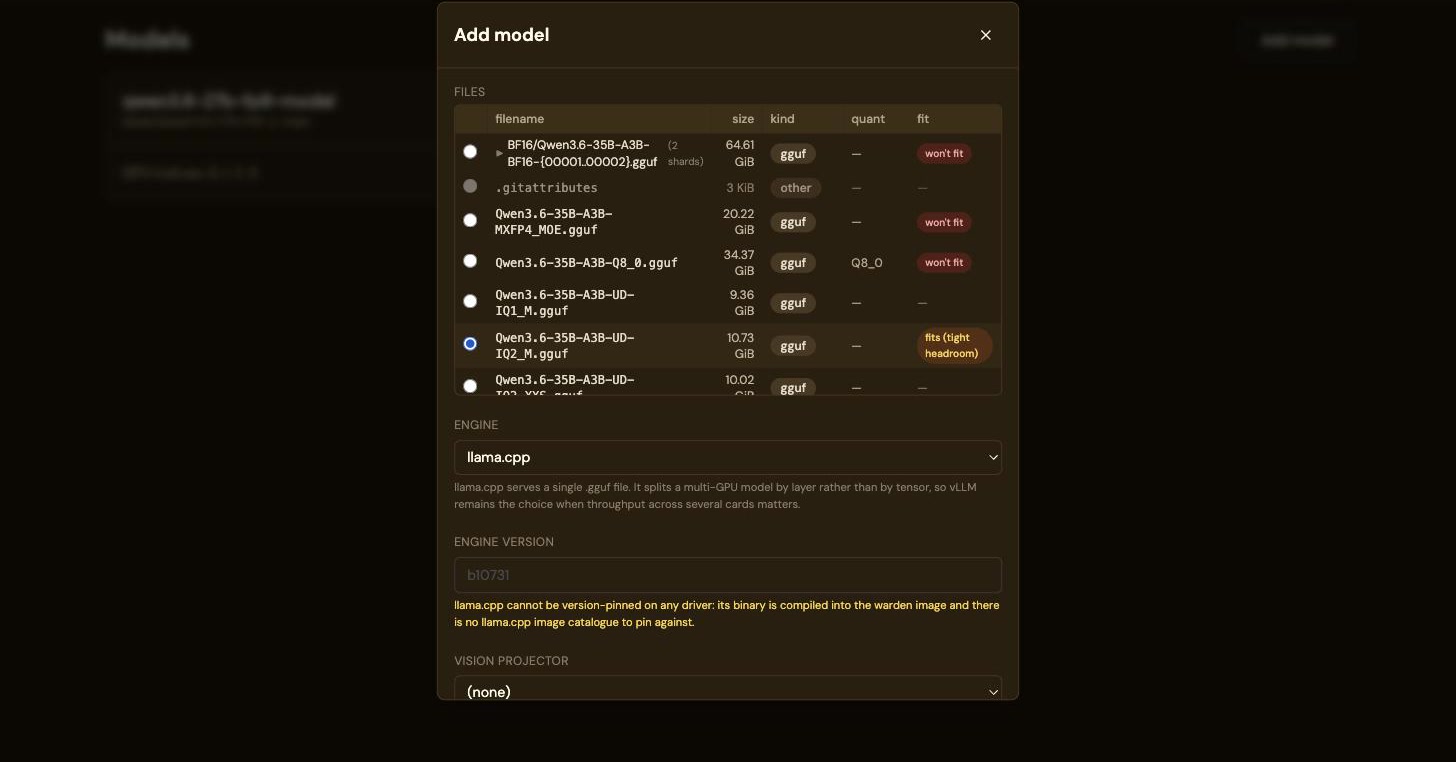
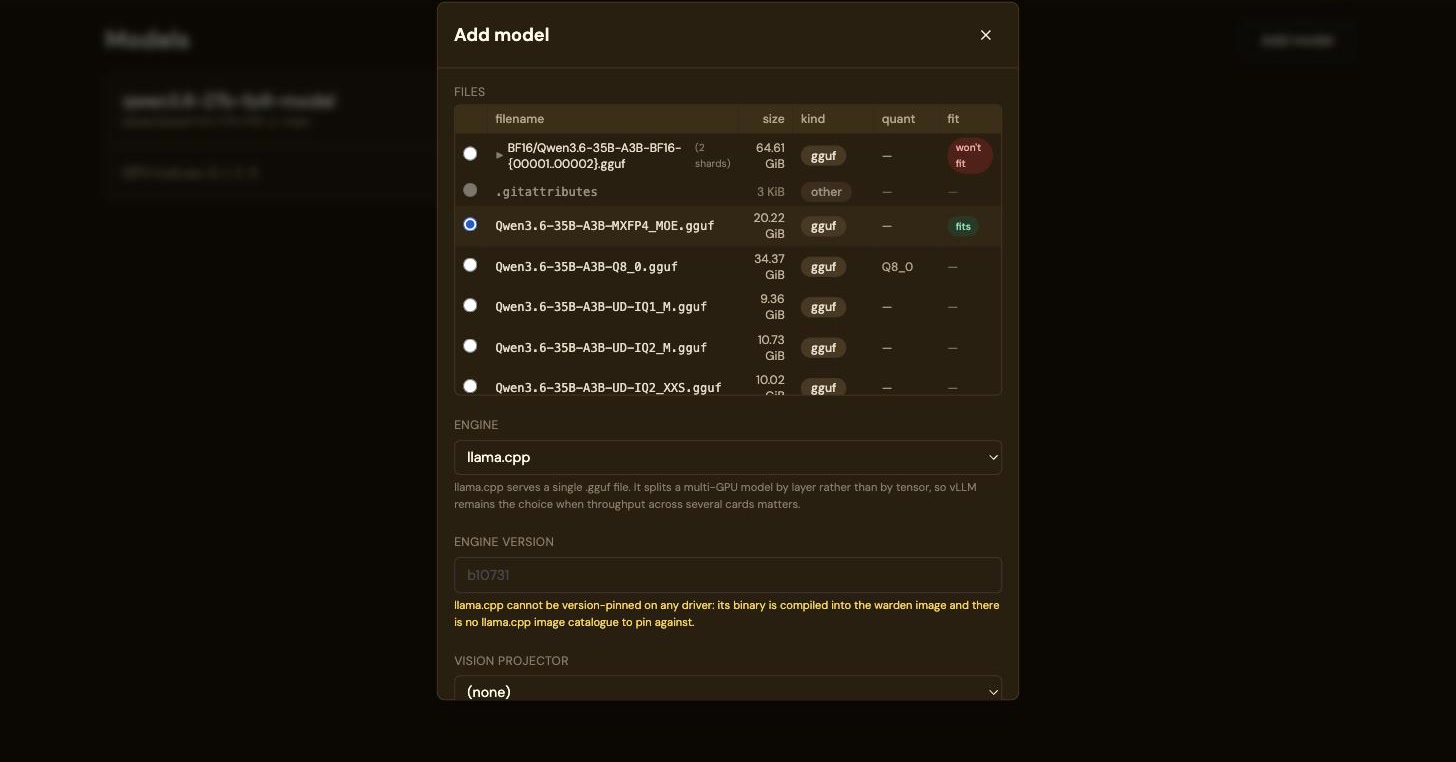
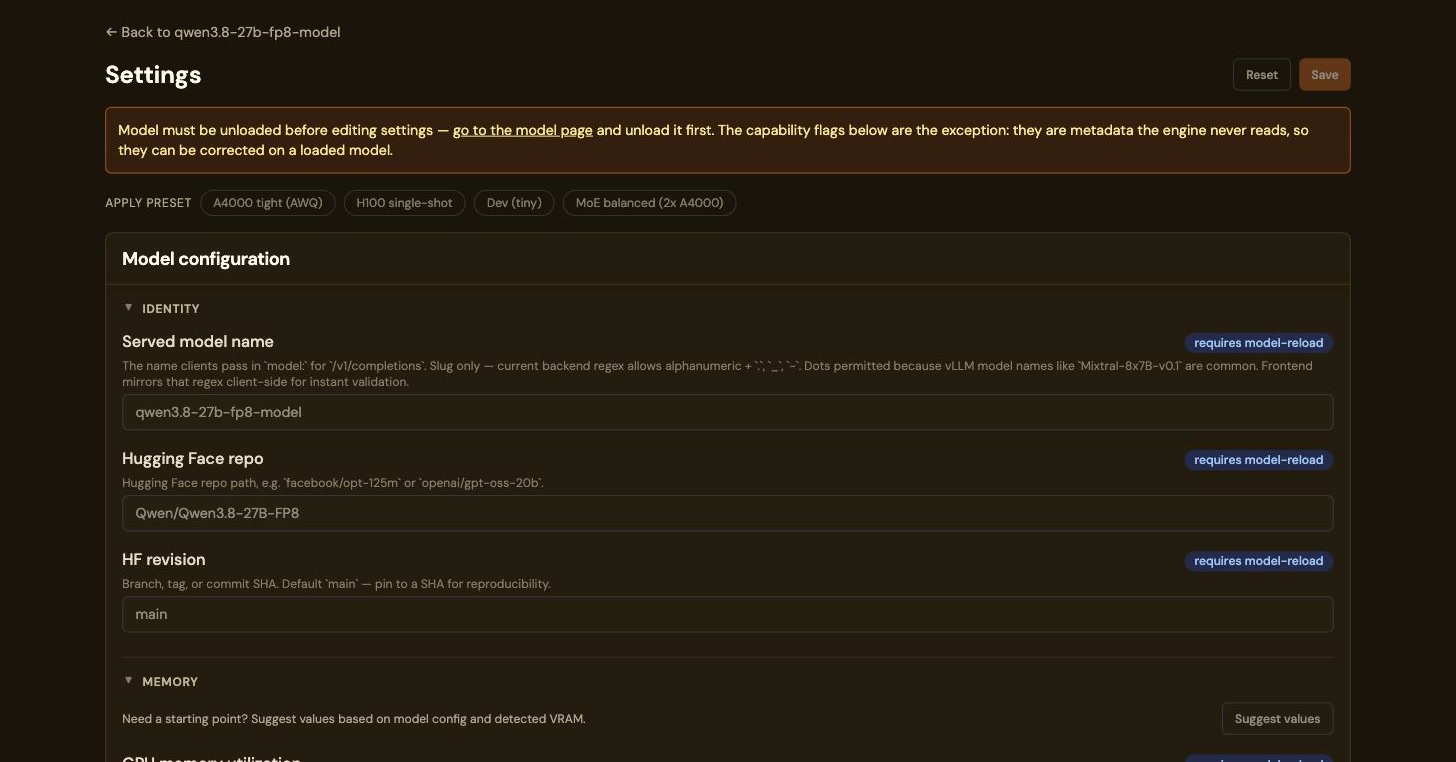
LM Warden actúa como un plano de control que orquesta motores de inferencia LLM principales (vLLM y llama.cpp) a través de una única puerta de entrada Caddy en un puerto publicado. Proporciona gestión del ciclo de vida de modelos, autenticación por clave con contabilidad de uso detallada y monitorización honesta de GPU sin necesidad de CLI. El sistema detecta motores muertos y recarga modelos automáticamente, manteniendo la infraestructura transparente para clientes OpenAI existentes.
La arquitectura utiliza tres contenedores detrás de Caddy con JWT sessions y tokens bearer en /v1/*, SQLite para almacenamiento y un watchdog que sondea /health. No reporta datos a terceros: sin cuentas, licencias ni analíticas. Soporta instalación offline/air-gapped mediante docker load completo. La salida exacta de argv permite reproducir configuraciones fuera del producto.
- Autoalojar API LLM compatible con OpenAI en NVIDIA GPUs existentes
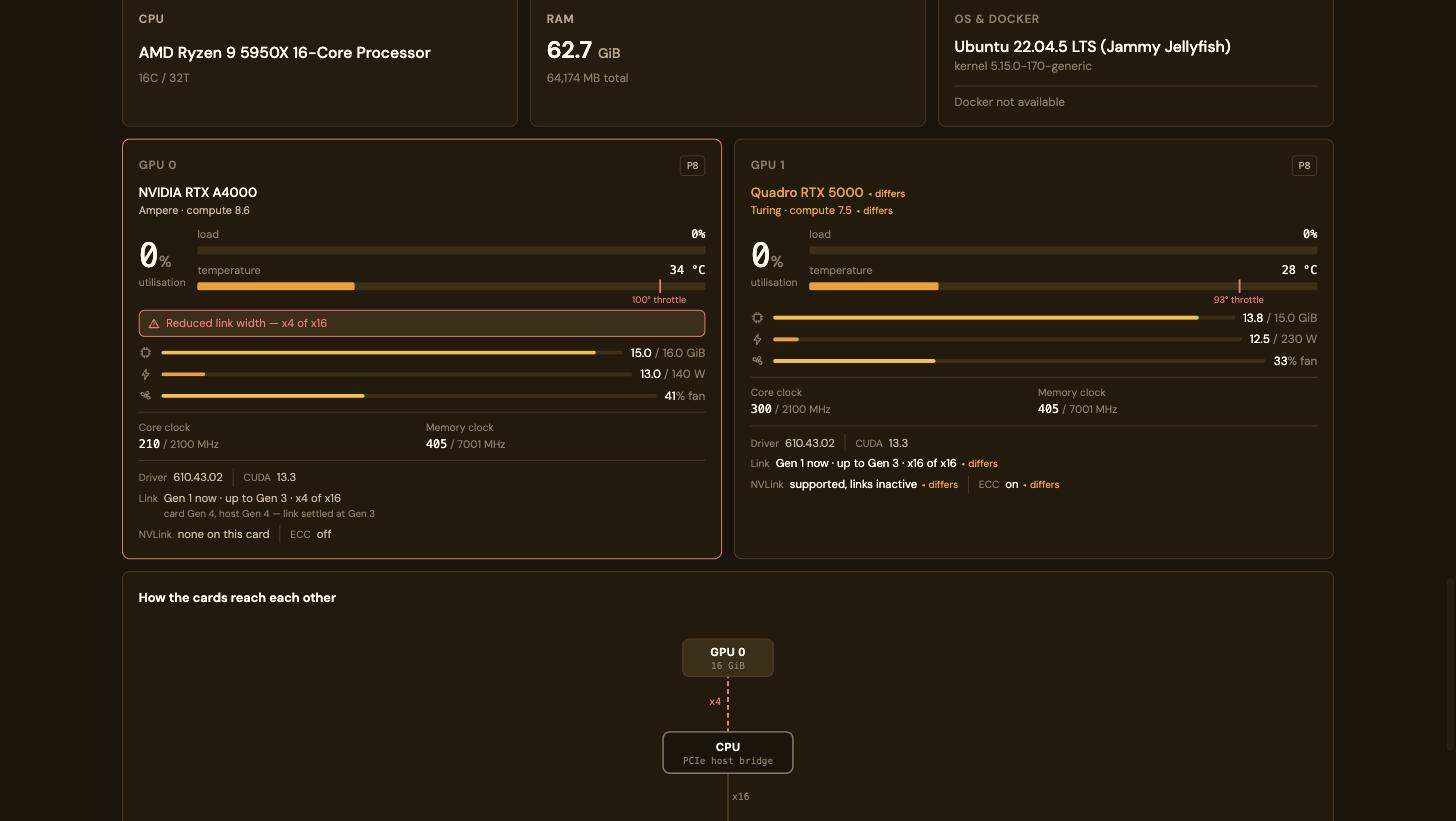
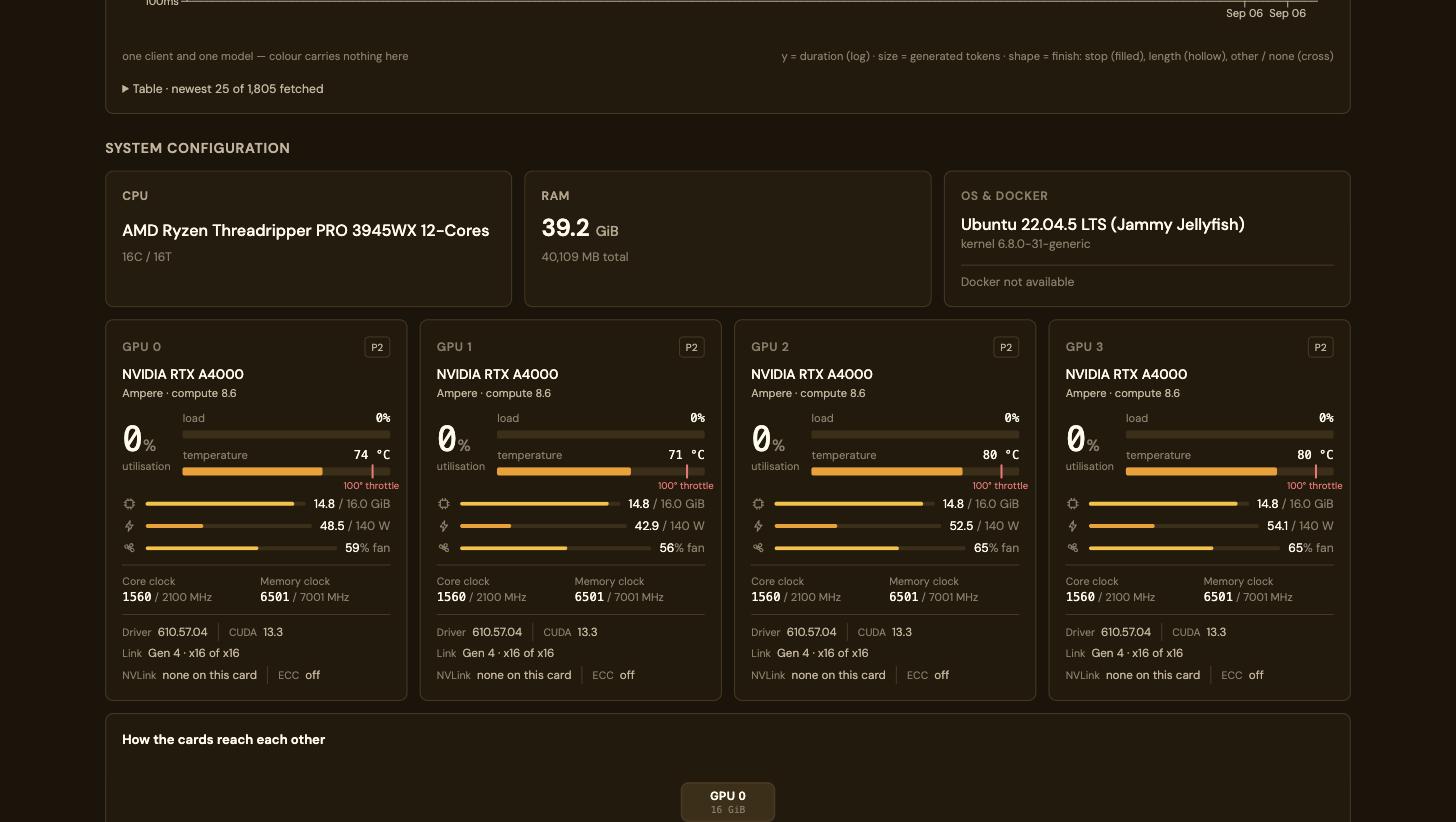
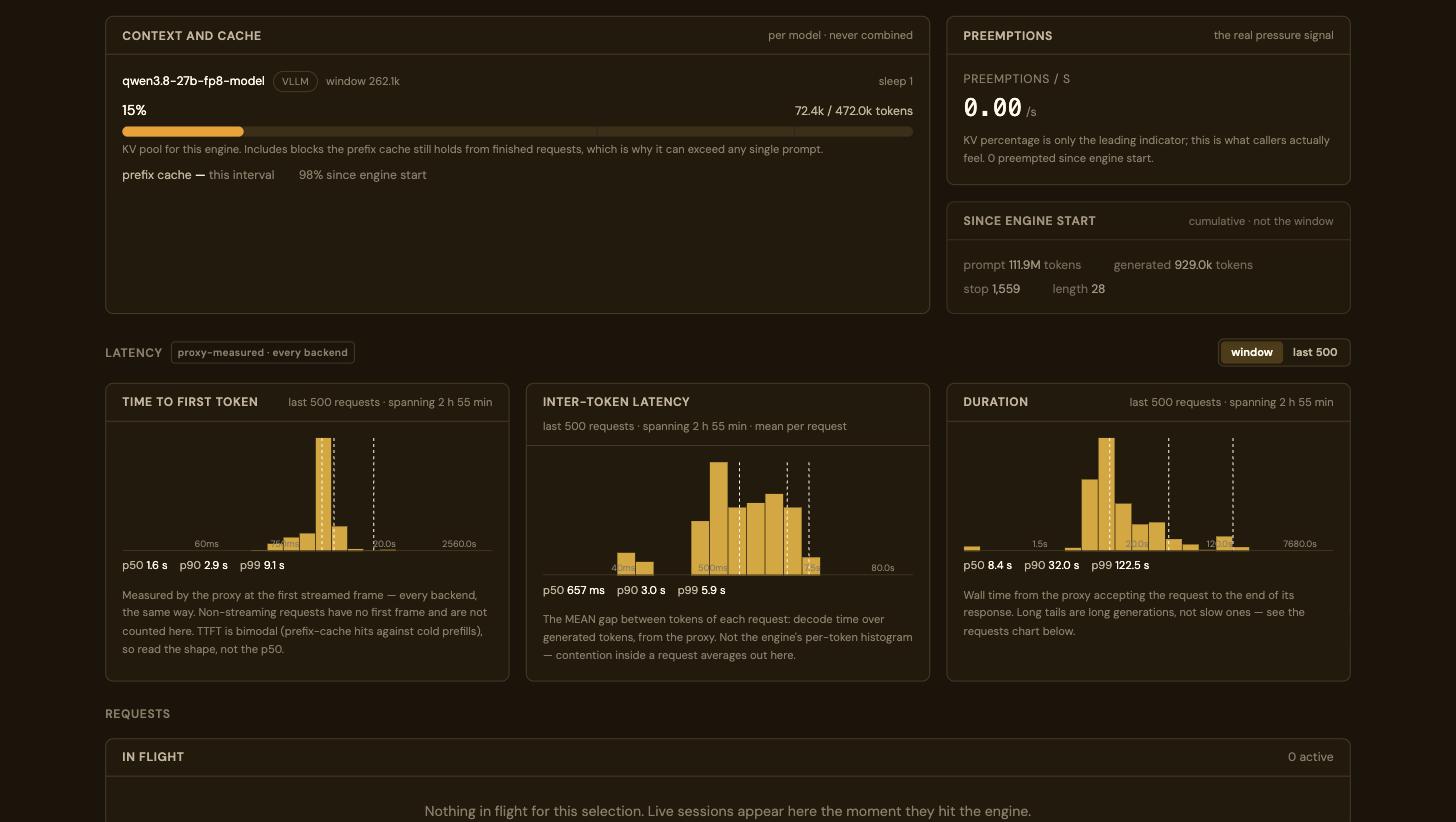
- Monitorizar consumo VRAM, tokens/min y utilización GPU en tiempo real
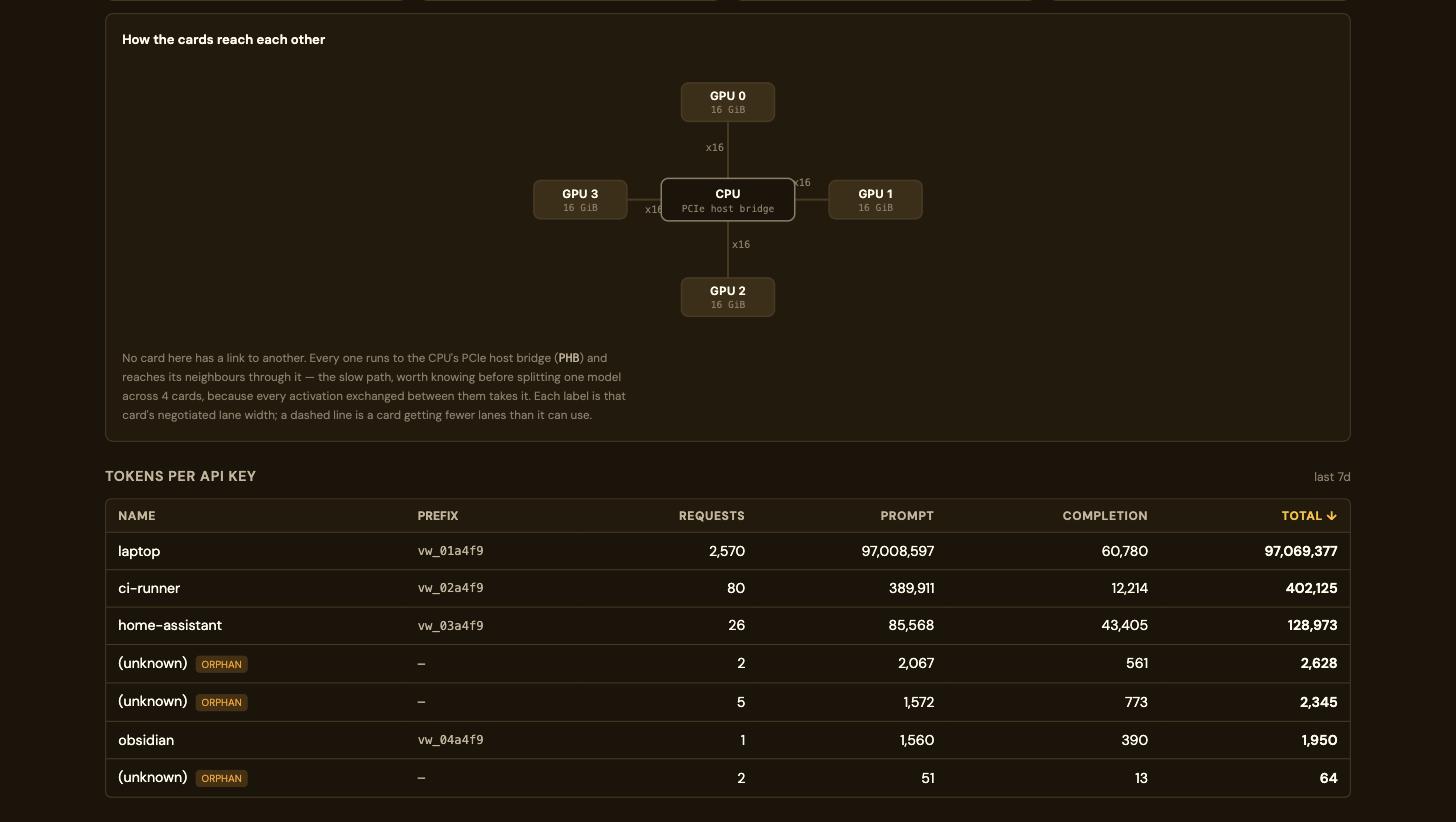
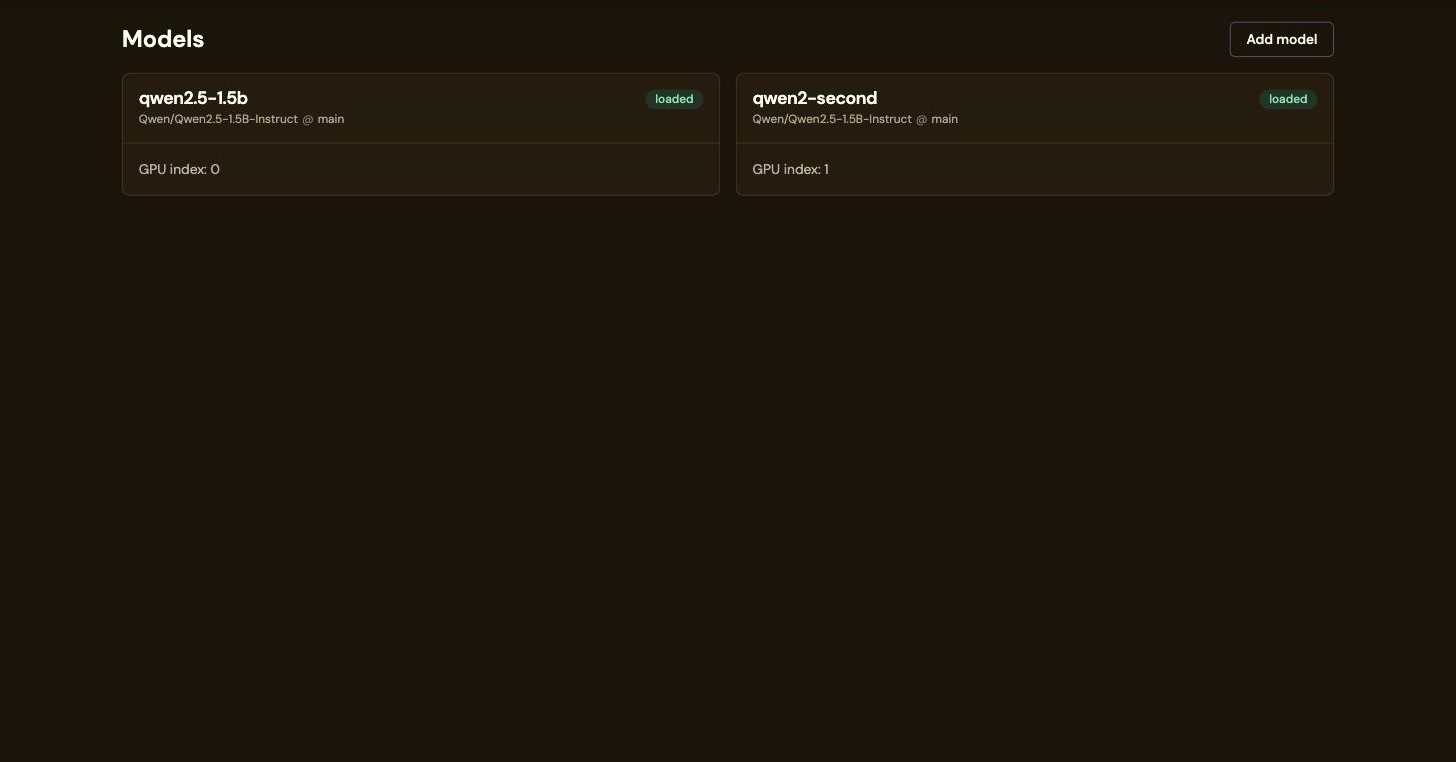
- Gestionar múltiples modelos con autenticación por clave individual
- Despliegue air-gapped sin conexión a internet para seguridad
- Migrar de soluciones hosteadas manteniendo clientes existentes
- Soporta vLLM y llama.cpp sin parches ni monkeypatching
- Detecta y recarga motores muertos automáticamente
- Instalación offline completa con docker load
- API compatible OpenAI con contabilidad de uso por clave
- Monitorización detallada de GPU y consumo energético
- Solo NVIDIA GPUs (Turing o superior, sin ROCm/Metal/CPU)
- Un modelo cargado por GPU (no multi-modelo en misma tarjeta)
- No soporta paralelismo tensorial en llama.cpp
- FP8 weights en Ampere tienen problemas numéricos upstream
- Solo despliegue single-host, no multi-nodo
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Requiere Linux x86_64, Docker Compose v2.24+, NVIDIA Container Toolkit y 40GB libres. GPU mínimo Turing (sm_75). Port 8080 para UI/API. Verificar compatibilidad CUDA 13. Para air-gapped usar HF_HUB_OFFLINE=1 y docker load completo.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.