
llm-hops
Herramienta de trazabilidad para sistemas locales de LLM que visualiza cada salto (hop) de una solicitud: mapa de flujo en tiempo real, waterfall por petición y estadísticas de latencia. Binario estático único.
Ficha actualizada 26 sept 2026, 8:14 · upstream 26 sept 2026, 8:12 · release sin release detectada
Qué es llm-hops
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
llm-hops es un servidor de trazas diseñado para sistemas locales de modelos de lenguaje grandes (LLM). Su propósito principal es resolver la opacidad inherente a las arquitecturas distribuidas típicas en entornos domésticos o pequeños, donde una solicitud puede atravesar múltiples componentes como routers, gateways, colas y servidores de modelos. La herramienta captura cada paso del proceso, desde la decisión de salida hasta la generación final, permitiendo identificar cuellos de botella específicos como tiempos de cola excesivos o latencia en la carga inicial del modelo.
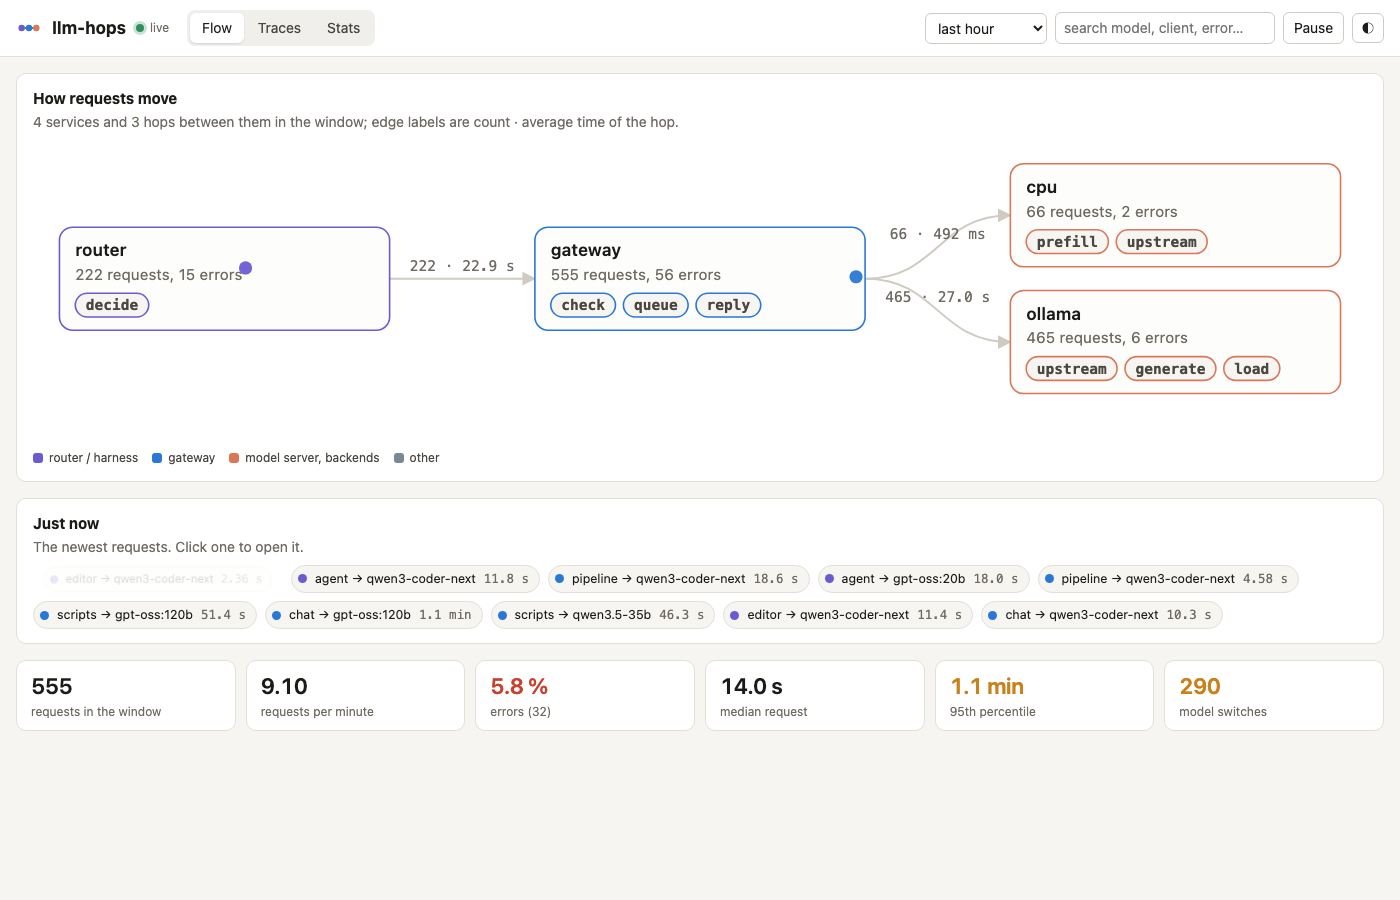
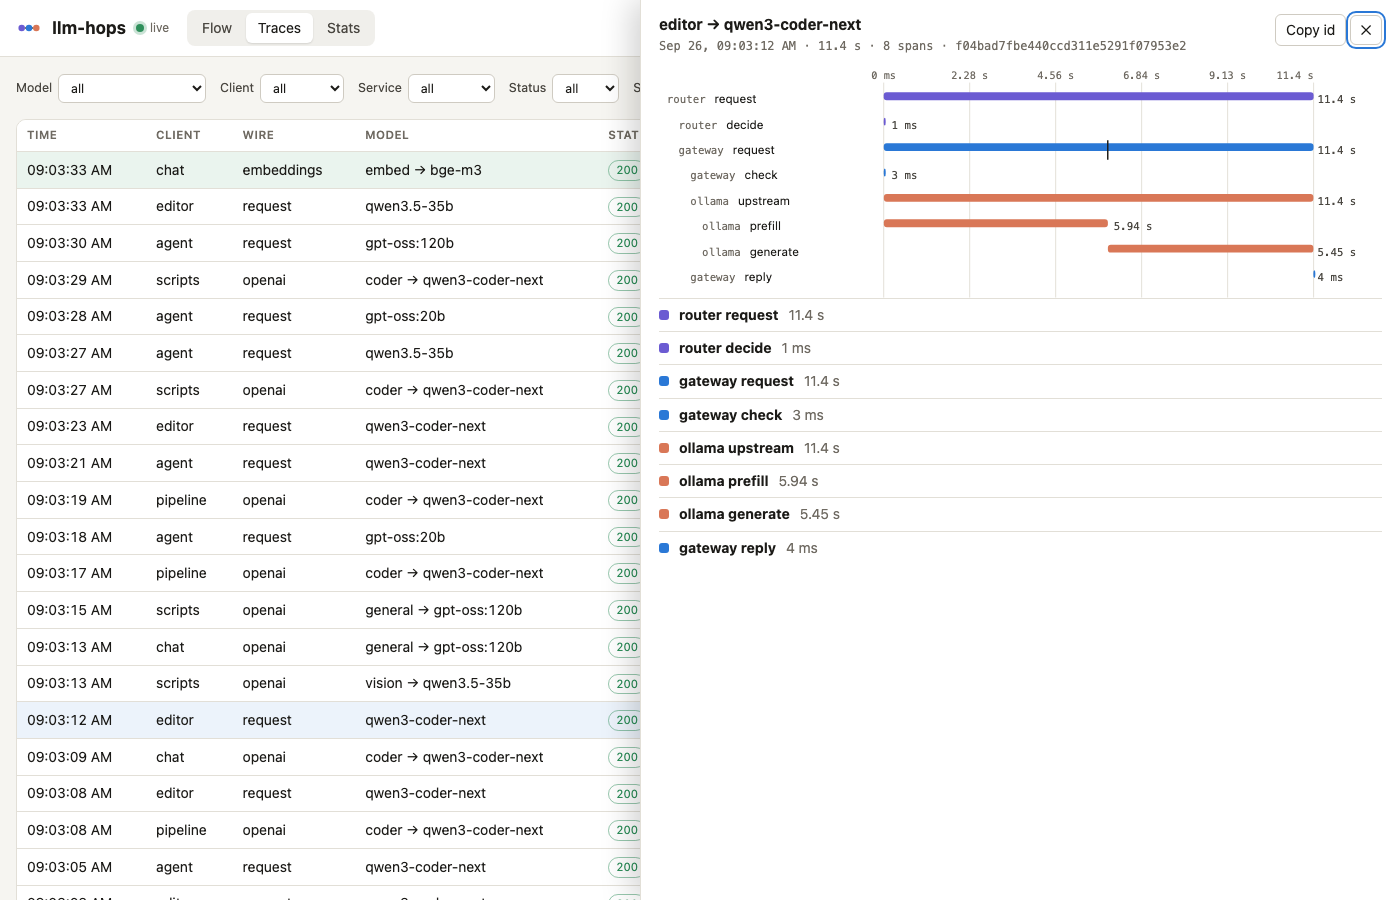
La interfaz web ofrece tres vistas principales: Flow, que muestra el diagrama de servicios y las peticiones en movimiento; Traces, que detalla cada petición con un waterfall temporal desglosando atributos como tokens por segundo y tiempo hasta el primer token; y Stats, que proporciona métricas agregadas como errores, percentiles y número de cambios de modelo. Todo esto se almacena en una base de datos SQLite local, garantizando privacidad al no requerir conexión externa ni almacenar prompts.
La herramienta admite tres modos de ingestión: seguimiento en tiempo real de logs JSONL generados por gateways existentes (como yllm-gateway), carga de archivos históricos o integración mediante SDK Python que envía spans directamente a la API. Esto permite su uso tanto para sistemas nuevos como para auditoría retrospectiva de infraestructuras ya desplegadas.
- Visualización en tiempo real del flujo de solicitudes entre componentes de un sistema local de LLM
- Identificación de cuellos de botella específicos (cola, carga de modelo, generación) mediante waterfall por petición
- Monitorización de rendimiento con métricas como tokens por segundo y percentiles de latencia por salto
- Auditoría de seguridad y privacidad al no almacenar prompts ni completaciones en el servidor
- Binario estático único sin dependencias externas ni pasos de compilación para el usuario final
- Soporte nativo para logs JSONL existentes sin necesidad de modificar el código del sistema LLM
- SDK Python ligero basado en estándar que permite instrumentar aplicaciones con contexto manager o middleware ASGI
- Almacenamiento seguro en SQLite con modo WAL y sincronización FULL para evitar pérdida de datos ante cortes de energía
- La API no incluye autenticación nativa, requiriendo protección externa mediante proxy inverso o SSH
- Dependencia de que los spans enviados contengan todos los metadatos necesarios (service, name, start_ms, end_ms)
- Traces antiguos se eliminan automáticamente cada diez minutos si exceden el periodo -keep-days (por defecto 14 días)
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Desplegar detrás de un proxy inverso con autenticación o tunel SSH. Usar systemd unit para gestión de procesos. Proteger la base de datos SQLite con permisos restrictivos. No exponer el puerto 11602 directamente a internet sin medidas de seguridad adicionales.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.