
llm-ferry
Gateway AI auto-hospedado para Mac que expone un único endpoint OpenAI-compatible a toda la LAN. Combina inferencia local MLX en Apple Silicon con proxies de nube, gestionando suscripciones OAuth y fallbacks automáticos sin exponer claves.
Ficha actualizada 24 sept 2026, 0:19 · upstream 23 sept 2026, 23:56 · release v1.37.0
Qué es llm-ferry
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
llm-ferry actúa como puerta de entrada artificial para redes locales, permitiendo a múltiples clientes acceder a modelos de IA desde un único host Mac. Centraliza la gestión de suscripciones de proveedores como OpenAI o Anthropic mediante OAuth, asegurando que las claves nunca abandonen el servidor principal. El sistema soporta tanto inferencia local optimizada con MLX en hardware Apple Silicon como proxy de servicios en la nube, configurando rutas de fallback automáticas para mantener la disponibilidad.
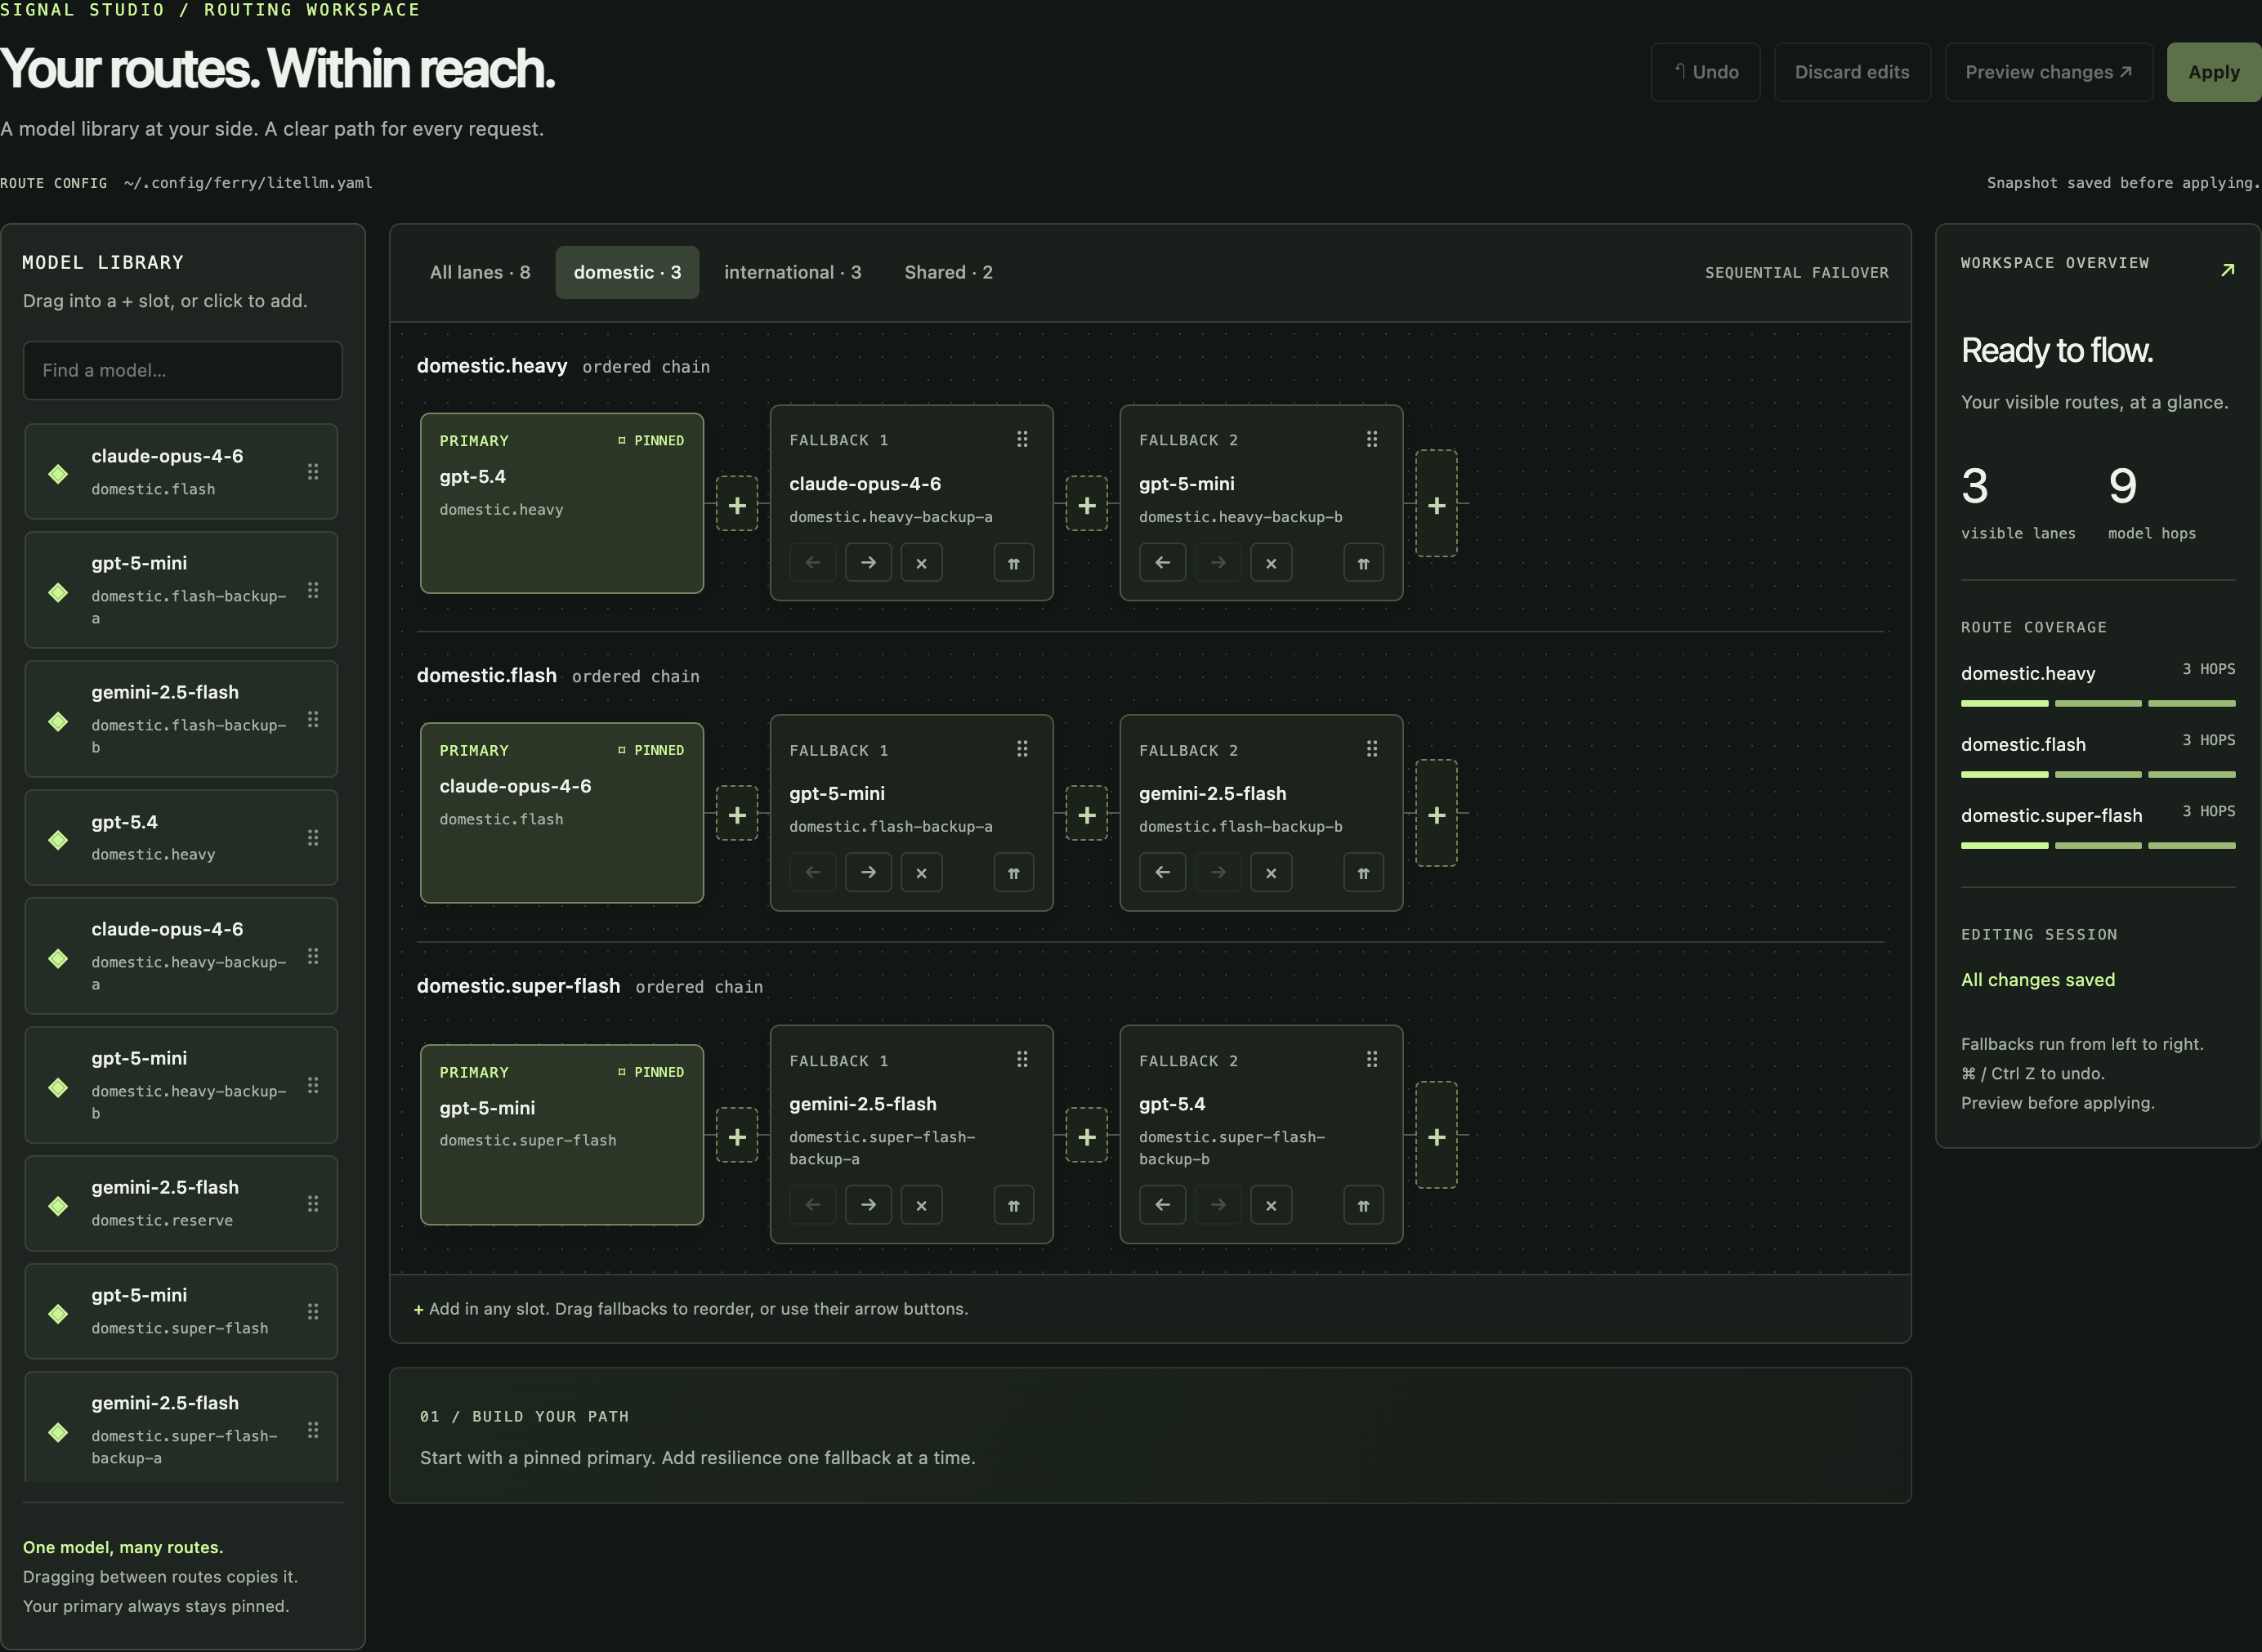
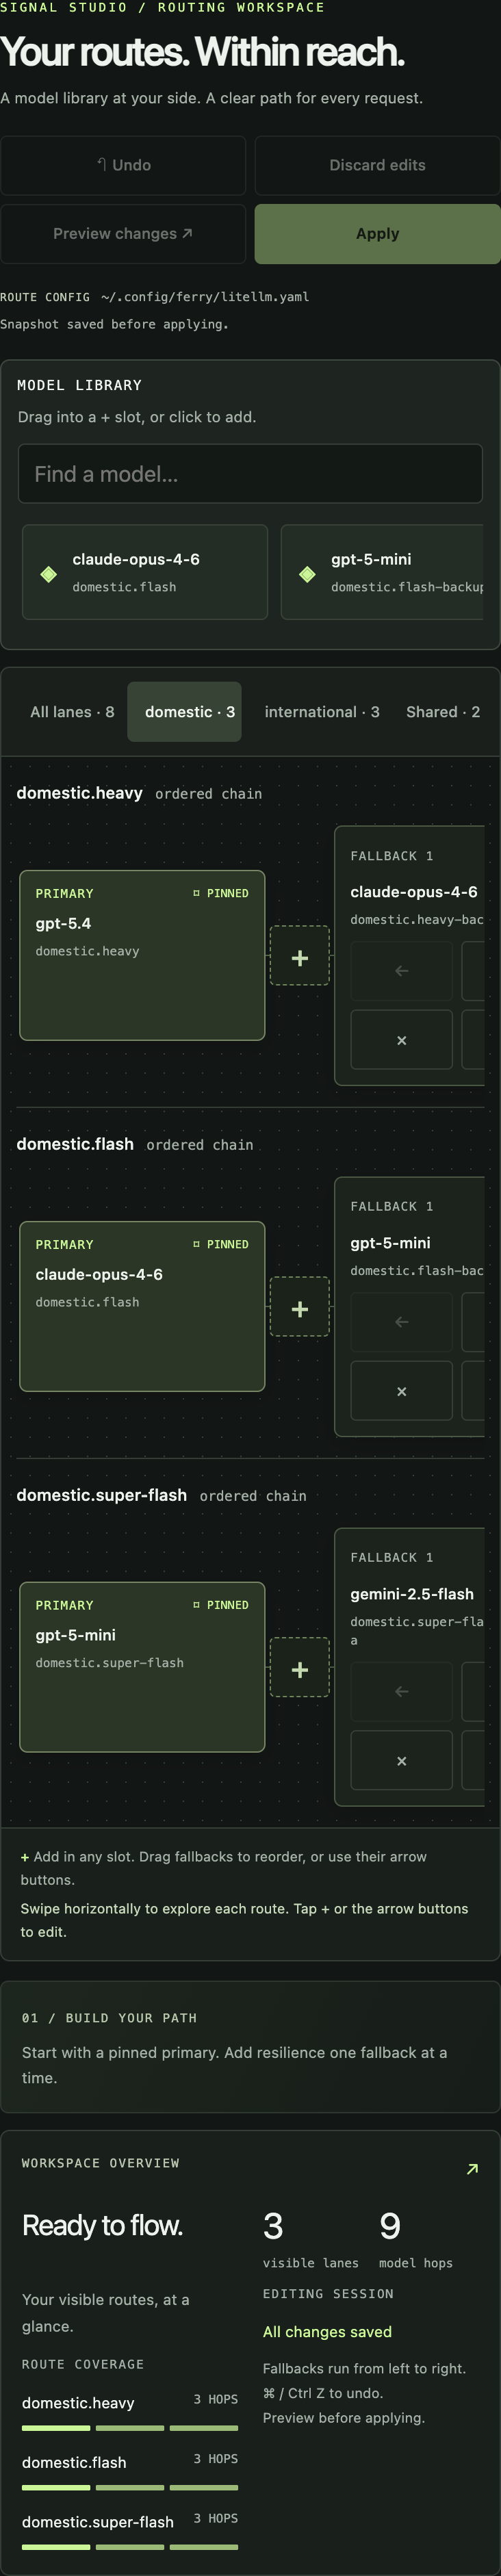
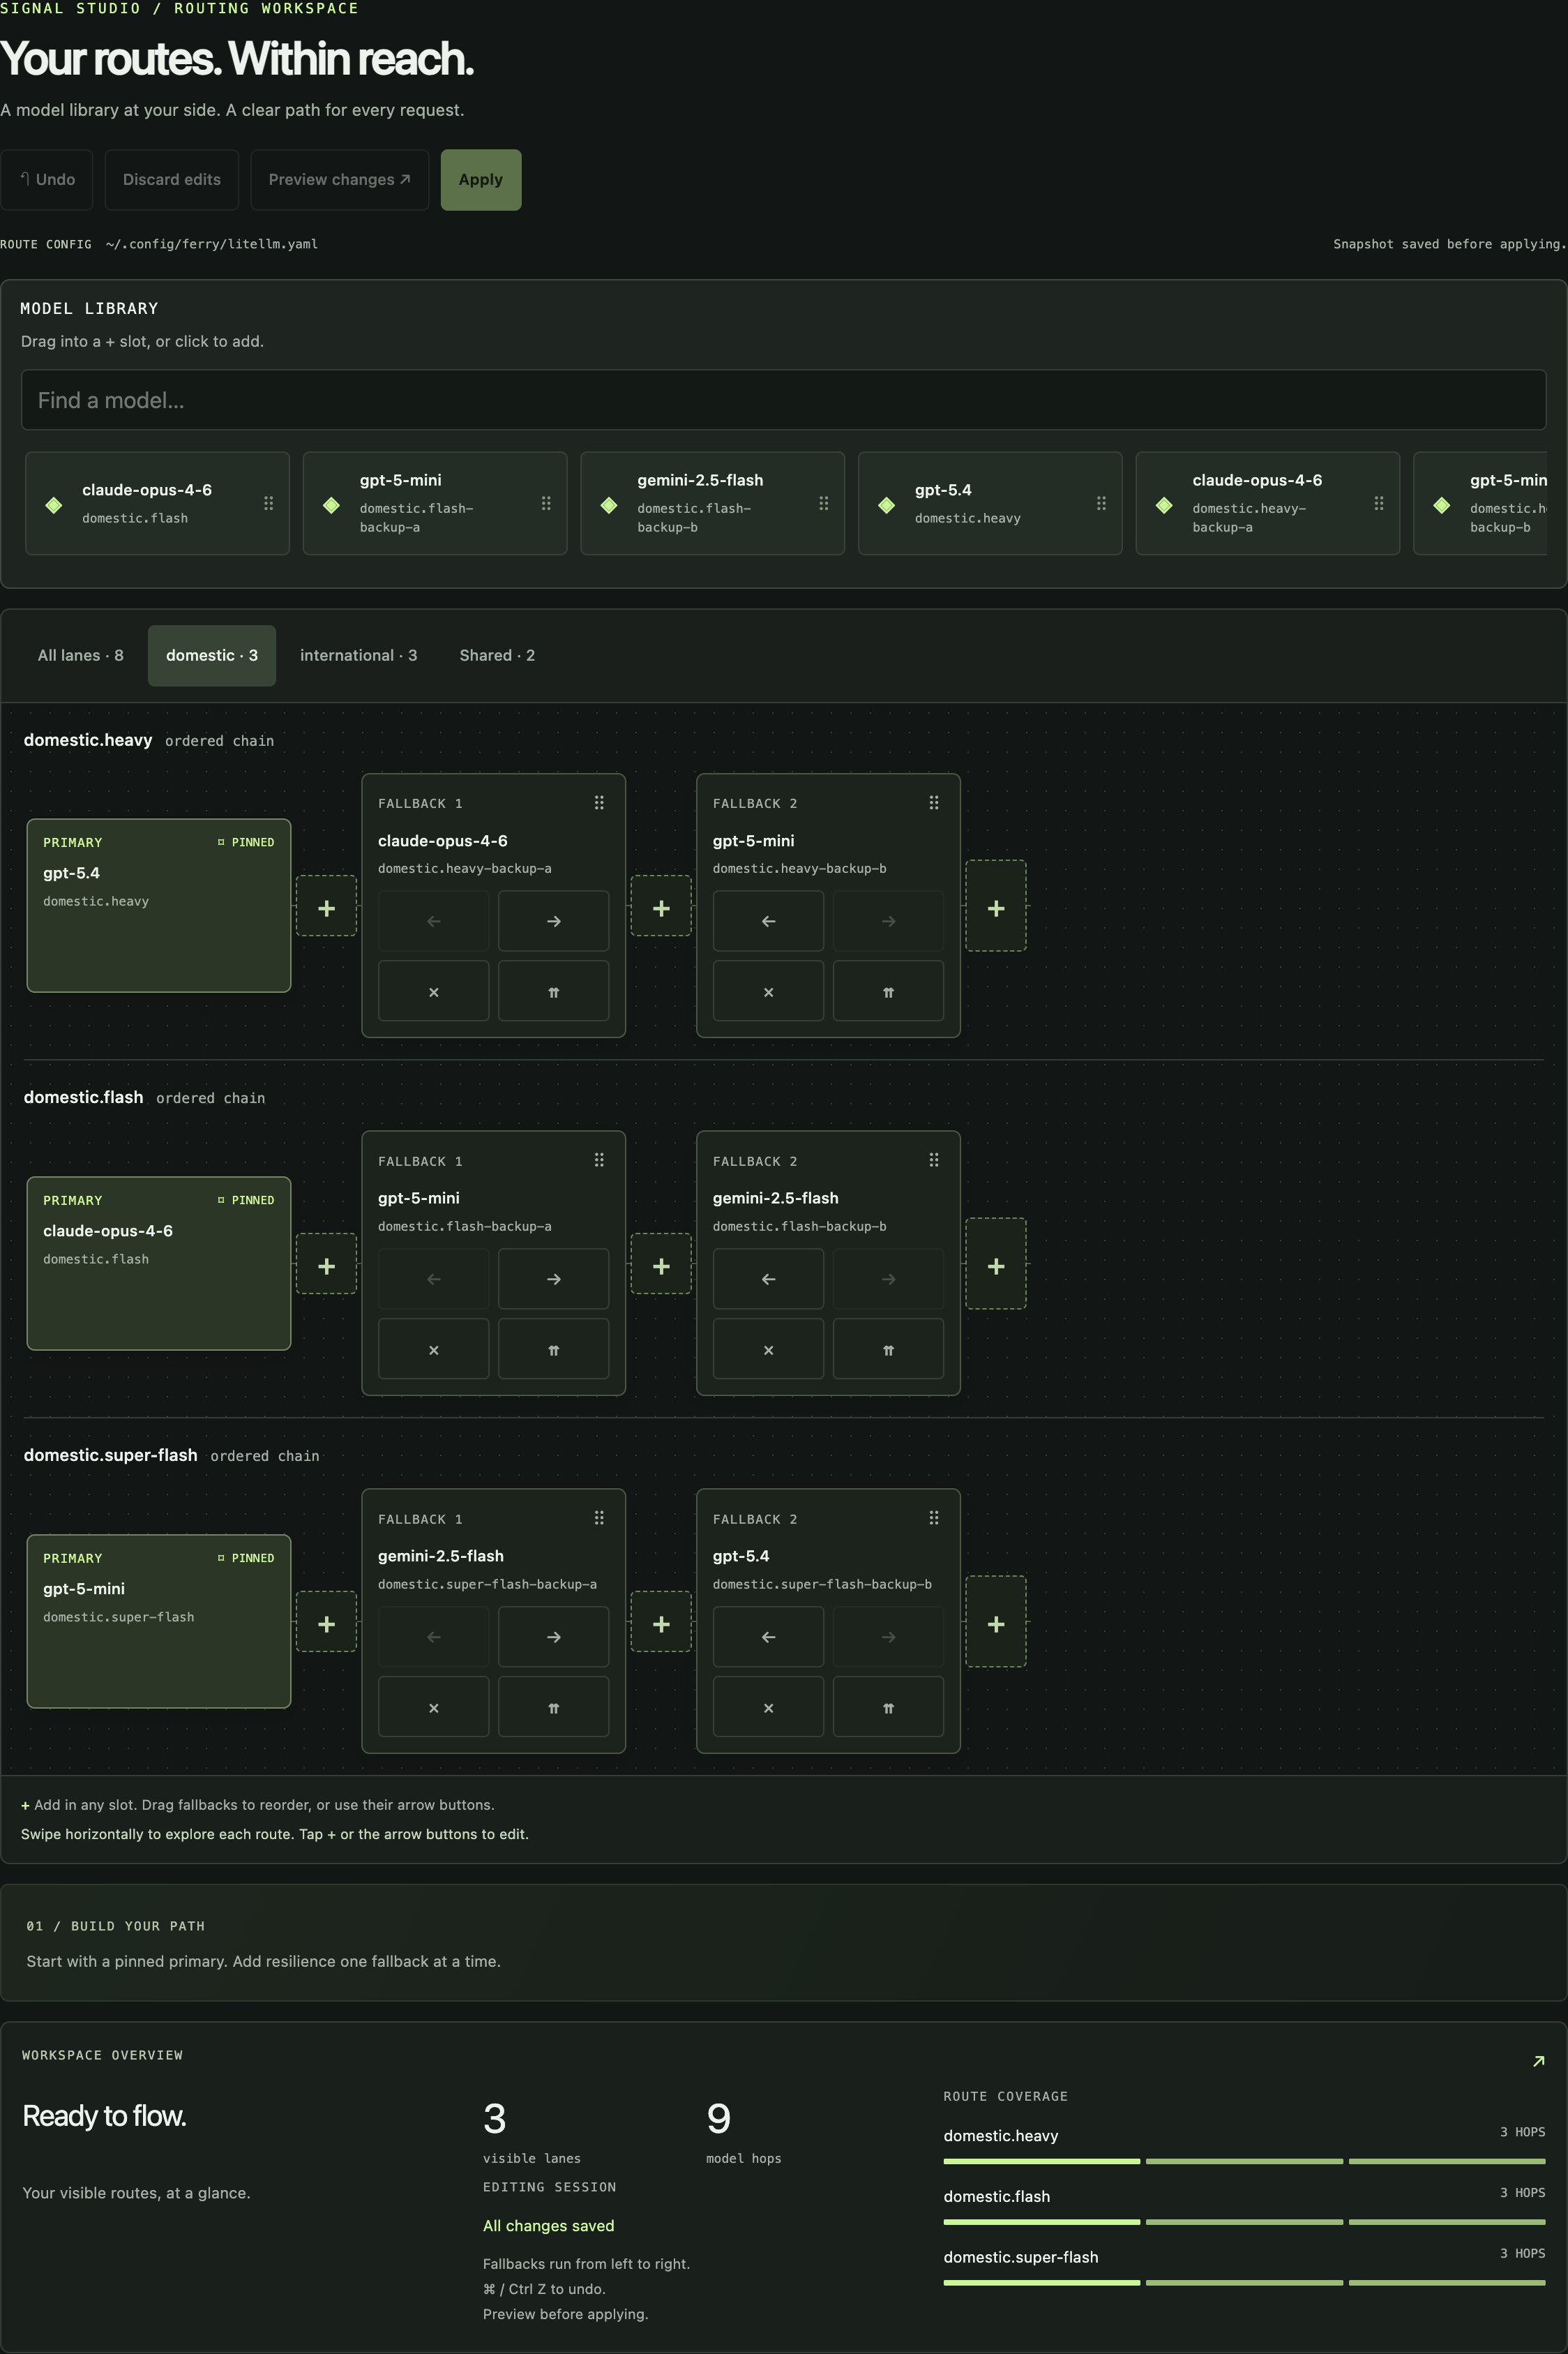
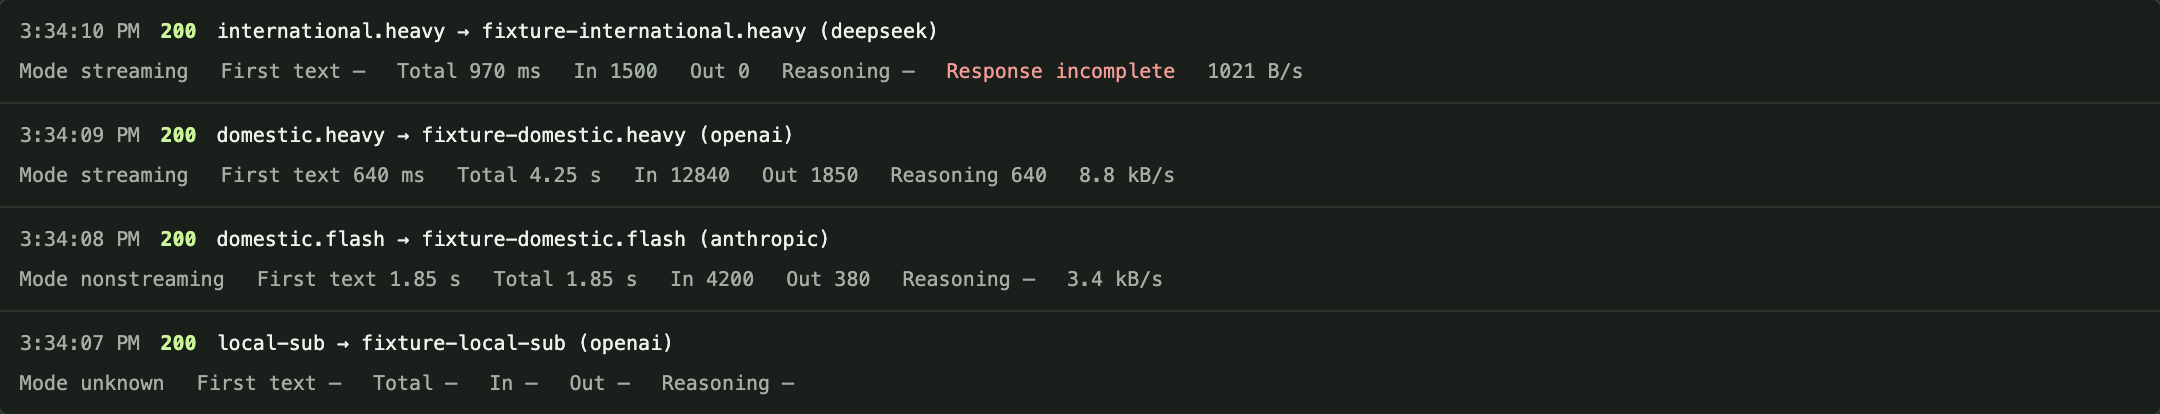
Incluye Signal Studio, una interfaz visual para diseñar cadenas de modelos y monitorizar tráfico en tiempo real. Además, facilita la transferencia de archivos o modelos completos entre dispositivos mediante su propia red, y permite túneles inversos para clientes con restricciones de salida. Es ideal para laboratorios domésticos o equipos pequeños que buscan optimizar costes y centralizar seguridad.
La arquitectura se basa en Python estándar y zsh sin dependencias pesadas como Docker, lo que reduce la huella del host pero exige gestión manual de actualizaciones. El despliegue requiere un Mac potente con GPU integrada para aprovechar las capacidades de MLX, mientras que los clientes pueden ser cualquier dispositivo compatible con HTTP.
- Centralizar suscripciones de API (OpenAI/Claude) para toda la red local sin exponer claves en cada cliente.
- Servir modelos locales optimizados con MLX a clientes ligeros sin instalarlos en ellos.
- Configurar cadenas de fallback automáticos entre modelos costosos y económicos según disponibilidad.
- Transferir modelos o archivos grandes entre dispositivos LAN utilizando el host como punto de transferencia.
- Proporcionar acceso remoto seguro vía túnel inverso para clientes bloqueados por políticas de red.
- Endpoint único OpenAI-compatible que unifica inferencia local y nube en una sola URL.
- Gestión segura de suscripciones OAuth (Claude/ChatGPT) donde las claves residen exclusivamente en el host.
- Inferencia nativa en Apple Silicon con MLX, optimizando memoria GPU y velocidad de decodificación.
- Interfaz Signal Studio para gestión visual de rutas, fallbacks y monitorización de latencia.
- Capacidad de ferryizar modelos y archivos entre dispositivos LAN sin depender de almacenamiento externo.
- Requiere hardware Apple Silicon (M1/M2/M3) para activar la inferencia local vía MLX.
- No utiliza contenedores Docker, necesitando instalación manual del CLI en el host.
- El tráfico cliente-host se realiza sobre HTTP plano en la red local, requiriendo seguridad perimetral adecuada.
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
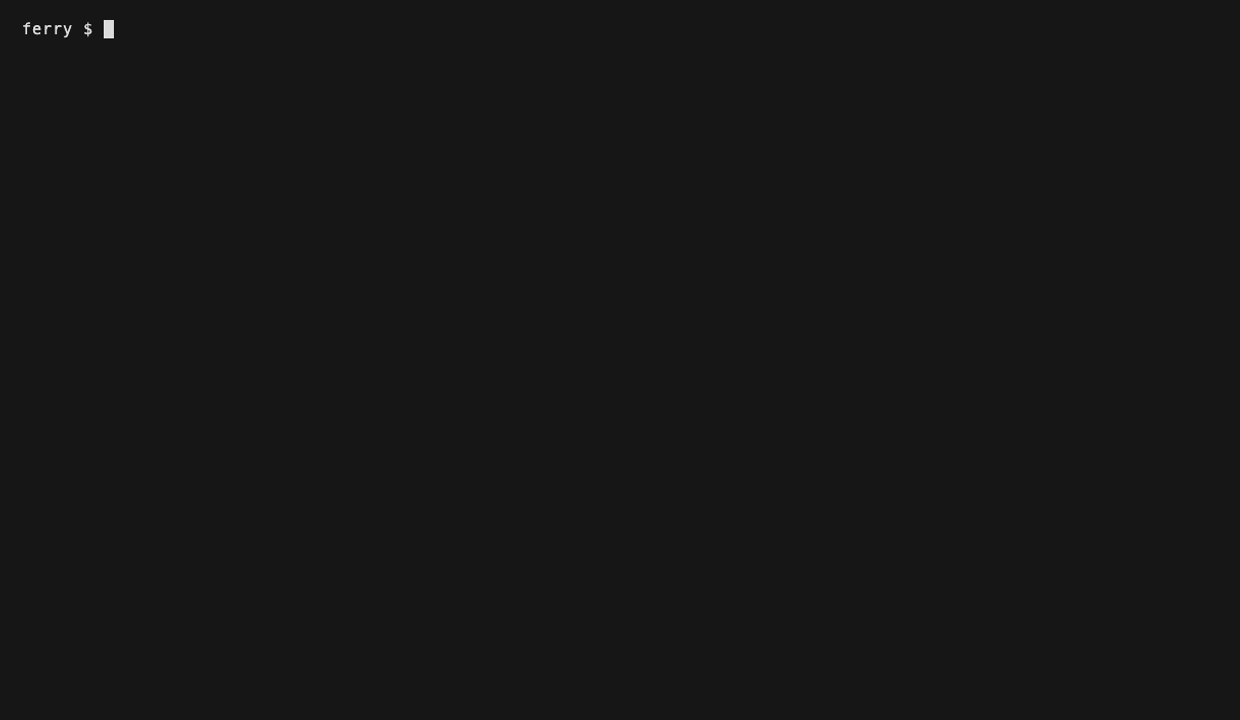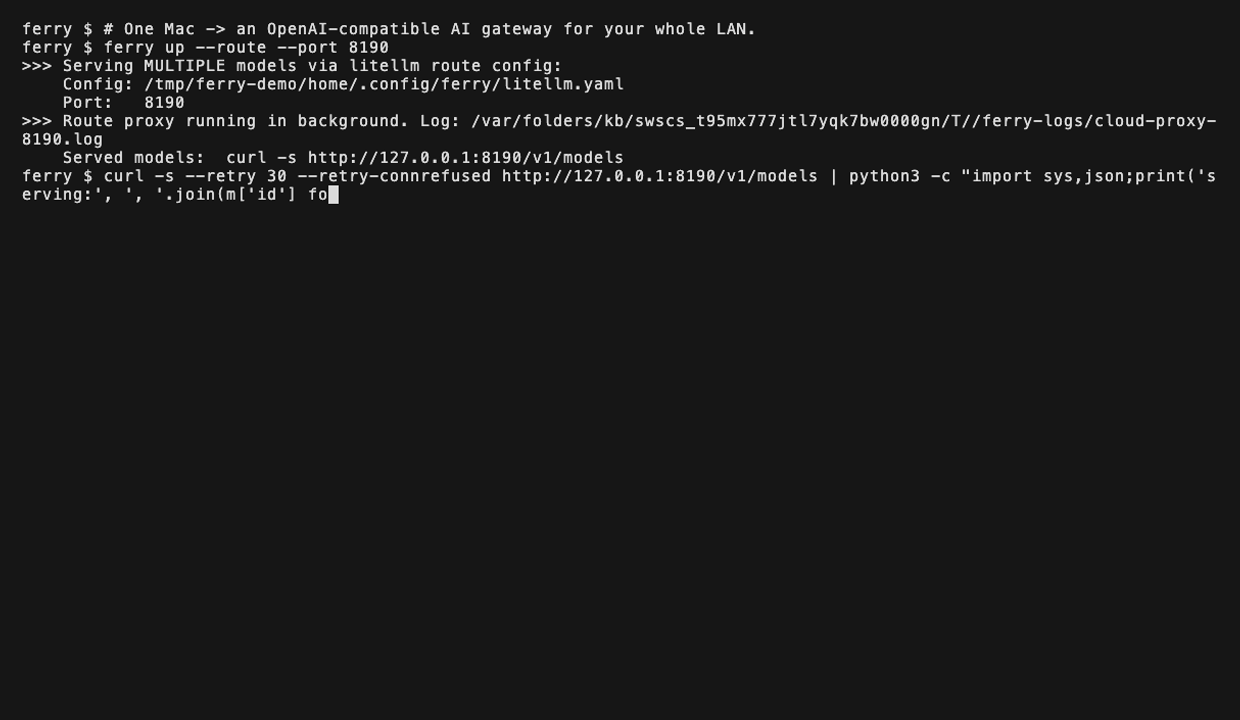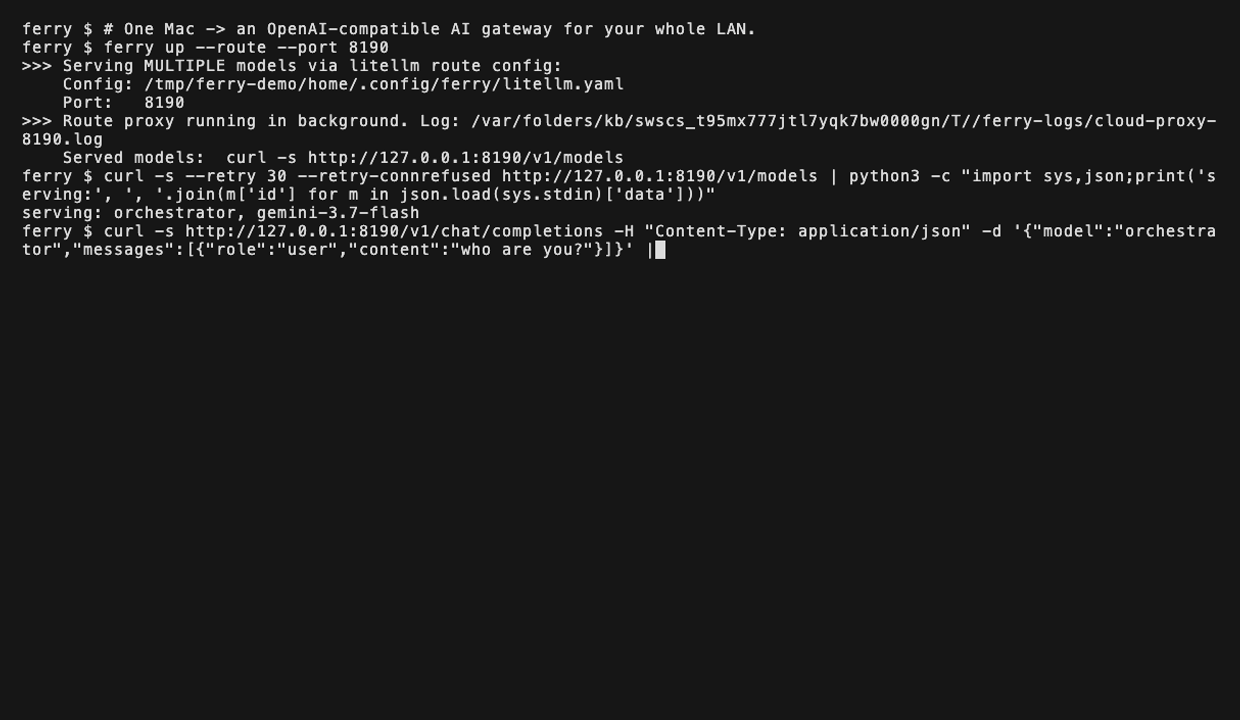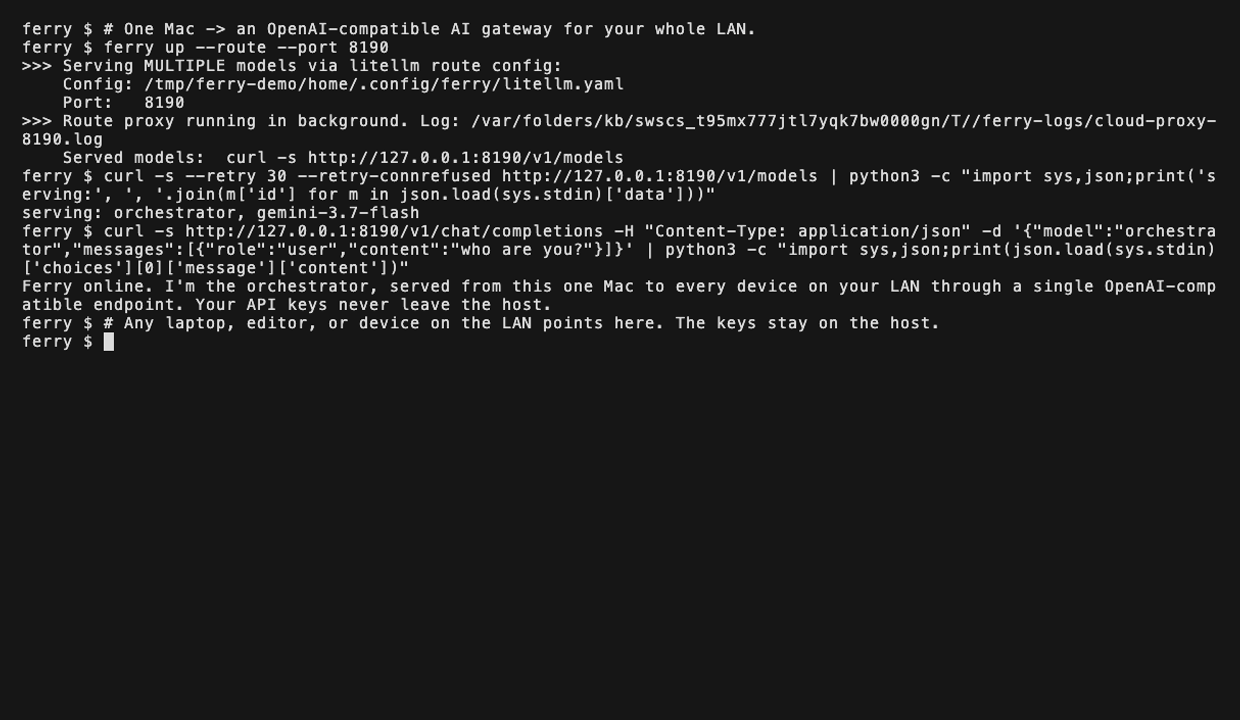
Despliegue inicial mediante `host-bootstrap.sh` para instalar dependencias y descargar modelos. Configurar variables de entorno (ej. OPENROUTER_API_KEY) o usar `ferry auth-claude login`. Ejecutar `ferry up` para seleccionar modelos y `ferry share` para obtener la URL de acceso LAN. Los clientes instalan el CLI vía curl y se conectan al endpoint compartido.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.