
llamaloadergui
Interfaz web para gestionar y lanzar llama-server de llama.cpp. Funciona localmente o remota vía SSH en servidores headless. Permite crear perfiles de configuración, visualizar logs en tiempo real y validar la compatibilidad de flags con el binario seleccionado antes de ejecutar.
Ficha actualizada 24 sept 2026, 8:07 · upstream 21 sept 2026, 9:41 · release v1.0.0
Qué es llamaloadergui
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Llamaloadergui es una interfaz web ligera diseñada para configurar, guardar perfiles y lanzar llama-server de llama.cpp. Permite gestionar el ciclo de vida del proceso (iniciar, detener, ver logs) tanto en la máquina local como en hosts remotos sin escritorio mediante SSH. Los modelos .gguf y el binario son archivos propios; la herramienta no aloja nada externamente.
Técnicamente utiliza FastAPI para el backend y JavaScript vanilla para el frontend, ejecutándose en un servidor Python local (puerto 7890). Destaca por su capacidad de importar comandos verbatim, respetando la sintaxis exacta sin añadir flags ocultos. Incluye detección automática de flags disponibles en el binario seleccionado mediante --help, advirtiendo sobre incompatibilidades entre forks o versiones antes del lanzamiento.
La seguridad es prioritaria; el servidor web solo se une a 127.0.0.1 y no expone puertos al exterior. El modo remoto opera en segundo plano (detached) en el destino, gestionando PID files y logs remotos. Soporta autenticación SSH basada en claves para acceso headless, evitando la entrada de contraseñas interactivas que bloquearían el flujo automatizado.
- Lanzamiento local de modelos LLM con persistencia de configuración en perfiles
- Ejecución remota en servidores GPU headless sin interfaz gráfica
- Gestión de múltiples builds de llama.cpp (stock o forks) desde una misma GUI
- Reutilización de comandos existentes importados directamente desde la línea de órdenes
- Monitorización en vivo de logs y métricas de la API del servidor
- Soporte nativo para modo detached remoto vía SSH con gestión de PID files
- Detección automática de flags del binario seleccionado (--help) para evitar errores
- Importación verbatim de comandos sin añadir parámetros por defecto silenciosamente
- Escaneo automático de modelos .gguf y binarios en el sistema de archivos local
- Visualización de logs en vivo con barra de desplazamiento ajustable al tamaño de pantalla
- Seguridad: servidor web restringido exclusivamente a localhost (127.0.0.1)
- Requiere Python 3.10 o superior para ejecutar el entorno virtual
- No incluye Dockerfile ni archivos de composición (Compose) por defecto
- Depende de binarios llama.cpp precompilados o builds propios en el sistema
- Modo remoto requiere autenticación SSH con claves públicas sin soporte de contraseñas
- Licencia GPL-3.0-or-later, obligando a compartir modificaciones si se redistribuye
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
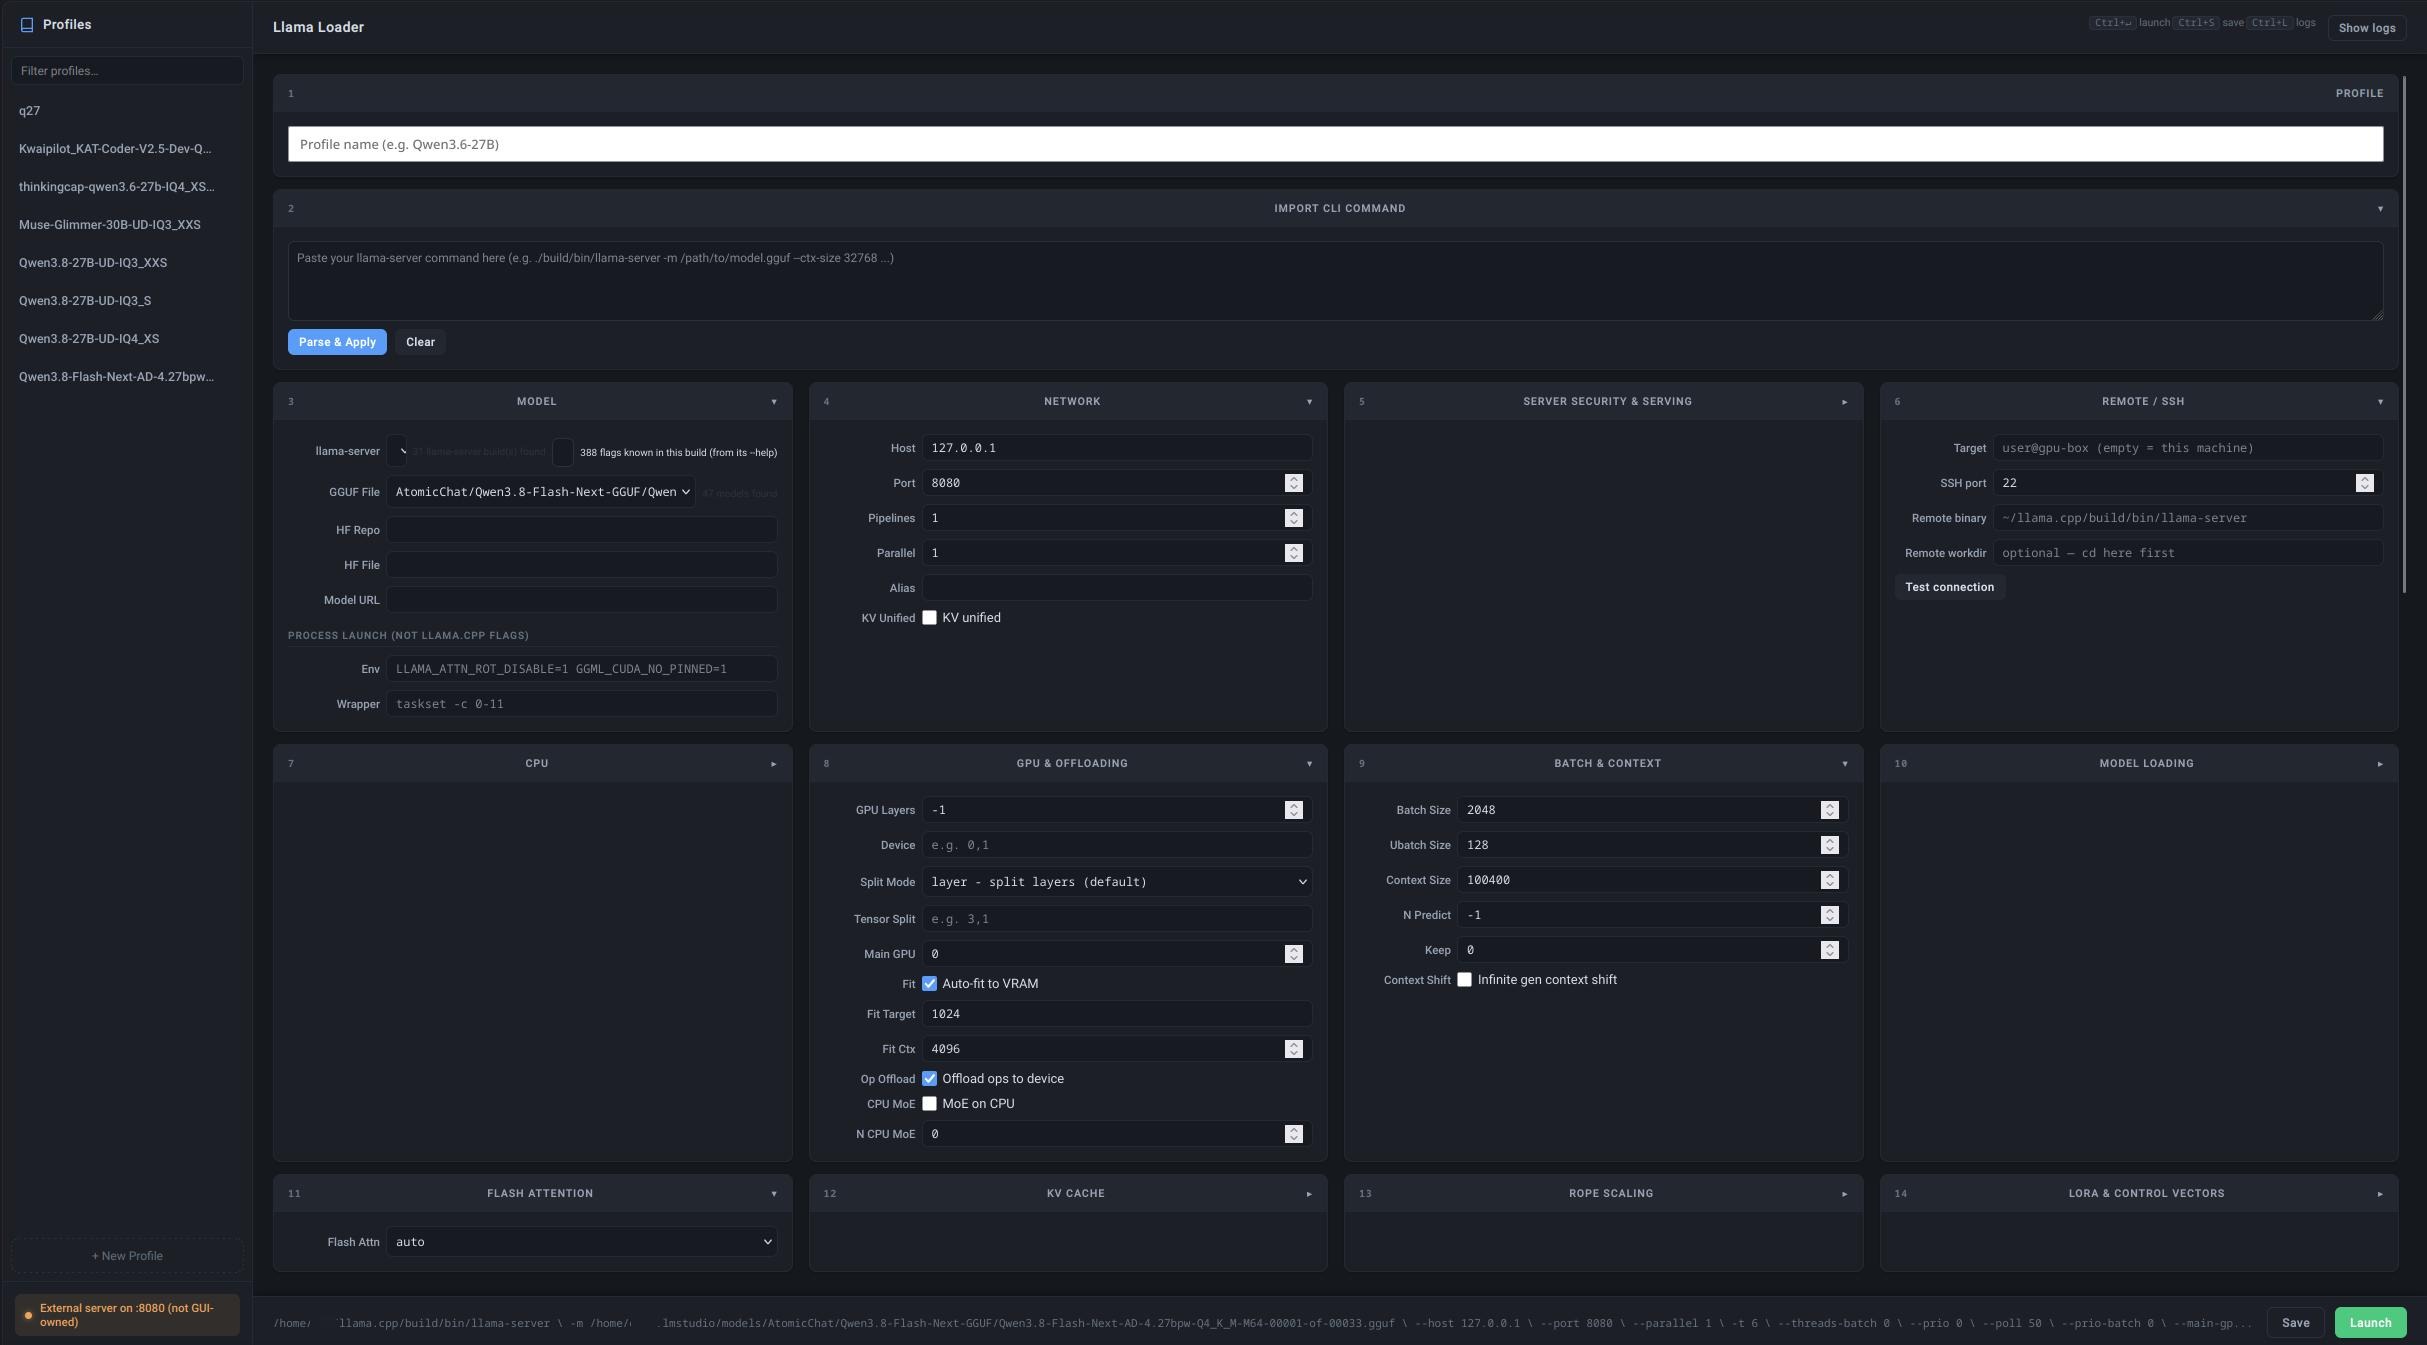
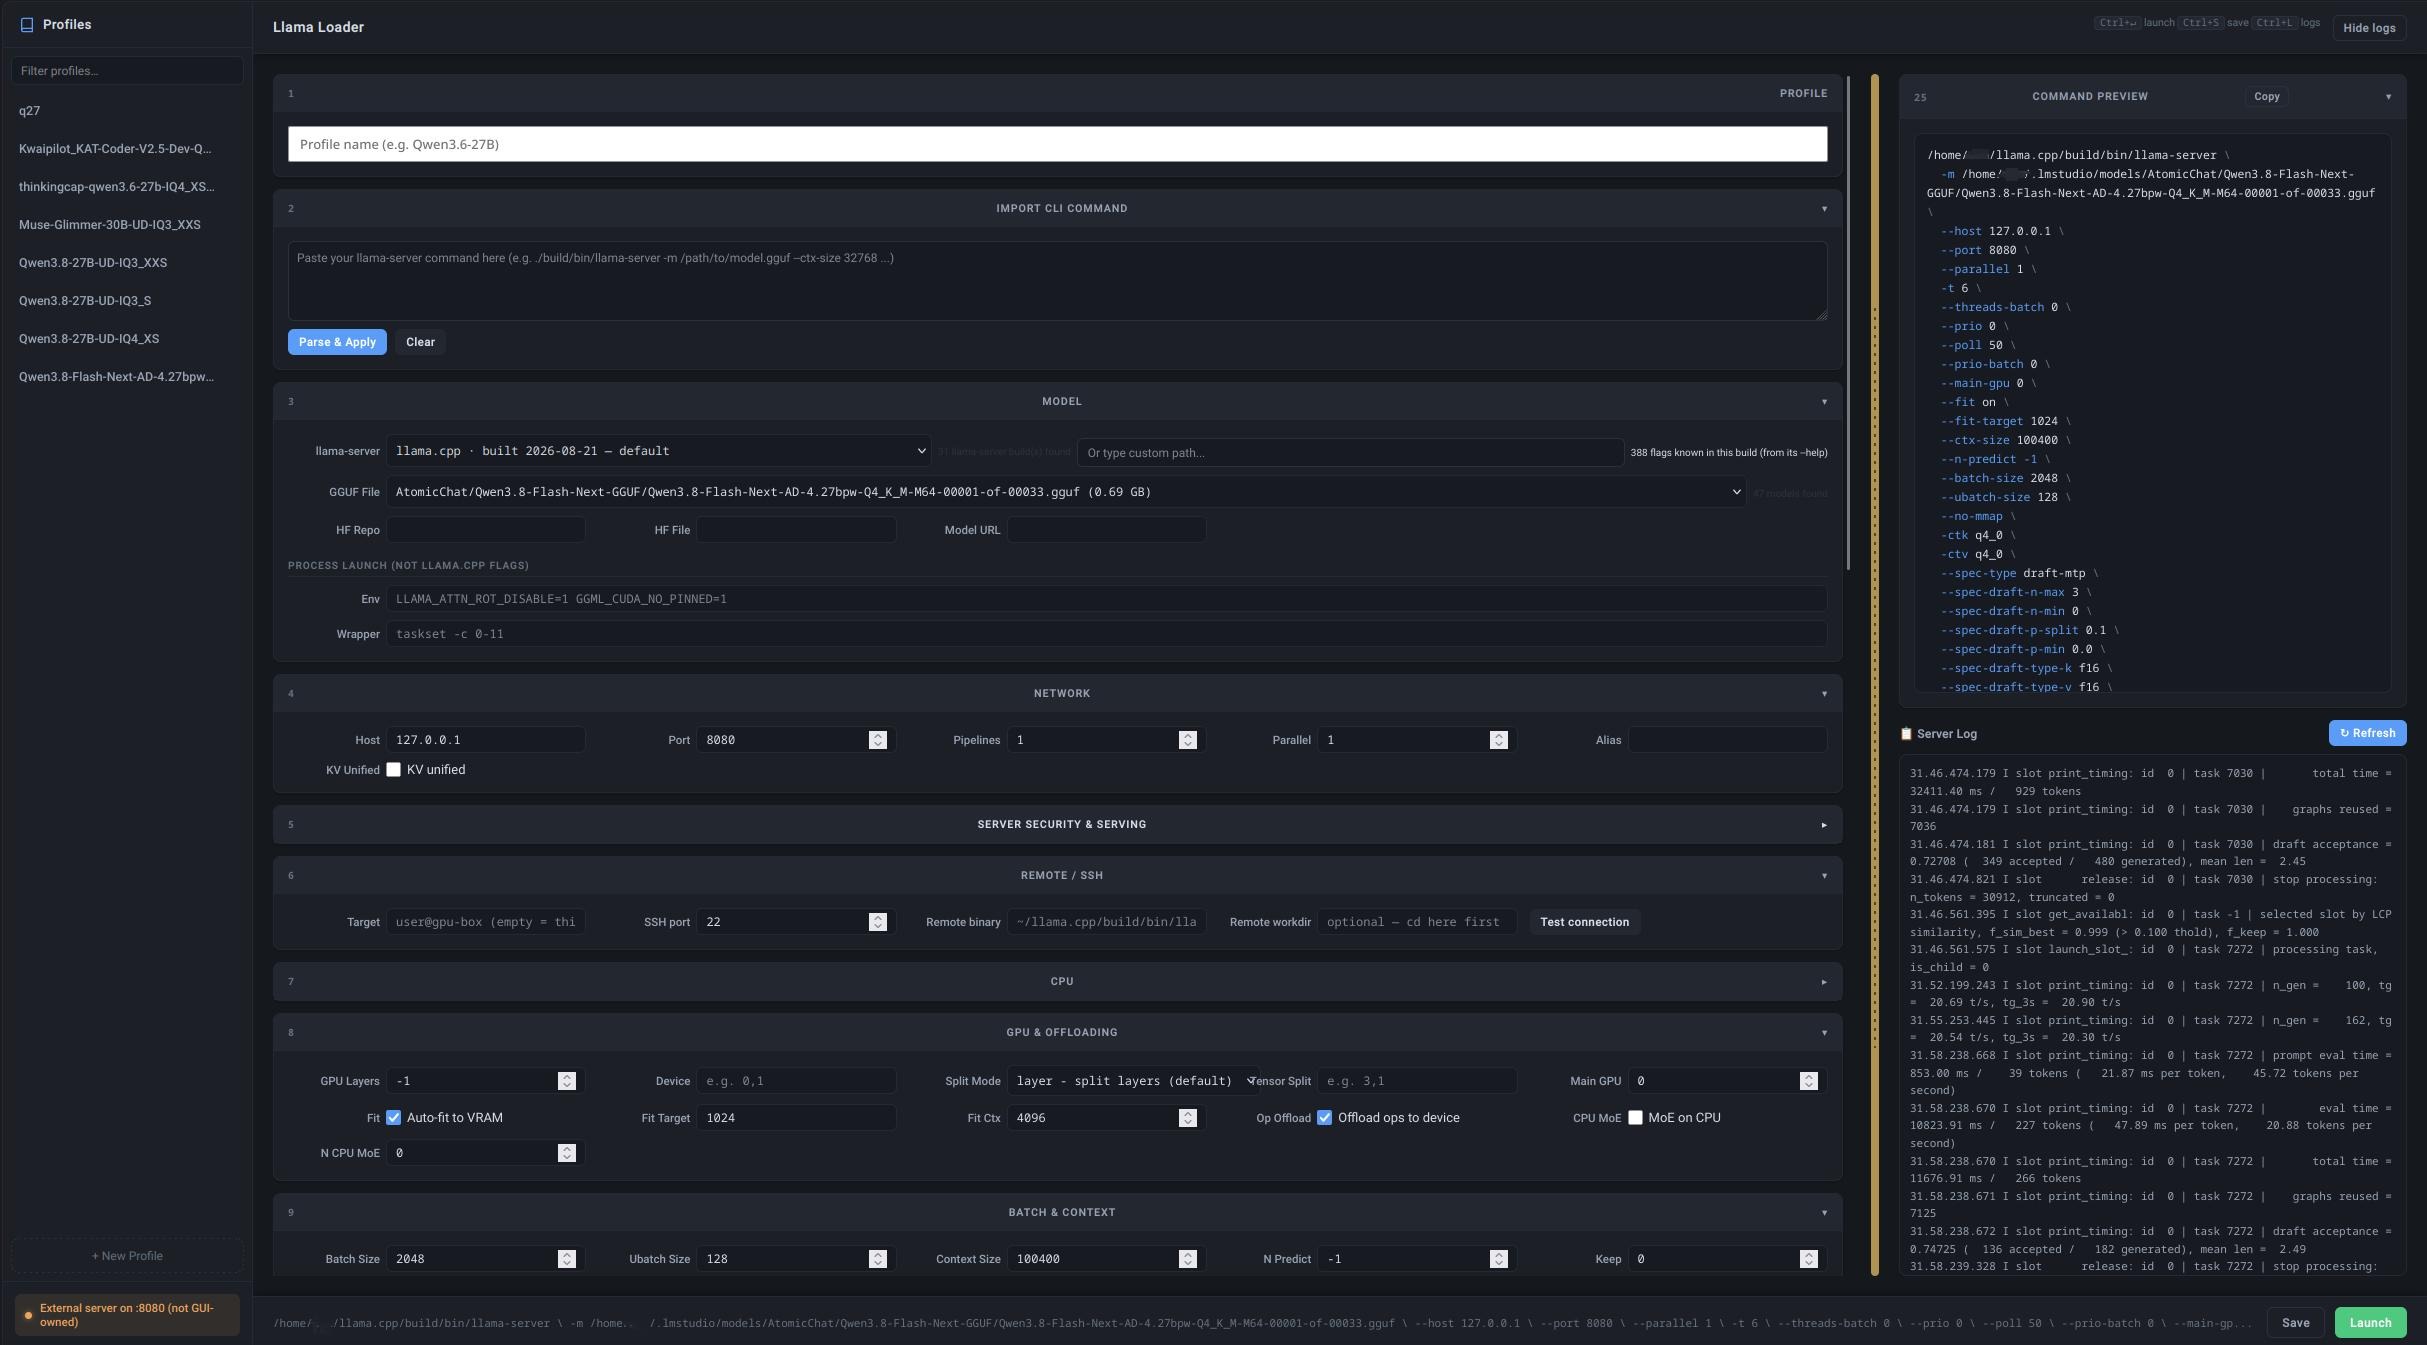
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Clonar repositorio y crear entorno virtual con Python 3.10+. Instalar dependencias desde requirements.txt. Copiar profiles.example.json a profiles.json para guardar configuraciones. Configurar ruta al binario llama-server (ej. ~/llama.cpp/build/bin/llama-server). Para remoto, usar ssh-copy-id para autenticación por claves. Opcional: habilitar systemd user unit para arranque automático en login. Servidor local solo accesible desde 127.0.0.1.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.