
llamactl
llamactl es un gestor unificado para modelos de IA (llama.cpp, MLX, vLLM) con panel web React y API compatible OpenAI/Anthropic. Permite descargar modelos GGUF/Safetensors, enrutamiento dinámico multi-modelo y gestión de recursos automática.
Ficha actualizada 26 sept 2026, 21:26 · upstream 26 sept 2026, 21:23 · release v0.21.2
Qué es llamactl
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
llamactl es una herramienta de gestión centralizada para inferencia de modelos de lenguaje, diseñada para simplificar el despliegue y administración de múltiples backends de IA. Soporta nativamente llama.cpp (CPU/GPU), MLX (Apple Silicon) y vLLM, además de servidores compatibles con la API OpenAI personalizados. La arquitectura separa el servidor de enrutamiento del backend de inferencia real, permitiendo ejecutar los modelos en contenedores Docker o localmente según las necesidades.
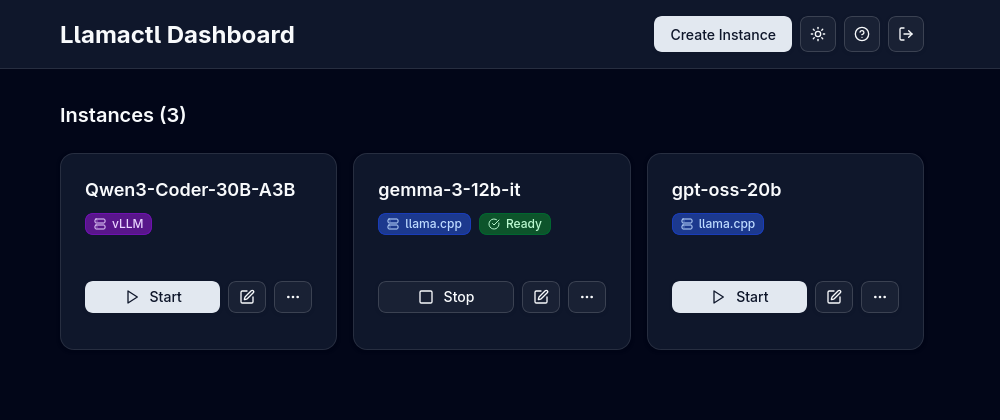
El sistema incluye un panel web moderno construido con React para la gestión visual de instancias, monitorización de salud y visualización de logs. La API expone endpoints compatibles con OpenAI (chat completions) y Anthropic (messages), permitiendo integrar llamactl en flujos de trabajo existentes sin cambios significativos en el código cliente. El enrutamiento inteligente permite dirigir solicitudes a diferentes modelos basándose en el nombre de instancia configurado.
La gestión de recursos incluye características como timeouts por inactividad, evicción LRU para liberar memoria automáticamente, y límites configurables por grupo de instancias. Esto facilita el despliegue eficiente en hardware limitado o entornos con múltiples usuarios compartiendo la misma infraestructura GPU. El sistema soporta descarga directa de modelos desde HuggingFace y gestión remota de instancias en hosts externos.
- Despliegue rápido de modelos LLM locales sin instalar dependencias manualmente usando contenedores Docker preconfigurados
- Gestión centralizada de múltiples instancias de modelos con límites de recursos por grupo para evitar saturación
- API compatible OpenAI/Anthropic para integrar modelos locales en aplicaciones existentes sin modificar el código cliente
- Enrutamiento dinámico entre diferentes modelos según la instancia solicitada, permitiendo pruebas A/B o selección de modelo por tarea
- Monitorización visual de salud de instancias y logs a través del panel web React para diagnóstico rápido
- Despliegue en Apple Silicon usando MLX optimizado nativamente para hardware M-series sin necesidad de GPU NVIDIA
- Soporte nativo para tres backends principales (llama.cpp, MLX, vLLM) más servidores compatibles OpenAI personalizados
- Panel web React moderno con monitorización en tiempo real y gestión visual de instancias
- Gestión automática de recursos con evicción LRU, timeouts por inactividad y límites configurables por grupo
- API compatible con estándares OpenAI y Anthropic para integración sencilla con clientes existentes
- Capacidad de descargar modelos directamente desde HuggingFace sin intervención manual del usuario
- Soporte para despliegue en contenedores Docker con gestión automática de GPU y mapeo de volúmenes
- Requiere Go 1.24+ y Node.js 22+ para compilación desde fuente, lo que puede ser una barrera para algunos usuarios
- La documentación original no especifica soporte explícito para ROCm o Intel GPU, aunque se menciona adaptación de imágenes base
- El sistema depende de backends externos (llama.cpp, vLLM, MLX) que deben estar disponibles o configurados en contenedores
- No hay soporte explícito para modelos quantizados Q4_K_M o formatos específicos más allá de GGUF y Safetensors mencionados
- La gestión remota requiere configuración manual de hosts externos sin autenticación por defecto robusta documentada
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Recomendado usar Docker para evitar instalaciones locales complejas. Configurar `backends.docker.enabled: true` en el archivo de configuración. Asegurar mapeo correcto de volúmenes para modelos y caché HuggingFace. Para producción, habilitar autenticación (`require_inference_auth: true`) y limitar `max_instances`. Monitorizar uso de memoria GPU y ajustar `default_idle_timeout` según carga esperada.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.