
Libry
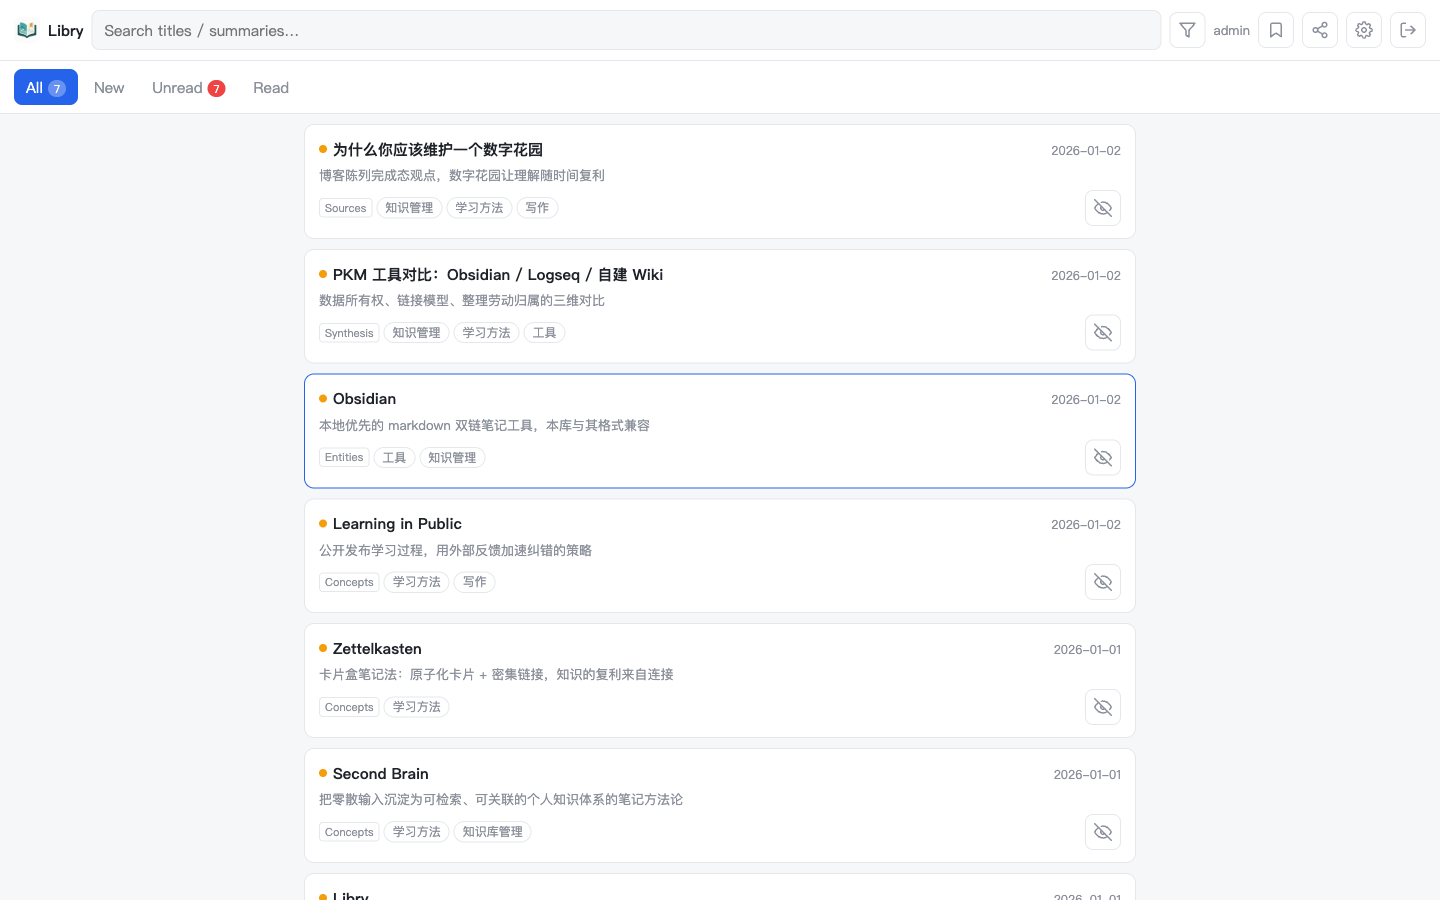
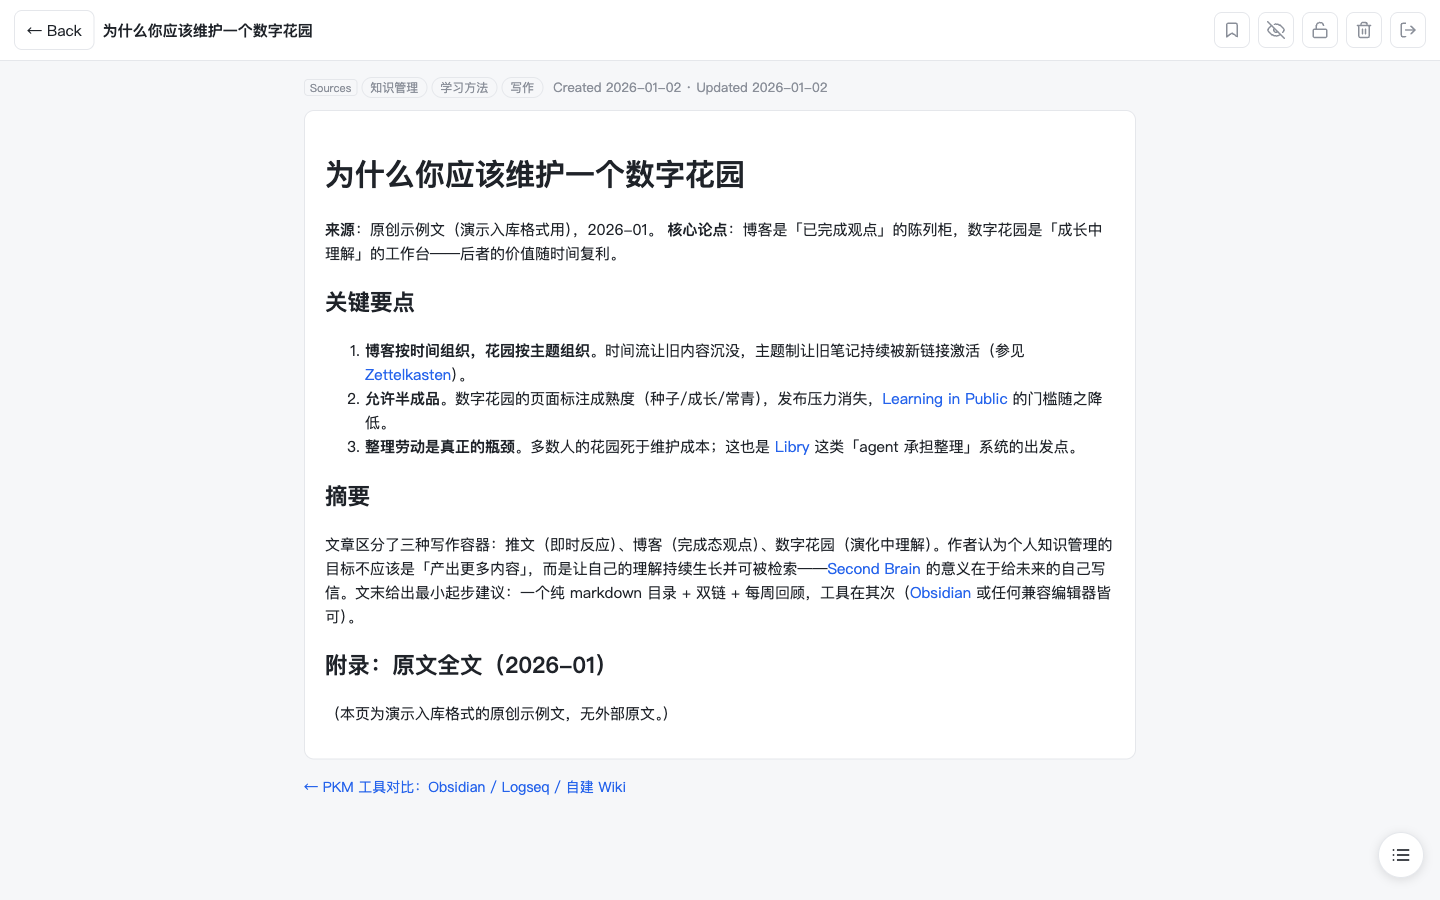
Libry es un motor de conocimiento personal basado en IA, mantenido por agentes autónomos. Permite almacenar y consultar información mediante markdown (compatible con Obsidian), con arquitectura separada entre el motor y el contenido.
Ficha actualizada 23 sept 2026, 13:35 · upstream 23 sept 2026, 13:27 · release sin release detectada
Qué es Libry
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
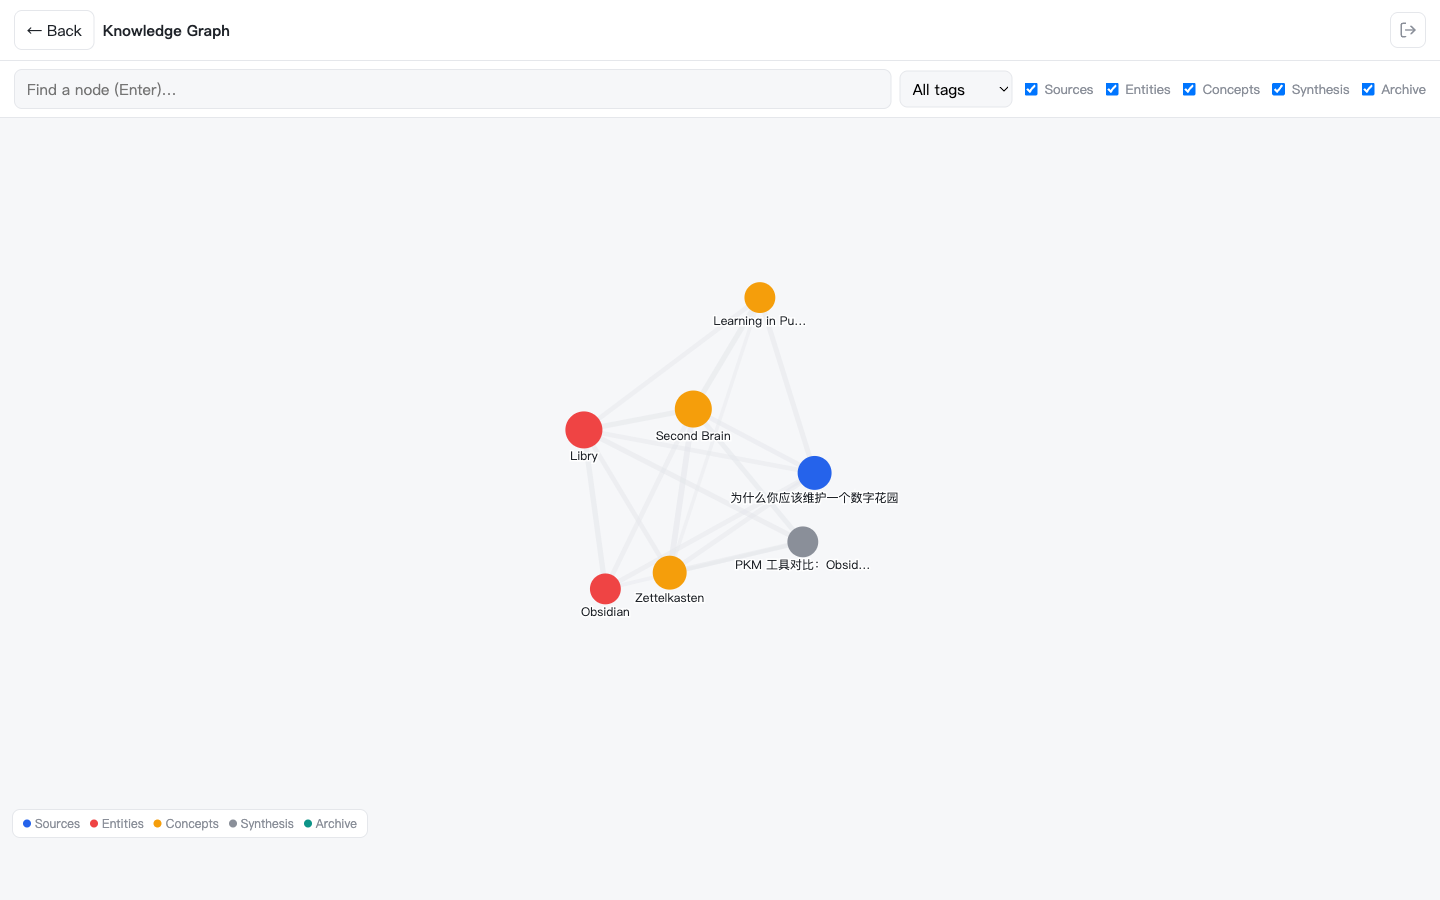
Libry es una base de conocimientos personal que puede ejecutarse localmente o en un servidor propio. Su arquitectura distingue claramente entre el motor del conocimiento (un pequeño paquete Python con FastAPI + Vue 3, sin build frontend) y el contenido (base de datos en markdown). Los agentes actúan como bibliotecarios: pueden ingestionar, organizar y verificar información mediante scripts automatizados. Se soporta múltiples cuentas, seguimiento de lectura, visibilidad personal/shared, un grafo de relaciones basado en embeddings y sincronización con git.
- Crear una base de conocimientos personal que sirva como segunda mente para el conocimiento técnico
- Automatizar la ingestión y validación de contenido mediante agentes de programación
- Organizar información técnica y documentación de proyectos personales
- Construir un sistema de búsqueda vectorial sobre documentos propios con grafo de relaciones
- Mantener múltiples cuentas de usuario con visibilidad diferenciada por documento
- Sincronización colaborativa entre dispositivos mediante CRDTs
- Arquitectura separada: el contenido (markdown) y el motor (FastAPI + Vue) están desacoplados, permitiendo escalar sin reestructurar todo
- Agentes autónomos como bibliotecarios: cualquier agente de programación puede ingestionar, lintear y publicar contenido siguiendo un contrato definido en AGENTS.md
- Sincronización multi-nodo con CRDTs para evitar conflictos entre dispositivos
- Grafo de relaciones basado en embeddings que permite búsquedas semánticas sobre documentos
- Modelo de seguridad robusto: hashing bcrypt, cookies signed y sanitización XSS mediante nh3
- No incluye un frontend completo por defecto; el cliente se ejecuta vía FastAPI/Node.js en la máquina del usuario
- La sincronización multi-nodo requiere configuración manual adicional (CRDTs)
- El grafo de relaciones es opcional y no incluido en la versión actual
- No incluye un editor de markdown integrado; el contenido debe ser editado manualmente o mediante agentes
- Depende de agentes externos para la ingestión, lo que introduce latencia si los agentes son lentos
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Para desplegar en una VPS Linux: usar `deploy/install.sh` con systemd y Caddy templates. Para macOS: usar launchd. El comando inicial es `libry init PATH`. Se recomienda alojar el motor FastAPI en un servicio separado (Docker o systemd) para escalar, manteniendo la lógica de agentes en el host local.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.