
lama-caravan
LAMA CARAVAN es un controlador local y multi-backend para el procesamiento adaptativo de computación en IA. Permite la distribución híbrida entre GPU locales y servicios cloud, con ruteo inteligente basado en tokens, gestión de colas, orquestación de tareas y monitoreo de recursos.
Ficha actualizada 23 sept 2026, 18:10 · upstream 23 sept 2026, 18:02 · release v1.3.132
Qué es lama-caravan
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
LAMA CARAVAN es un controlador local y multi-backend para el procesamiento adaptativo de computación en IA. Permite la distribución híbrida entre GPU locales y servicios cloud, con ruteo inteligente basado en tokens, gestión de colas, orquestación de tareas y monitoreo de recursos.
El proyecto resuelve problemas comunes en entornos de IA: los agentes de IA (como OpenClaw o Hermes) consumen tokens constantemente, las máquinas con GPUs están paradas por completo y sus computadoras de nube tienen límites de cuota y tasa. LAMA CARAVAN integra todo en un sistema donde los tokens se procesan donde sea que tenga sentido — localmente cuando la hardware lo permite, o en la nube cuando no.
Se presenta como una solución ligera: utiliza Python estándar para HTTP y estáticos (HTML/CSS/JS), sin dependencias externas críticas. Su arquitectura central es el controlador, mientras que los agentes se conectan a través de un proxy con portos fijos.
- Gestionar múltiples agentes de IA (OpenClaw, Hermes) en una infraestructura mixta local y cloud
- Ruteo inteligente de tokens entre GPU locales y servicios cloud según disponibilidad
- Orquestación de tareas de IA con colas de espera y prioridades por agente
- Monitoreo de uso de tokens, costos y rendimiento por agente o backend
- Conexión segura a modelos de IA (OpenAI, Anthropic) sin necesidad de credenciales locales
- Procesamiento de voz (STT/TTS) con modelos como Whisper, GigaAM y CosyVoice
- Clonación de voces mediante TTS (CosyVoice2) para aplicaciones de chat o voz
- Gestión de hardware compartido entre múltiples agentes en una misma máquina
- Ruteo inteligente basado en tokens: los agentes nunca necesitan reconfigurarse al cambiar modelo o mover GPU
- Soporte para modelos OpenAI-compatible (OpenRouter, Anthropic) sin necesidad de credenciales locales
- Colas de espera con keepalives que mantienen el stream activo hasta recibir tokens reales
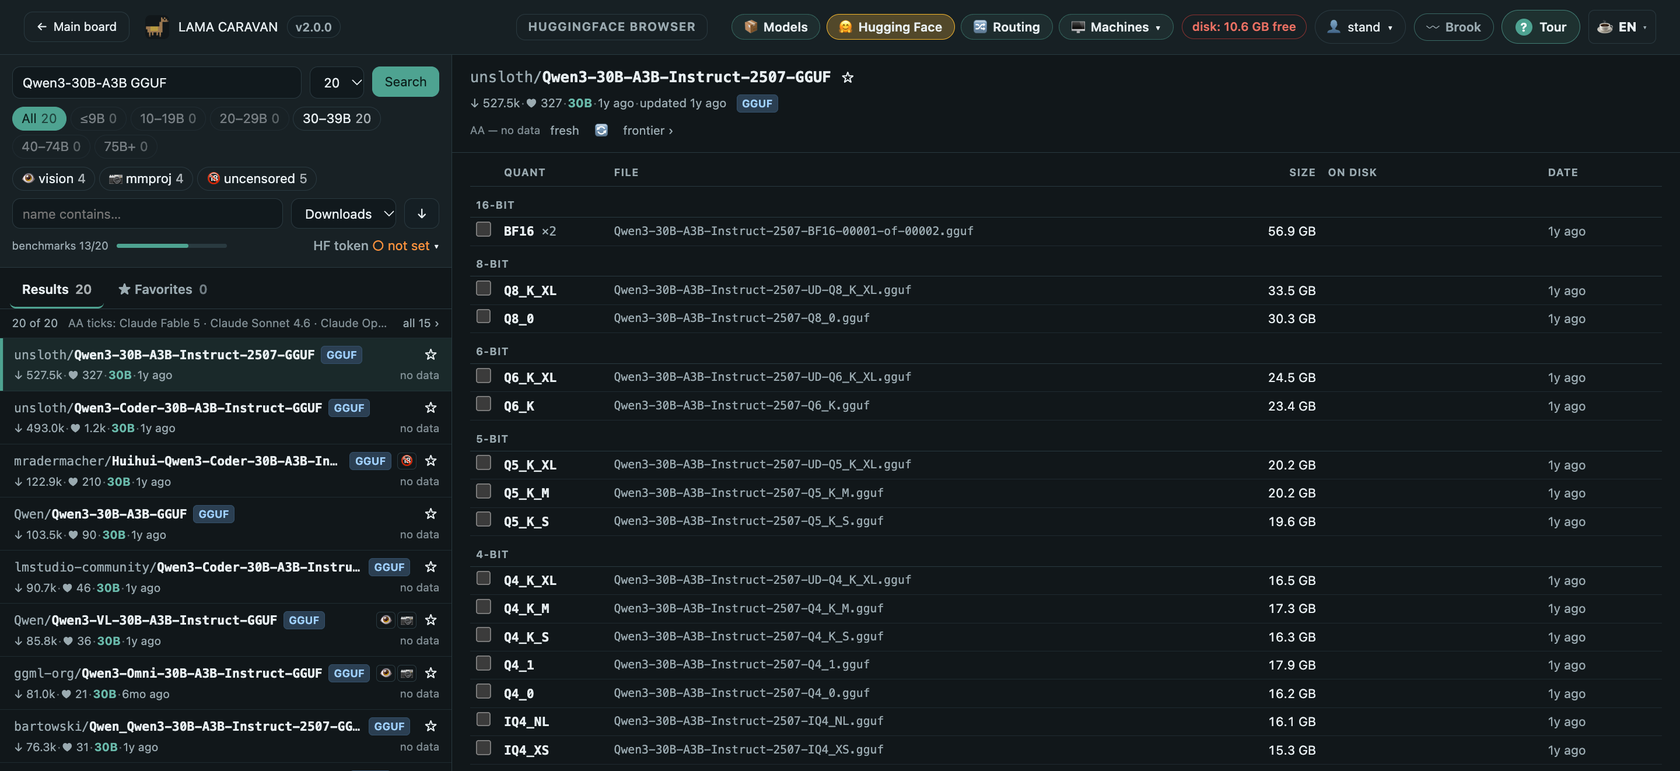
- Modelos predescargados desde HuggingFace directamente en el controlador
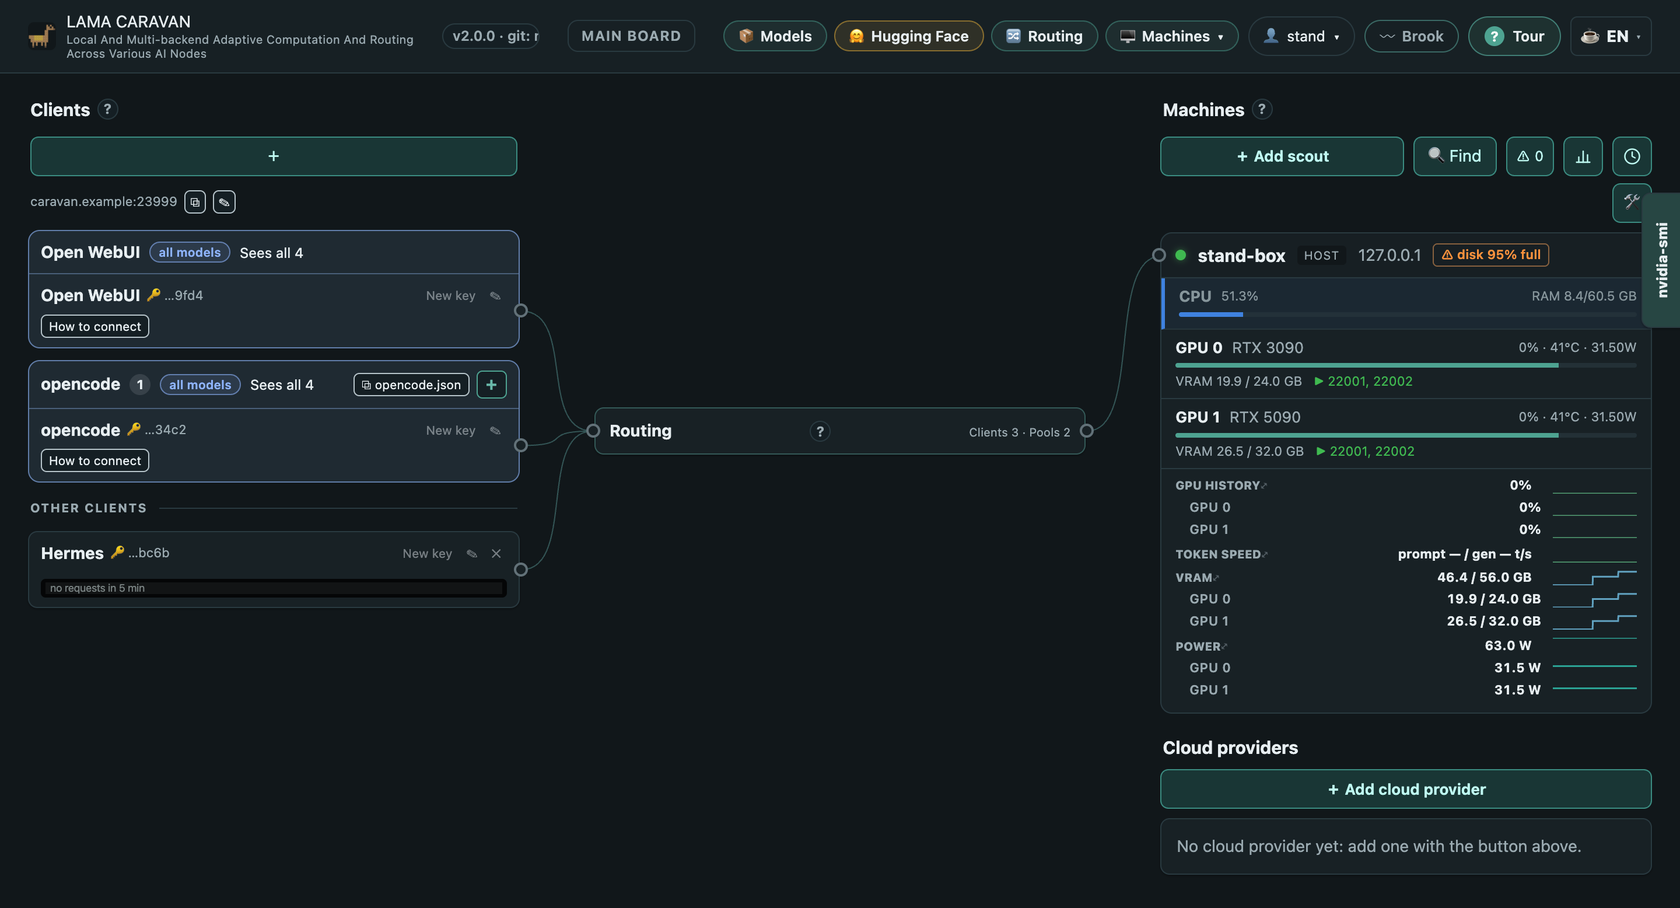
- Monitoreo visualizado a través de una topología gráfica con estado real de GPU y CPU
- Soporte para múltiples engines (llama.cpp, vLLM, whisper, moonshine, Seamless) con gestión unificada
- Modelos comerciales como CosyVoice2 disponibles sin licencias propietarias
- El ruteo entre GPU local y cloud depende de la disponibilidad del backend cloud (no hay fallback automático)
- Los agentes que no tienen timeout configurado pueden quedarse esperando en cola
- La gestión de hardware compartido requiere configuración manual por parte del usuario
- No incluye un backend de base de datos externo: el estado se persiste en archivos JSON y SQLite local
- El rendimiento depende de la capacidad de los GPU locales disponibles (no hay optimización automática)
- Los modelos de voz como Whisper requieren descargarlos manualmente antes de usarlos
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.


Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Instalación: ejecutar `pip install -r requirements.txt` y `python app.py`. Para producción, se recomienda Docker con un contenedor del controlador. El agente debe ser ejecutado en el mismo host que el controlador para compartir hardware (GPU o CPU). Se puede usar systemd/launchd para automatizar arranque. No requiere base de datos externa; todo estado persiste localmente. Para escalar, añadir más GPUs locales se realiza mediante la interfaz gráfica del controlador.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.