
konusbitr
Konusbitr es una alternativa open-source auto-hospedable a PDF.ai para chat con documentos PDF con citas verificables al nivel de página y resaltado automático. Arquitectura híbrida TypeScript/Python con Redis como bus de mensajes.
Ficha actualizada 27 sept 2026, 8:34 · upstream 27 sept 2026, 8:33 · release sin release detectada
Qué es konusbitr
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Konusbitr es una plataforma open-source auto-hospedable que permite interactuar con documentos PDF mediante chat, obteniendo respuestas con citas precisas al nivel de página y resaltado automático de las fuentes. El proyecto funciona como alternativa directa a soluciones comerciales como PDF.ai.
La arquitectura utiliza Next.js 15 con React 19 para la interfaz web y FastAPI en Python 3.12 para el procesamiento de documentos. La comunicación entre los dos runtime se realiza mediante streams de Redis con payloads JSON, sin compartir ORM ni frameworks RPC. Los esquemas Zod en packages/shared son la fuente única de verdad, generando automáticamente modelos Pydantic en el worker y nombres de claves Redis.
El sistema incluye almacenamiento compatible con S3 (MinIO), base de datos PostgreSQL con pgvector para embeddings, y soporte para múltiples proveedores de LLM incluyendo Ollama para modo offline completo. La autenticación soporta email/password y magic links por defecto, con OAuth opcional mediante configuración.
- Análisis documental con citas verificables al nivel de página
- Chat con documentos PDF con resaltado automático de fuentes
- Modo offline completo con Ollama sin enviar datos a proveedores externos
- API REST compatible con PDF.ai-wire para integración con otros sistemas
- Reconstrucción automática de tablas y descripción de figuras en documentos escaneados
- Sistema de autenticación con múltiples métodos (email, magic links, OAuth)
- Citas verificables al nivel de página con resaltado automático preciso
- Arquitectura híbrida TypeScript/Python optimizada para cada tarea específica
- Soporte nativo para OCR multilingüe con PaddleOCR y Surya
- Modo offline completo con Ollama sin dependencia de proveedores cloud
- Sistema de esquemas Zod como fuente única de verdad entre runtime
- Compatibilidad con API PDF.ai-wire para interoperabilidad
- Requiere Docker para despliegue, sin soporte one-click
- Configuración manual obligatoria de variables de entorno antes de producción
- Dependencia de bibliotecas Python específicas (Docling, PaddleOCR, Surya)
- Modo offline requiere pre-pull de modelos en Ollama
- Sin soporte para GPU nativo en configuración actual
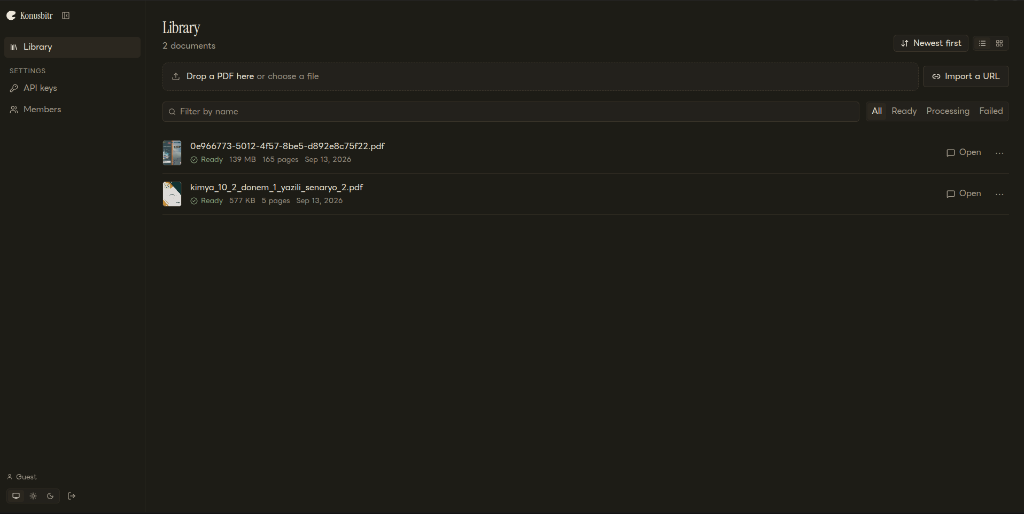
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.

Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Requiere Docker como única dependencia. Copiar .env.example a .env antes de ejecutar docker compose up. Para modo offline con Ollama, añadir --profile local-llm y configurar OFFLINE_MODE=true. Cambiar todas las credenciales del archivo .env antes de exponer en red, especialmente AUTH_SECRET que impide inicio si APP_URL no es localhost. El sistema aplica migraciones automáticamente al iniciar.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.