
KnowTrace
KnowTrace es un sistema ligero de gestión de conocimiento con enfoque 'recordar primero, organizar con IA'. Utiliza Next.js, React y Go para autenticación independiente, priorizando la integridad de los datos originales mediante control estricto de versiones y separación clara entre captura y proces
Ficha actualizada 27 sept 2026, 12:37 · upstream 27 sept 2026, 12:12 · release sin release detectada
Qué es KnowTrace
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
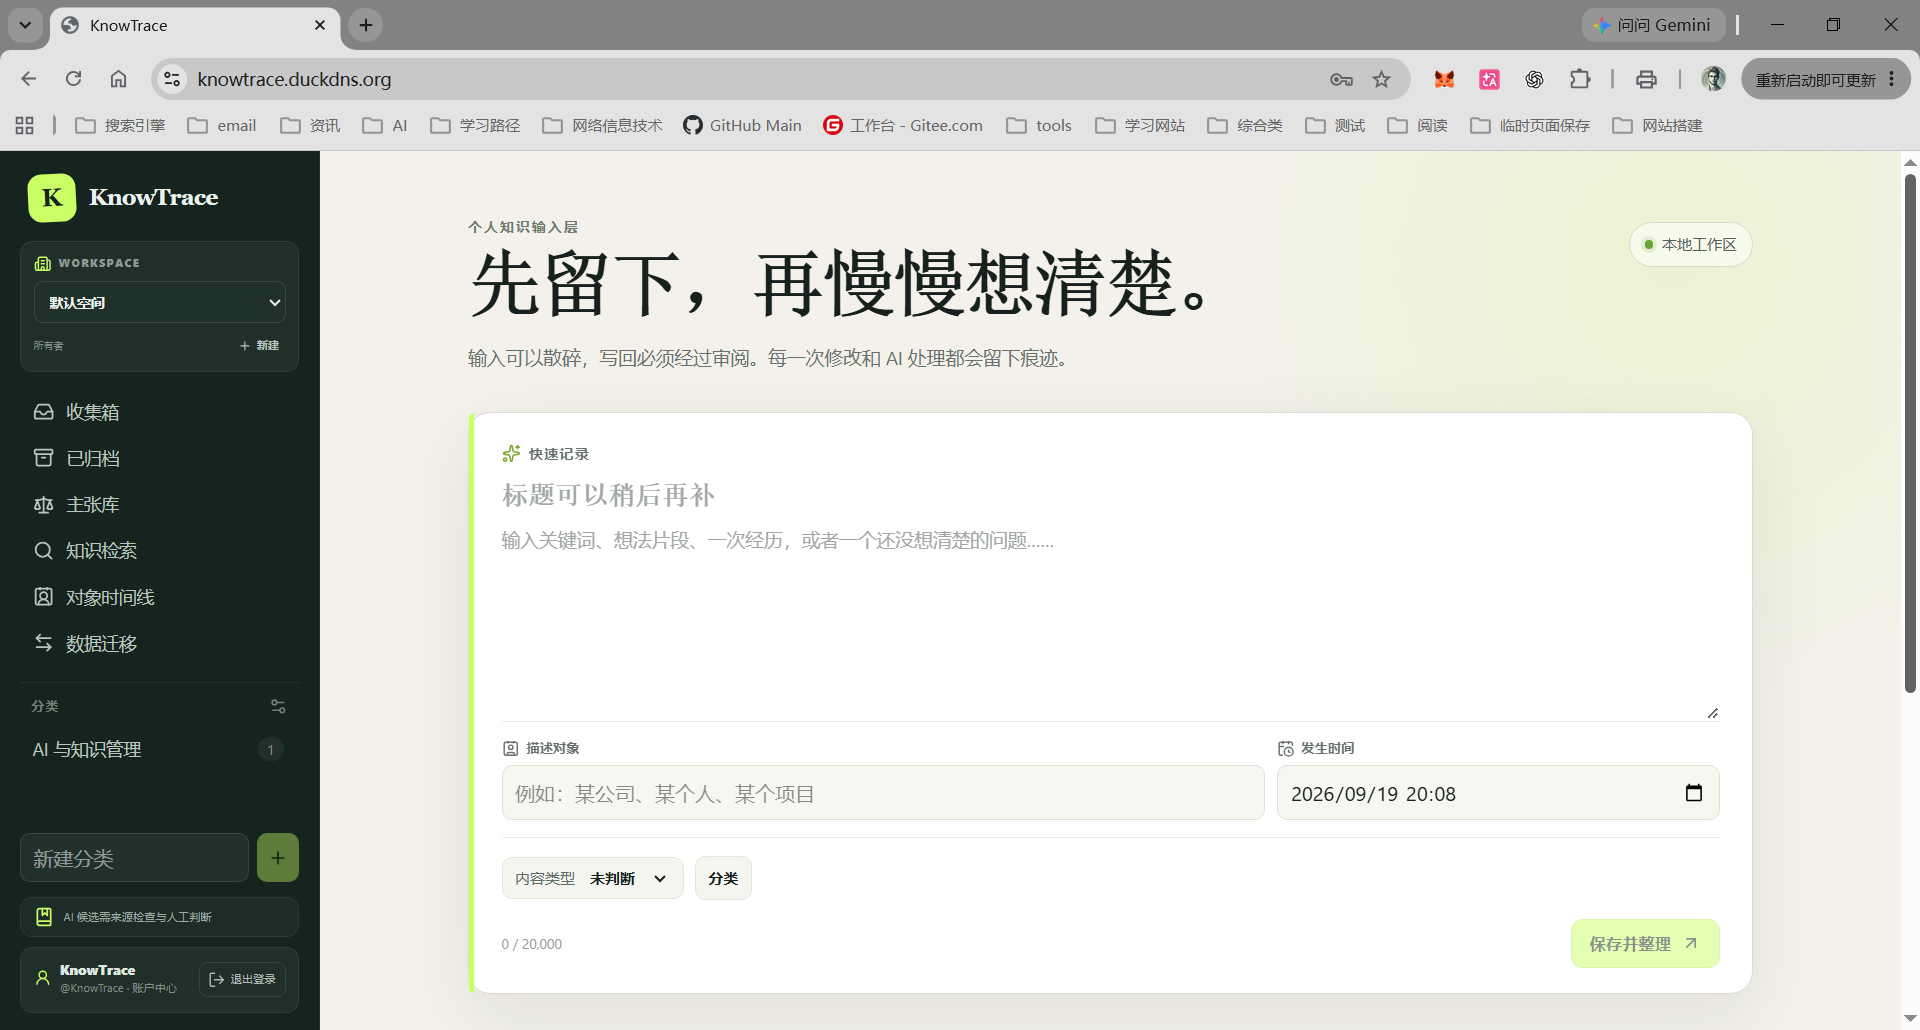
KnowTrace es un sistema de gestión de conocimiento ligero diseñado para entornos personales o grupos pequeños en redes confiables. Su filosofía central es 'recordar primero, organizar con IA', lo que garantiza que el contenido original se preserve intacto antes de cualquier intervención automática. El sistema separa claramente la captura de datos del procesamiento por inteligencia artificial, evitando que sugerencias automáticas corrompan registros sin consentimiento explícito del usuario.
La arquitectura técnica combina Next.js con App Router y TypeScript para el frontend, mientras que la autenticación está delegada a un servicio independiente escrito en Go (go-user-system) que utiliza MySQL y Redis. Este enfoque modular permite una gestión robusta de sesiones y roles mediante RBAC, donde los administradores pueden compartir contenido globalmente mientras los miembros mantienen privacidad sobre sus datos privados. El sistema incluye mecanismos avanzados de control de versiones para revisiones de texto y gestión de estados de evidencia, asegurando trazabilidad completa en procesos de investigación o auditoría.
El proyecto ofrece soporte nativo para múltiples proveedores de IA mediante una capa de adaptadores (Provider Adapter), permitiendo compatibilidad inicial con OpenAI y DeepSeek. Incluye herramientas de automatización como Makefile y Docker Compose para despliegue simplificado, junto con scripts de backup y restore que cubren tanto bases de datos como archivos de evidencia. La documentación es exhaustiva, incluyendo contratos API definidos para futuras integraciones móviles.
- Gestión personal de conocimiento con verificación humana estricta de fuentes antes de publicar conclusiones
- Auditoría de información mediante trazabilidad completa de evidencias y snapshots inmutables de fuentes
- Preparación de informes confiables con revisión por pares integrada en el flujo de trabajo
- Investigación académica o periodística con control de calidad documental y separación clara entre datos crudos y análisis
- Arquitectura modular con autenticación independiente en Go que evita acoplamiento con frameworks JS para seguridad
- Sistema de revisiones que previene corrupción de datos originales mediante bloqueo de escritura hasta confirmación explícita
- Soporte nativo para múltiples proveedores de IA vía adaptadores sin necesidad de reconfiguración del backend
- Documentación técnica exhaustiva con contratos API definidos y scripts automatizados para backup/restore
- No soporta RAG ni vectorización nativa actualmente, limitando aplicaciones de búsqueda semántica avanzada
- Requiere configuración manual de certificados SSL y reglas de firewall para despliegue seguro en producción
- La autenticación depende del servicio externo go-user-system sin fallback local si falla la conexión
- Falta soporte móvil nativo aunque existe API preparada, requiriendo desarrollo adicional para apps móviles
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Recomendaciones de despliegue: usar Docker Compose con variables de entorno seguras almacenadas en .env; habilitar HTTPS obligatorio en producción cambiando AUTH_COOKIE_SECURE=true; cambiar credenciales por defecto inmediatamente tras el primer arranque; configurar reglas de firewall para limitar acceso a puertos críticos como 3000 y 8082 solo a IPs confiables; realizar backups regulares incluyendo PostgreSQL, MySQL del servicio de autenticación y directorio data/uploads/evidence.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.