
keep
Plataforma open-source de AIOps y gestión de alertas con paneles unificados, deduplicación, correlación e integraciones bidireccionales para monitorización y automatización de incidentes.
Ficha actualizada 10 nov 2026, 12:25 · upstream 10 nov 2026, 12:22 · release v0.55.0
Qué es keep
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Keep es una plataforma open-source diseñada para la gestión centralizada de alertas y operaciones de inteligencia artificial (AIOps). Ofrece una interfaz única para visualizar todos los alertas e incidentes, permitiendo deduplicación, enriquecimiento, filtrado y correlación automática de datos. La arquitectura soporta múltiples bases de datos como PostgreSQL, MySQL, MongoDB, Elasticsearch, OpenSearch y ClickHouse, además de mensajería con Kafka.
La plataforma integra capacidades avanzadas de IA para la correlación de incidentes y resumen de contexto, compatible con diversos backends como OpenAI, Anthropic, Ollama y LlamaCPP. Esto permite a los equipos de SRE o DevOps automatizar flujos de trabajo complejos mediante GitHub Actions y sincronización bidireccional con herramientas de monitorización existentes.
Los casos de uso incluyen la consolidación de alertas de múltiples fuentes en un solo lugar, la reducción del ruido mediante deduplicación inteligente, la creación de workflows de respuesta automática a incidentes y el análisis de contexto de fallos utilizando modelos de lenguaje locales o en la nube. Es ideal para equipos que buscan evitar vendor lock-in y mantener control sobre sus datos de observabilidad.
- Consolidar alertas de múltiples herramientas de monitorización (Datadog, Prometheus, Grafana) en una sola interfaz unificada.
- Reducir el ruido operativo mediante deduplicación y correlación automática de incidentes relacionados.
- Automatizar respuestas a incidentes utilizando workflows personalizados con GitHub Actions e integraciones bidireccionales.
- Enriquecer alertas con contexto técnico usando modelos de IA locales (Ollama) o en la nube (OpenAI, Anthropic).
- Gestionar bases de datos heterogéneas (PostgreSQL, MongoDB, ClickHouse) desde una única plataforma de gestión.
- Soporte nativo para múltiples backends de IA (OpenAI, Anthropic, Ollama, LlamaCPP, Gemini, Grok, DeepSeek).
- Arquitectura flexible con soporte para diversas bases de datos y motores de búsqueda (Elasticsearch, OpenSearch, ClickHouse).
- Integraciones bidireccionales predefinidas con más de 50 herramientas de observabilidad y gestión de infraestructura.
- Interfaz gráfica personalizada para visualización de incidentes y dashboards en tiempo real.
- Capacidad de automatización mediante GitHub Actions para orquestar respuestas a alertas sin intervención manual.
- Requiere configuración manual de múltiples dependencias (bases de datos, brokers de mensajes) al no soportar despliegue con un clic.
- Complejidad alta en la instalación inicial debido a la necesidad de configurar PostgreSQL, Kafka y otros servicios externos.
- Dependencia de recursos significativos para el despliegue local (mínimo 4 núcleos CPU y 8 GB RAM recomendados).
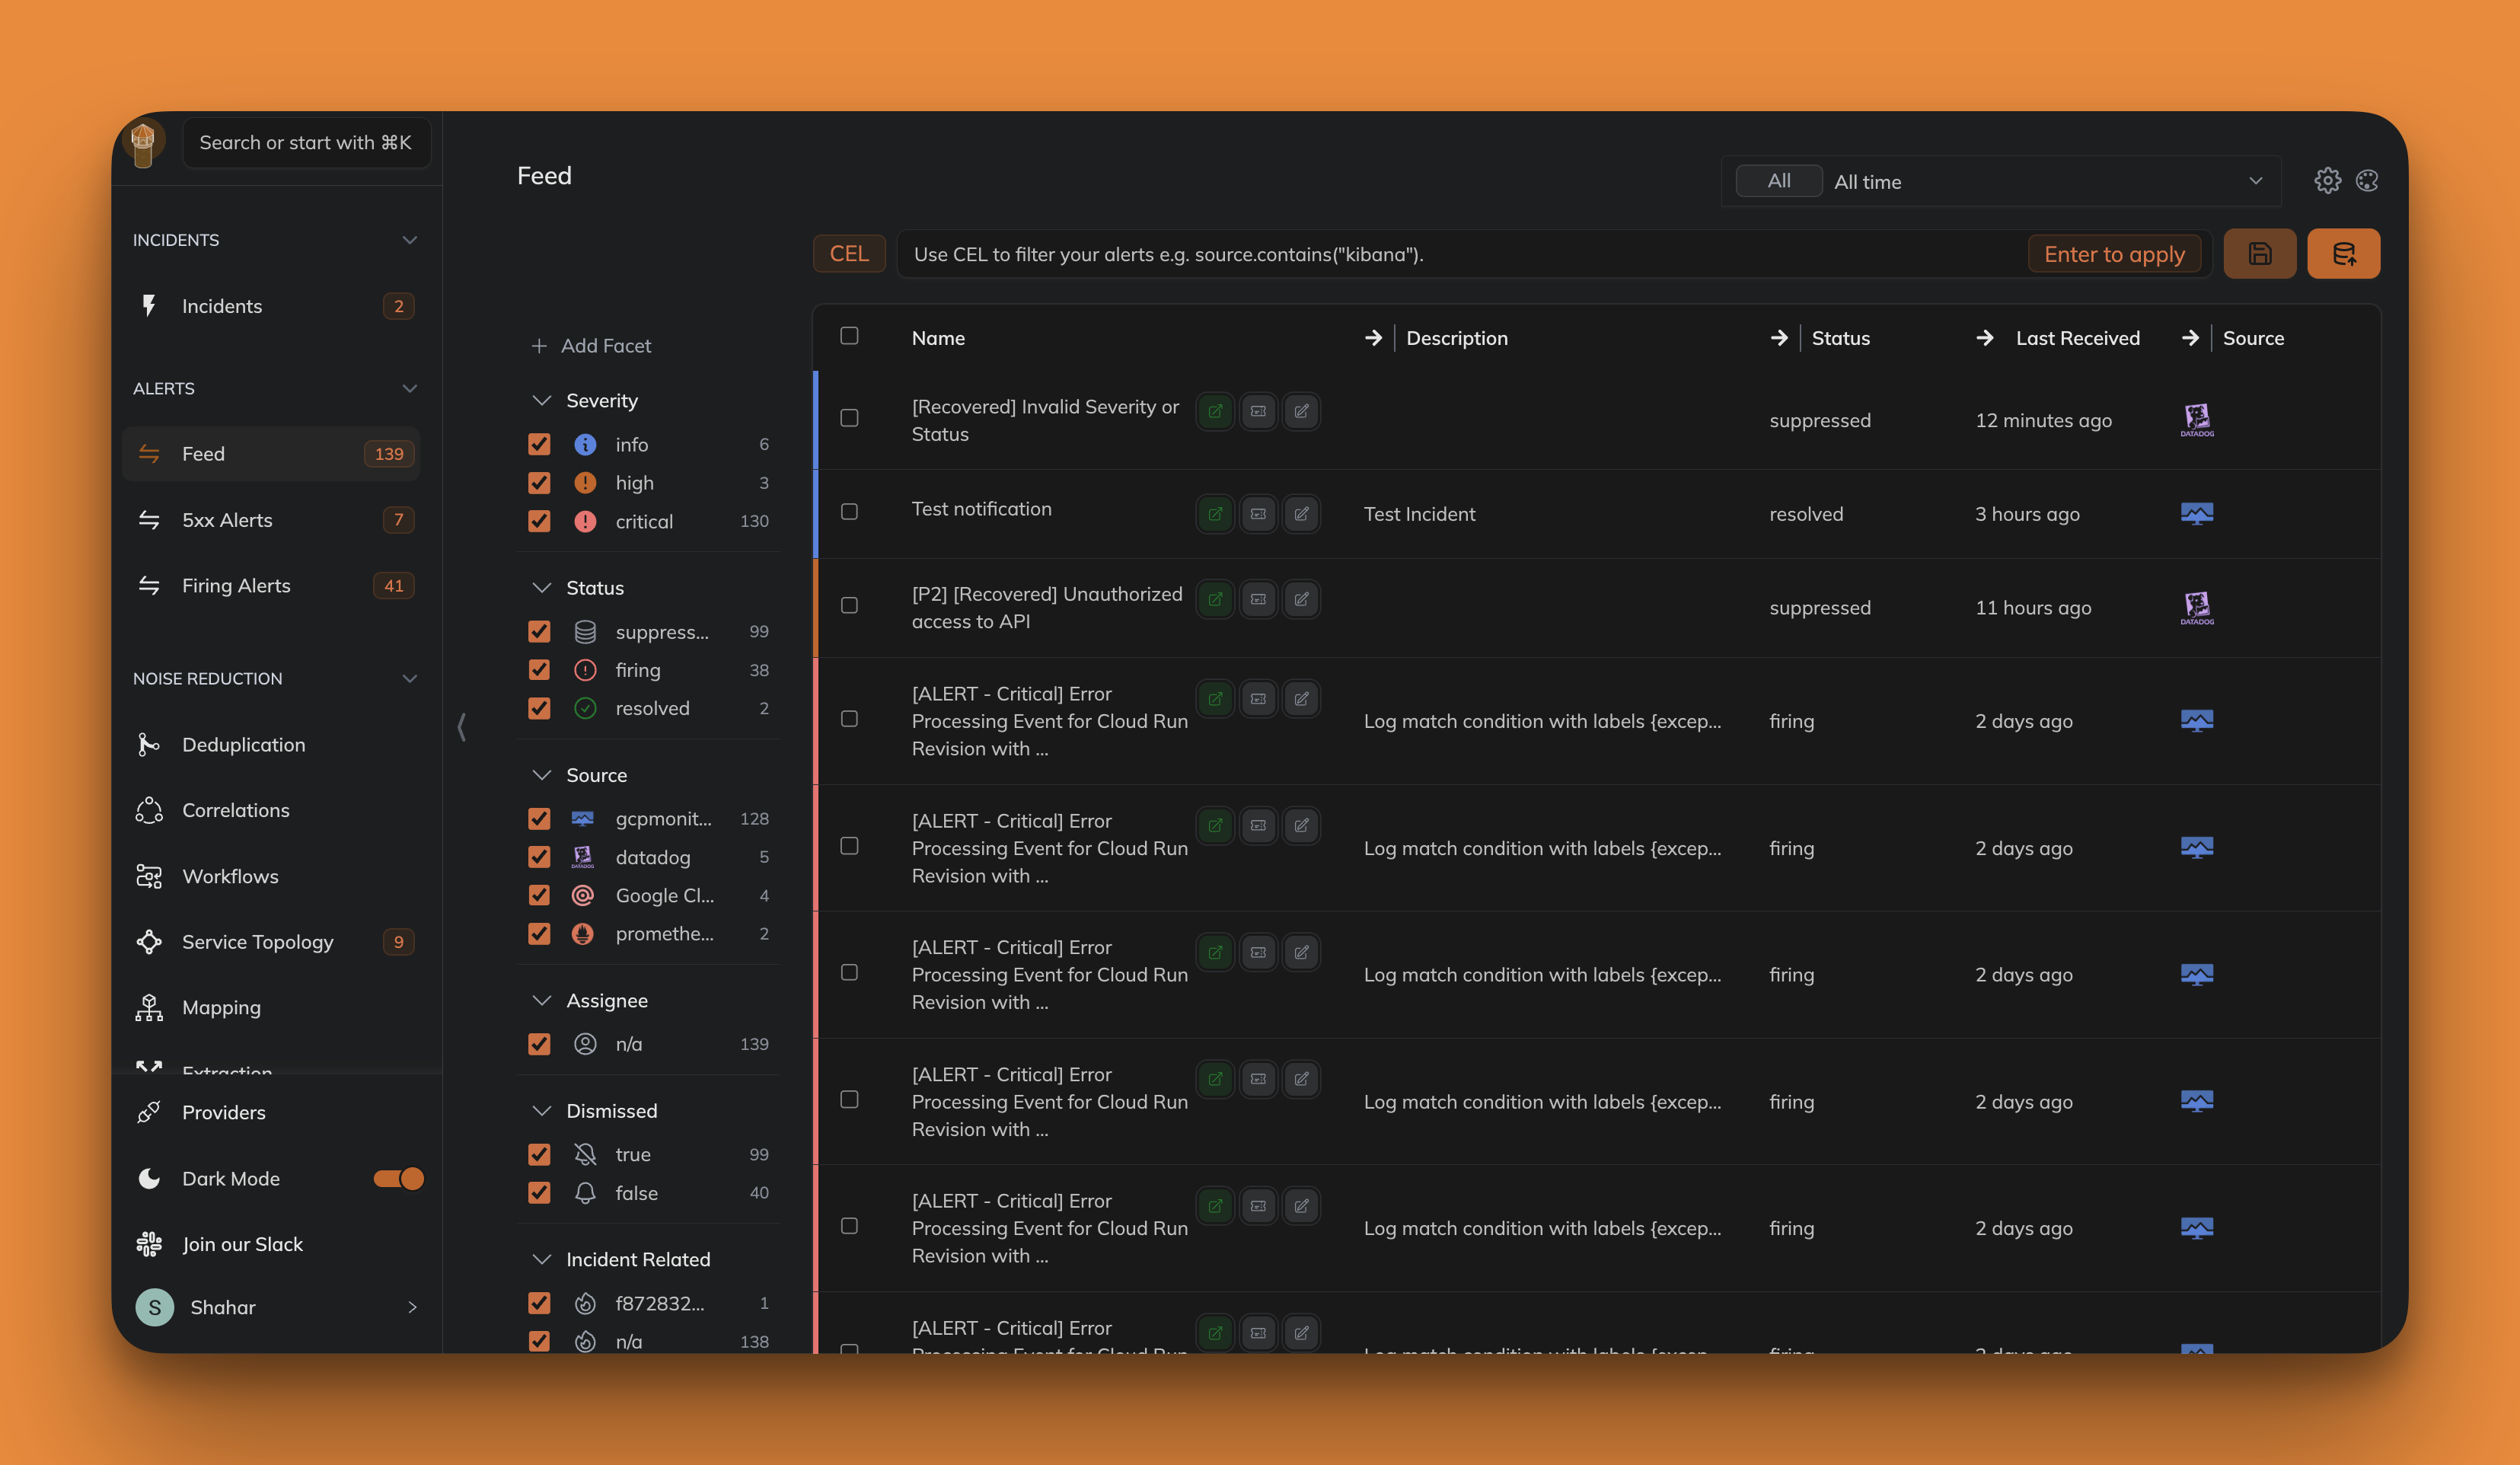
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.


Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Pendiente de la cola editorial R11-R6 con investigación verificable.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.