
keel
Pipeline abierto para automatización honesta de candidaturas laborales. Verifica perfiles, genera paquetes de aplicación y detecta ATS sin inventar datos. Python puro, Apache-2.0, sin Docker.
Ficha actualizada 24 sept 2026, 11:36 · upstream 24 sept 2026, 11:34 · release v0.2.0
Qué es keel
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Keel es un sistema de automatización para procesos de candidatura laboral que prioriza la honestidad sobre la velocidad. El pipeline público incluye módulos para descubrimiento de ofertas, puntuación de fit, personalización de CVs, detección de ATS y generación de paquetes de aplicación verificados. La arquitectura se basa en Python 3.10+ con stdlib únicamente, sin dependencias externas ni Docker.
El enfoque central es el "contrato de automatización honesta": nunca inventa cualificaciones, reporta brechas explícitamente, falla cerrado ante datos no verificables y evita dejar huellas detectables por ATS. El repositorio público contiene la disciplina y herramientas; la capa de ejecución privada mantiene los datos sensibles fuera del alcance de análisis automatizado.
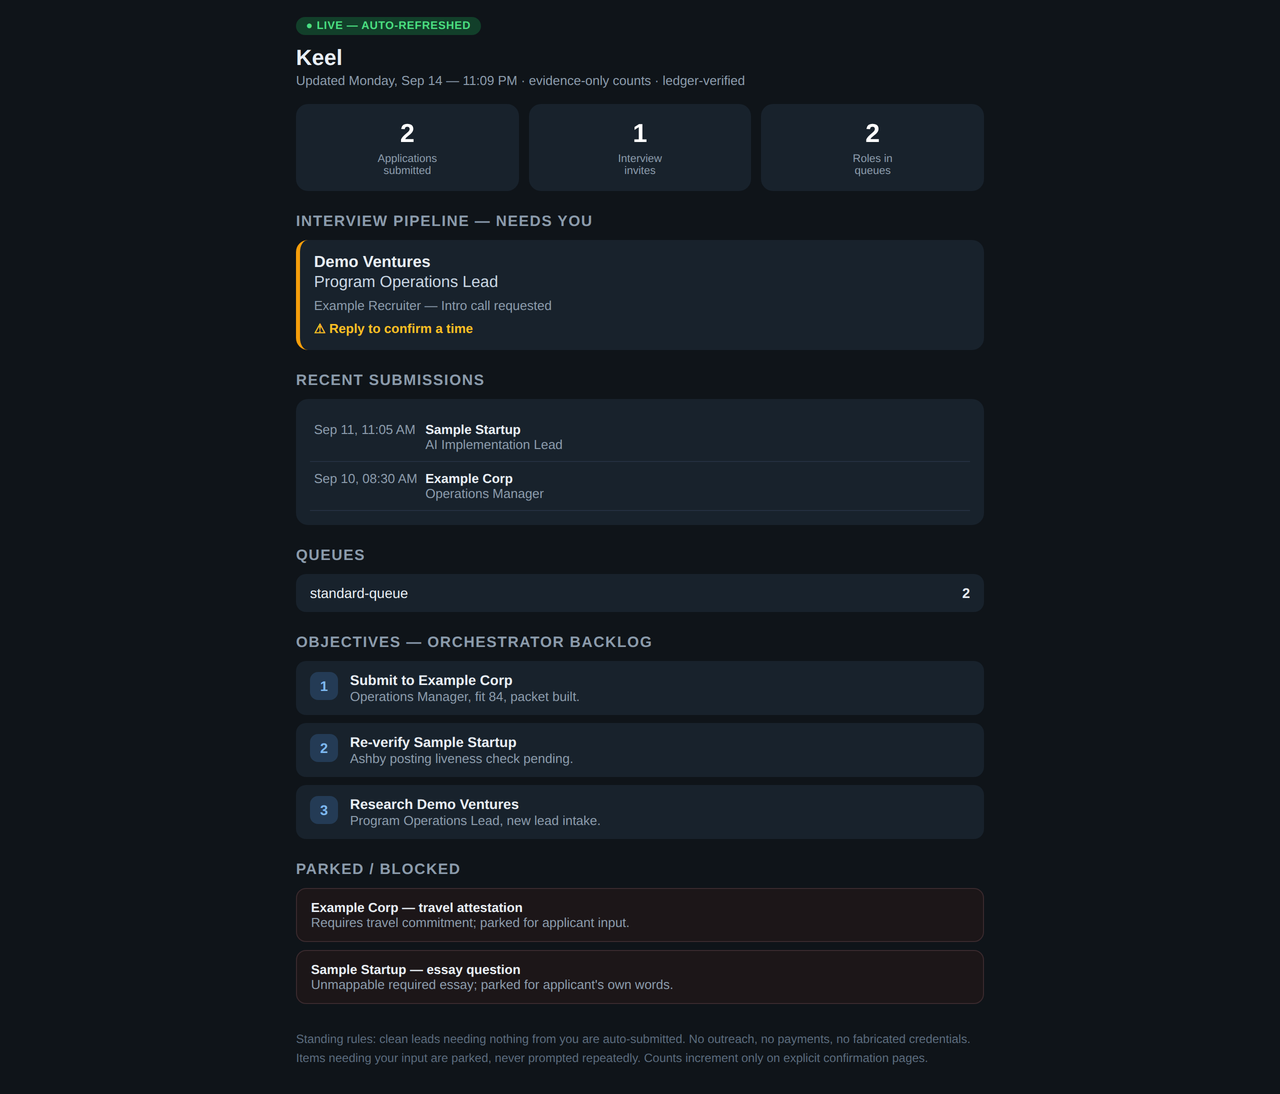
El sistema incluye módulos modulares en engines/ para cada fase del proceso (descubrimiento, scoring, materiales, prescreening, detección ATS, bucle de aplicación, verificación, telemetría) y un dashboard HTML autocontenido. Los datos se gestionan mediante ledger, colas JSON y archivos de configuración personalizados.
- Descubrimiento automático de ofertas laborales en múltiples plataformas
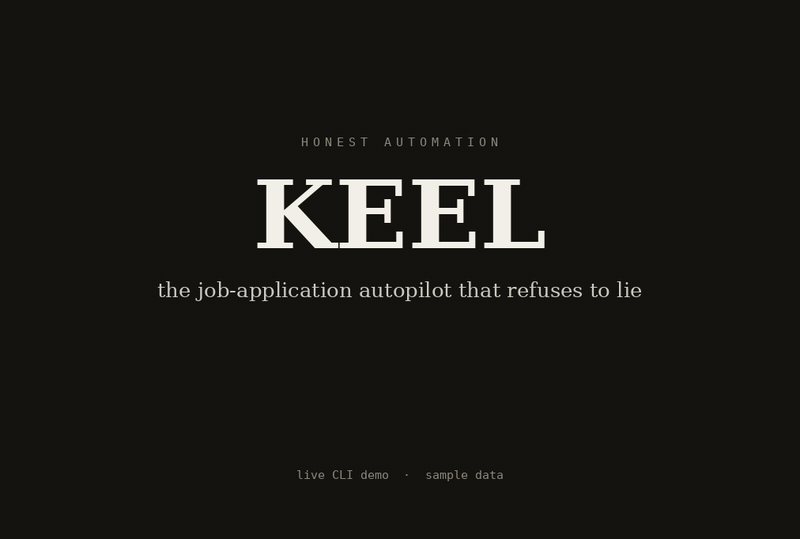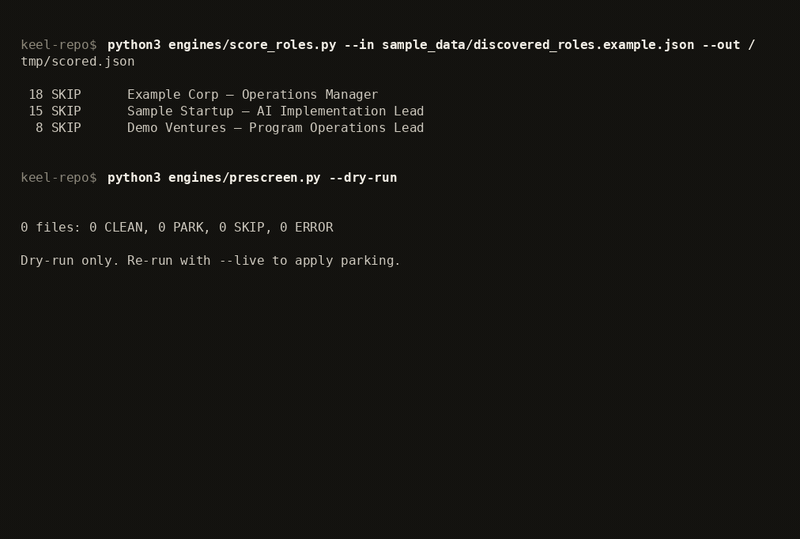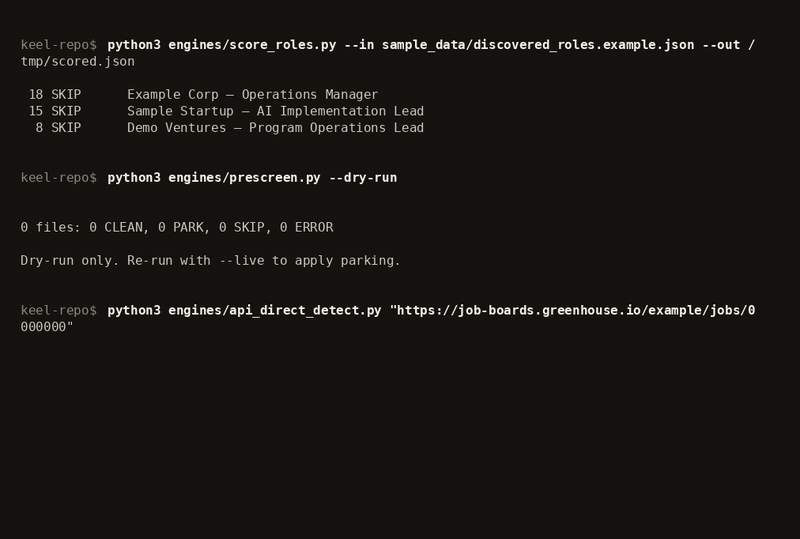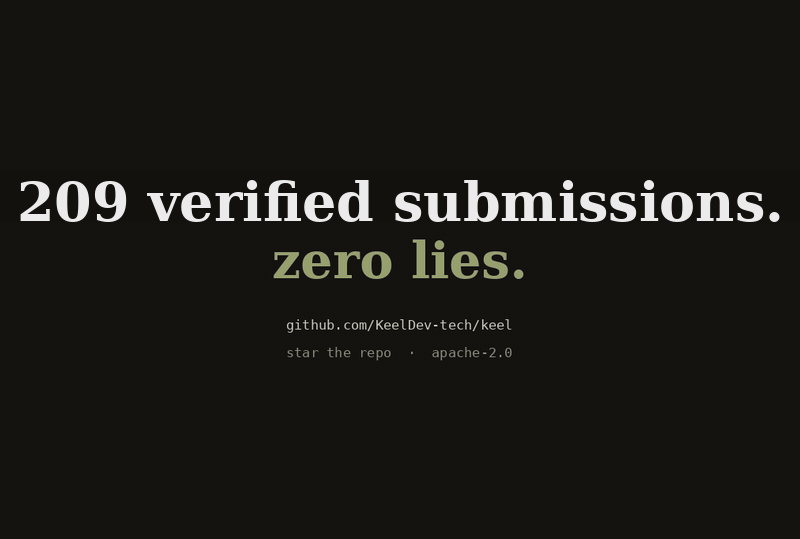
- Puntuación de fit para roles específicos con modelo de 100 puntos
- Generación honesta de materiales aplicativos (CVs, cartas de presentación)
- Detección de capacidades ATS y generación de paquetes de aplicación
- Verificación continua de leads mediante probes HTTP y APIs
- Automatización que nunca inventa datos ni cualificaciones no verificables
- Arquitectura flat con módulos single-purpose en Python stdlib
- Licencia Apache-2.0 sin dependencias externas para despliegue simple
- Dashboard HTML autocontenido con ledger y colas JSON
- Fail-closed por diseño ante datos no verificables o preguntas no mapeables
- No incluye Docker ni scripts de orquestación (despliegue manual requerido)
- Capa de ejecución de aplicaciones permanece privada por diseño
- Requiere configuración manual de data/applicant_profile.json y answer_bank.json
- Sin soporte para bases de datos o servicios externos integrados
- Versión 0.2.0 con funcionalidades limitadas según CHANGELOG
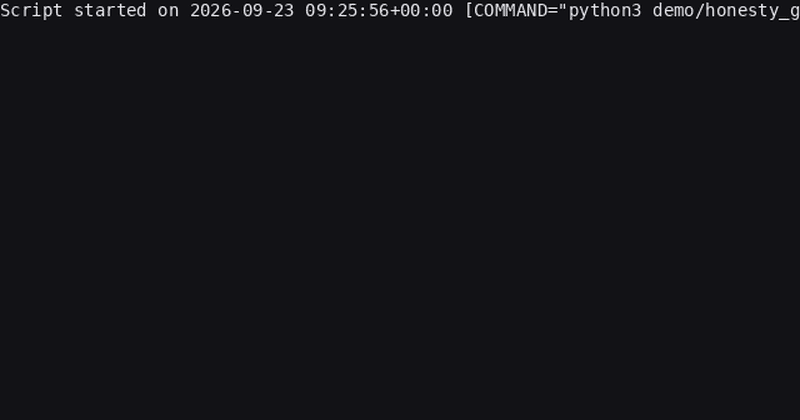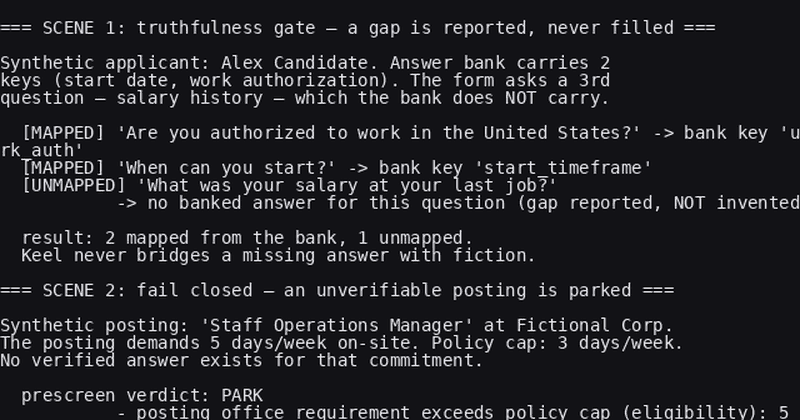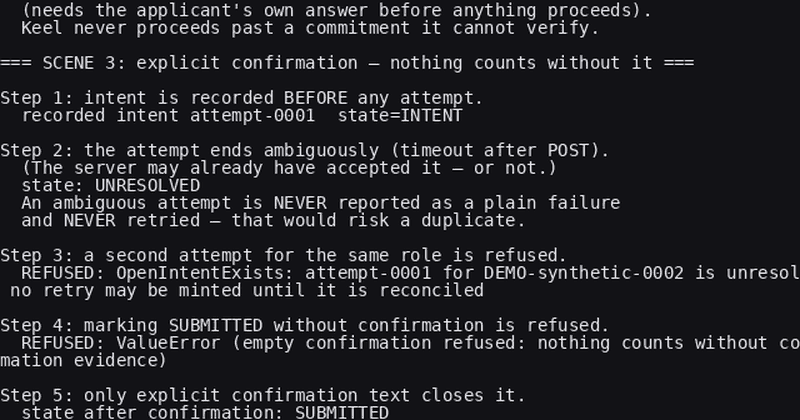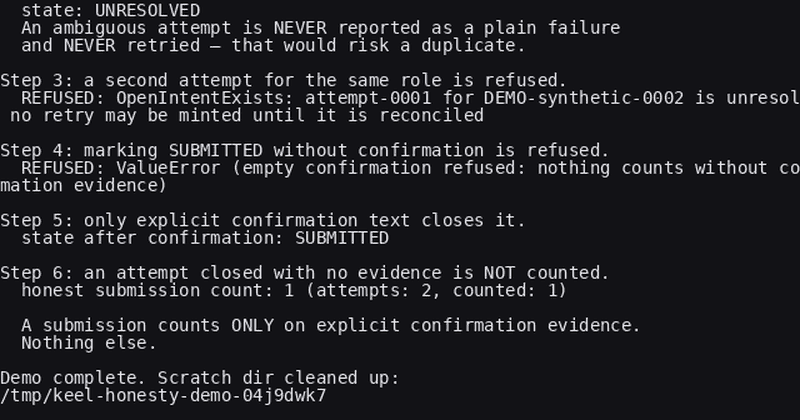
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Clona repositorio, ejecuta setup.sh desde raíz del proyecto con Python 3.10+. Edita data/applicant_profile.json y data/answer_bank.json con tus datos reales. Ejecuta start.sh para estado o scripts específicos como engines/score_roles.py. Dashboard en dashboard/dashboard.html. Requiere 1 core CPU, 1GB RAM, 10GB disco. Sin Docker ni dependencias pip. Verifica tests con python3 -m unittest discover -s tests antes de producción.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.