
job-match-radar
Pipeline autoalojado para búsqueda de empleo que combina scraping de LinkedIn y ATS con Supabase, scoring de listings mediante LLM externo y envío de digestos semanales por email.
Ficha actualizada 25 sept 2026, 19:03 · upstream 25 sept 2026, 18:46 · release sin release detectada
Qué es job-match-radar
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
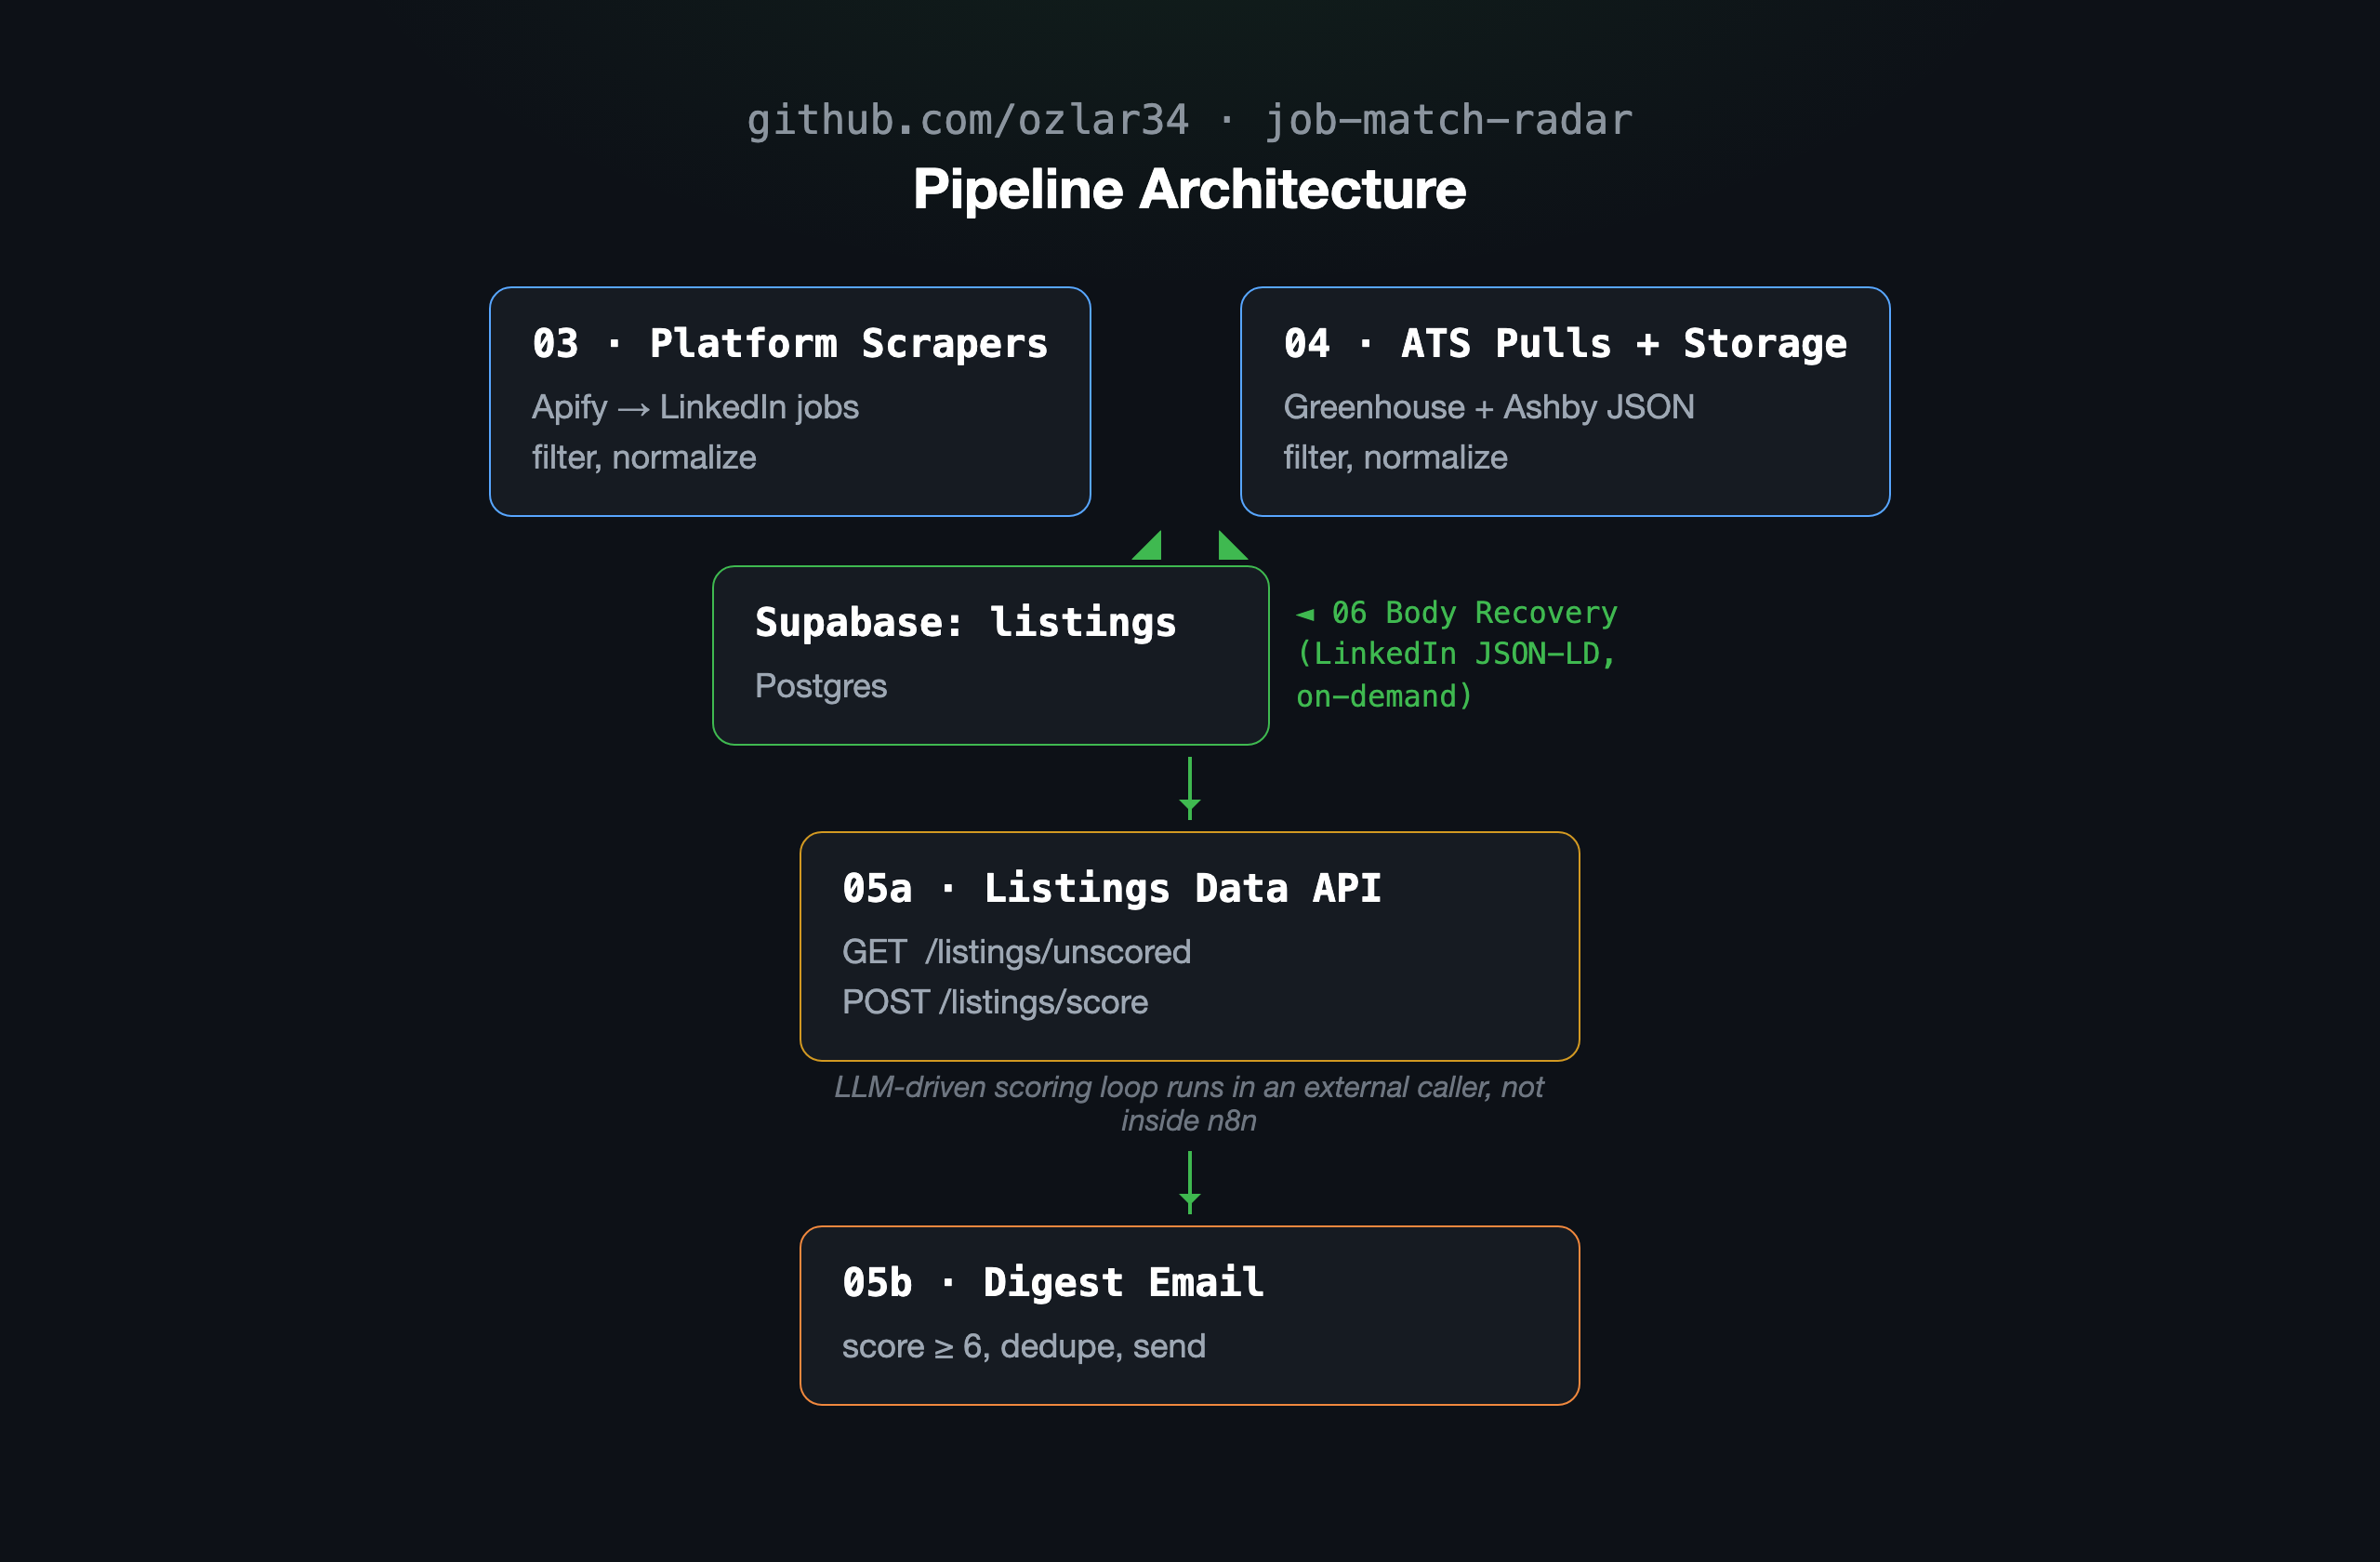
Job Match Radar es un sistema de automatización diseñado para la búsqueda personal de empleo. Utiliza una arquitectura modular basada en n8n y Supabase (PostgreSQL) para orquestar el scraping de LinkedIn a través del actor Apify y la extracción de datos desde endpoints públicos de ATS como Greenhouse y Ashby. El sistema normaliza los datos, recupera descripciones faltantes mediante JSON-LD y almacena todo en una tabla centralizada.
- Automatización de búsqueda de empleo personal con criterios personalizados.
- Monitorización continua de portales ATS específicos para empresas objetivo.
- Evaluación cualitativa de ofertas mediante scoring externo con LLM.
- Gestión de deduplicación y actualización de datos en base a fuentes frescas.
- Generación de informes semanales consolidados por email.
- Arquitectura desacoplada: el scoring del LLM reside fuera de n8n para facilitar depuración y control de costes.
- Mecanismo de deduplicación robusto en PostgreSQL con índices únicos sobre fuente e ID externo.
- Herramienta de evaluaciones (evals) independiente que verifica regresiones en el rubric del LLM.
- Recuperación manual de descripciones vacías mediante JSON-LD para evitar datos incompletos.
- API de datos ligera (05a) que separa la lógica de negocio del envío de emails (05b).
- Soporte nativo para triggers webhooks y manuales, permitiendo orquestación externa flexible.
- Los triggers son manuales o por webhook; no incluye disparadores automáticos programados (cron) en el repositorio.
- La recuperación de descripciones vacías requiere intervención manual y ejecución por lotes pequeños.
- El scoring se realiza fuera del repositorio, requiriendo un entorno externo para ejecutar la LLM.
- Los endpoints de ATS están limitados a listas específicas (Greenhouse/Ashby) y requieren configuración manual.
- La autenticación de Gmail requiere configuración OAuth manual en el nodo de envío.
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Requiere instancia n8n autoalojada, base de datos PostgreSQL (Supabase compatible), cuenta Apify y proveedor SMTP. Se ejecuta con docker compose. Es necesario importar workflows desde archivos JSON y crear credenciales manualmente. El scoring debe gestionarse externamente al repositorio.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.