
infercat
Infercat permite compartir modelos locales de IA con amigos mediante un único código de invitación y una conexión cifrada, sin necesidad de cuentas ni VPN. Funciona como un proxy seguro que conecta clientes web a servidores de inferencia locales (llama.cpp, vLLM, Ollama) a través de túneles WireGuar
Ficha actualizada 28 sept 2026, 5:46 · upstream 28 sept 2026, 5:42 · release v0.1.4
Qué es infercat
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Infercat es una herramienta de software open source diseñada para compartir modelos de inteligencia artificial ejecutándose localmente en tu máquina con terceros. La arquitectura se basa en un nodo anfitrión (host) que detecta automáticamente servidores de inferencia compatibles como llama.cpp, vLLM, Ollama o LM Studio. Este host establece un túnel cifrado utilizando la tecnología Tailcat (plano de datos de Tailscale sin control plane) hacia un servidor relay público o auto-alojado.
Los amigos acceden a través de una aplicación web estática que se ejecuta en el navegador, cargando la parte del cliente del túnel como WebAssembly. Esto permite que el tráfico fluya directamente entre el navegador del amigo y el anfitrión local, pasando por el relay con cifrado extremo a extremo (E2EE). No existen cuentas de usuario ni almacenamiento centralizado de conversaciones; los registros se gestionan localmente o se eliminan según la configuración.
La herramienta incluye capacidades avanzadas como soporte para agentes autónomos, generación de imágenes y voz, así como búsqueda web en chats opt-in. Permite configurar límites por invitación (cuota de uso) y ofrece una API de administración remota para gestionar claves y configuraciones sin tocar el servidor directamente. El despliegue es sencillo mediante scripts de instalación o contenedores Docker.
- Compartir un modelo local de IA con amigos o colegas para chat en tiempo real sin exponer la infraestructura base.
- Ejecutar agentes autónomos que procesan tareas complejas utilizando el hardware local del anfitrión.
- Generación de imágenes y audio mediante APIs compatibles alojadas detrás del túnel seguro.
- Búsqueda web integrada dentro de las sesiones de chat con consentimiento explícito del usuario.
- Arquitectura Zero-Knowledge: No hay cuentas ni bases de datos centralizadas; los datos residen en el anfitrión y el cliente.
- Cifrado extremo a extremo (E2EE) para todo el tráfico entre el navegador del amigo y el servidor local.
- Auto-descubrimiento de motores de inferencia: Detecta automáticamente llama.cpp, Ollama, vLLM o LM Studio en ejecución.
- Tecnología Tailcat integrada para crear túneles seguros sin depender del control plane de Tailscale.
- Los binarios no están firmados por Apple, lo que puede bloquear la ejecución en macOS hasta desactivar el quarantine o abrir desde Finder.
- El rendimiento y la compatibilidad con hardware NVIDIA o configuraciones de memoria específicas (ej. 16GB reales) no están completamente verificados oficialmente.
- Dependencia de un servidor relay DERP (público o auto-alojado) para enrutar las conexiones entre anfitrión y cliente.
- La gestión de claves requiere interacción manual; el código de invitación se muestra una vez por sesión.
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
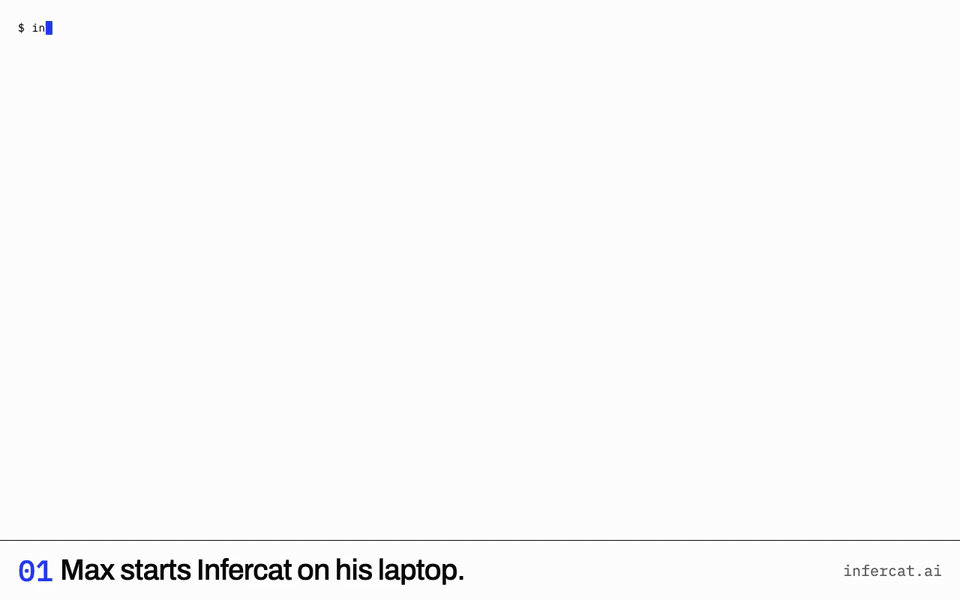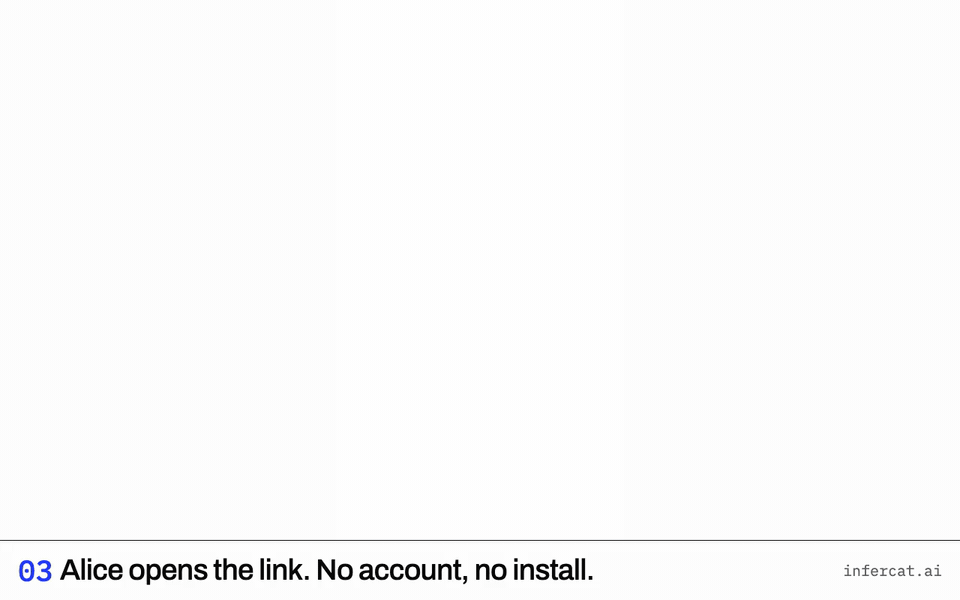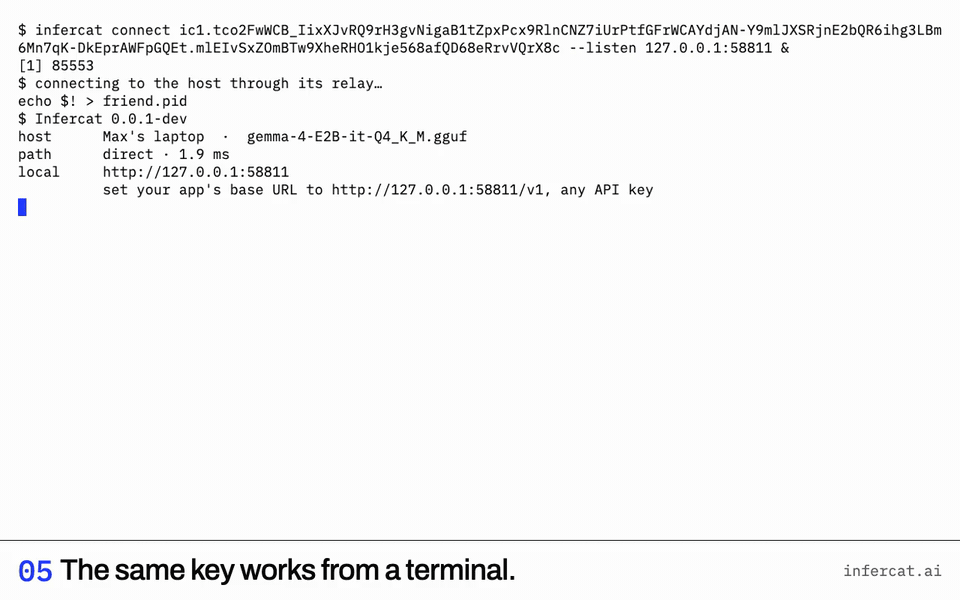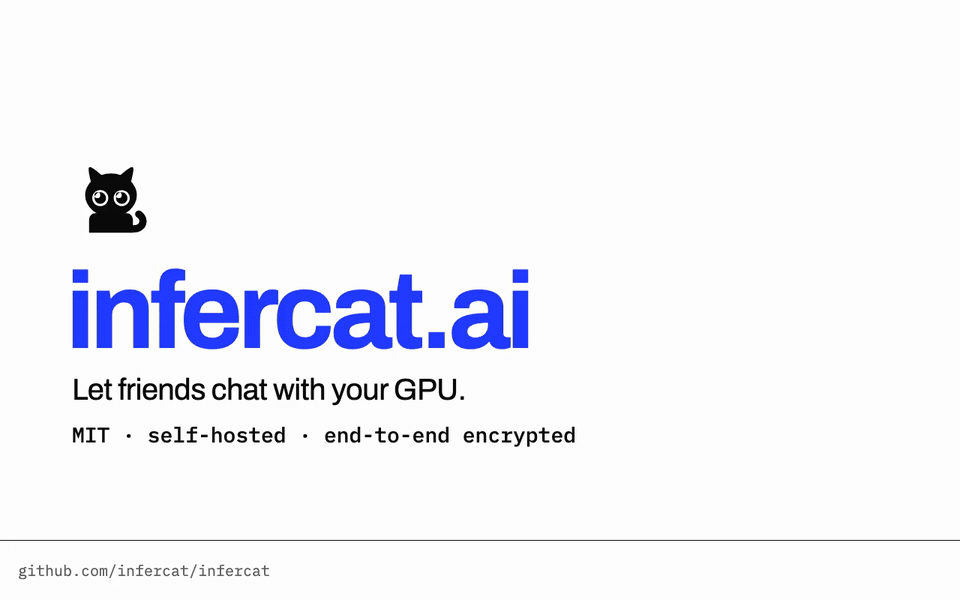
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Requiere un sistema operativo con soporte para binarios nativos o Docker. El anfitrión necesita al menos 4 núcleos CPU y 8 GB de RAM según la configuración mínima analizada. Se recomienda usar `infercat serve` para iniciar el servicio, asegurando que el motor de inferencia (ej. Ollama) esté corriendo en segundo plano. Para administración remota, habilitar la consola local (`--console`) es obligatorio antes de rotar claves o configurar límites. Verificar integridad de binarios con checksums SHA256 si se descarga manualmente.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.