
helix
Helix es una flota privada de agentes de IA con codificación basada en especificaciones. Cada agente opera en un entorno virtual aislado con GPU, permitiendo escalar tareas de desarrollo sin compartir recursos. Incluye gestión de proyectos tipo Kanban, integración con múltiples LLMs y soporte para d
Ficha actualizada 27 sept 2026, 22:05 · upstream 27 sept 2026, 20:31 · release 2.12.22
Qué es helix
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Helix permite ejecutar una flota de agentes de codificación en infraestructura propia, donde cada agente dispone de un escritorio virtual completo acelerado por GPU (navegador, terminal, sistema de archivos). Esto evita la contención de recursos típica de entornos compartidos y permite supervisar el trabajo en tiempo real. El sistema organiza el flujo de trabajo mediante un tablero Kanban que guía las tareas desde el Backlog hasta la fusión de Pull Requests, facilitando la revisión humana del plan antes de la implementación.
- Automatización de tareas de desarrollo con revisión humana en Kanban para garantizar calidad.
- Escalado paralelo de agentes para refactorización masiva o migración de código legacy.
- Prototipado rápido alternando entre modelos LLM económicos y costosos según complejidad.
- Auditoría de costes de tokens y uso de API en despliegues empresariales con métricas detalladas.
- Investigación y análisis de datos utilizando agentes aislados que no contaminan el entorno local.
- Aislamiento completo por agente con escritorio virtual acelerado por GPU para mayor rendimiento.
- Compatibilidad multi-harness: soporta Claude Code, Codex, Gemini CLI, Qwen Code y cualquier ACP-compatible.
- Arquitectura separada de Control Plane y Runners GPU para escalabilidad horizontal eficiente.
- Observabilidad completa con trazas de LLM, uso de tokens y análisis detallado de costes por equipo.
- Soporte nativo para RAG y gestión de conocimientos mediante ingestión de documentos y web scraping.
- Despliegue air-gapped posible mediante endpoints OpenAI compatibles externos (vLLM, etc.).
- Licencia restrictiva para uso comercial grande; requiere Launchpad o licencia específica fuera del ámbito educativo/pequeño.
- Dependencia crítica de infraestructura GPU dedicada para los runners en el lado de la aplicación.
- Configuración inicial compleja vía variables de entorno, sin opción one-click para despliegues avanzados de producción.
- Requiere gestión manual de la asignación de tareas a agentes específicos y supervisión del estado en el Kanban.
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
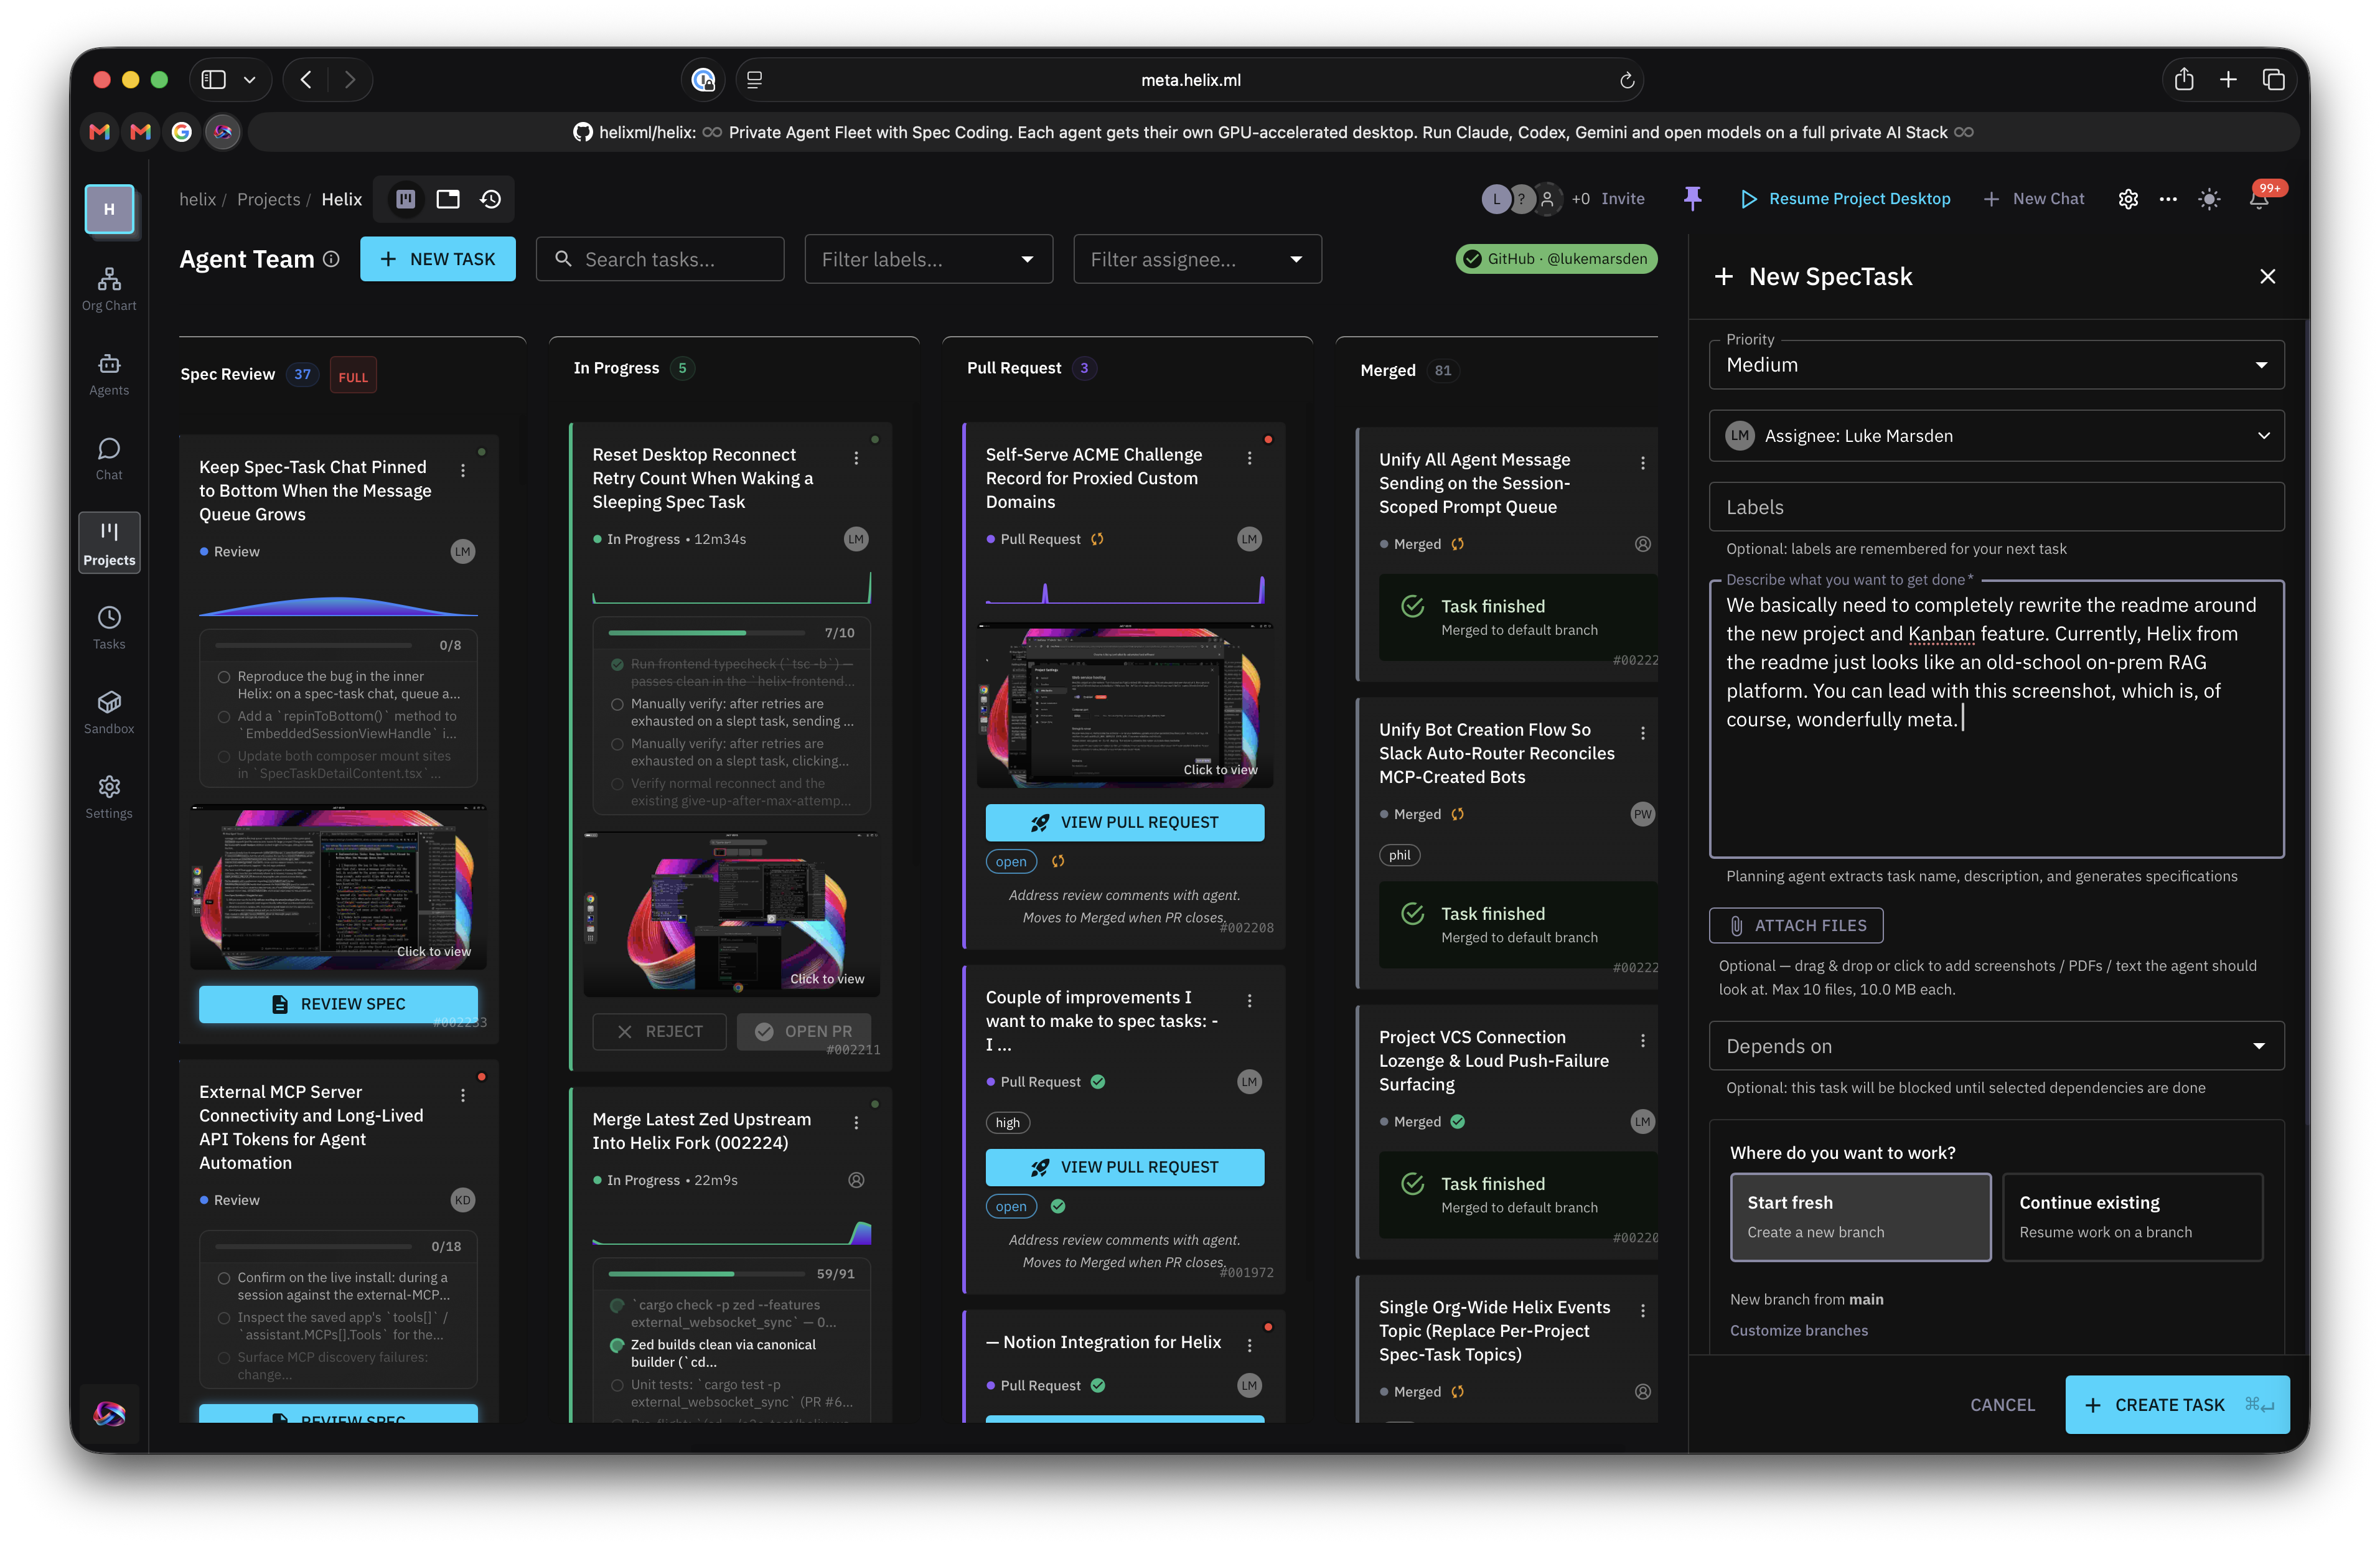
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Instalar mediante script oficial (install.sh) o Helm charts separando Control Plane y Runners GPU. Configurar variables de entorno para credenciales de LLM, bases de datos PostgreSQL/MySQL y URL pública. Asegurar terminación TLS y DNS correcto. En desarrollo local usar Docker Compose para servicios de soporte y Go 1.24+ con Node.js 18+. Verificar compatibilidad de versiones antes de producción.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.