
ework
Plataforma de auto-hospedaje para flotas de desarrollo impulsadas por IA. Los agentes trabajan en issues aislados, gestionan PRs y reportan progreso. Soporta GitHub, QQ y múltiples modelos de IA.
Ficha actualizada 26 sept 2026, 4:13 · upstream 25 sept 2026, 8:24 · release sin release detectada
Qué es ework
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
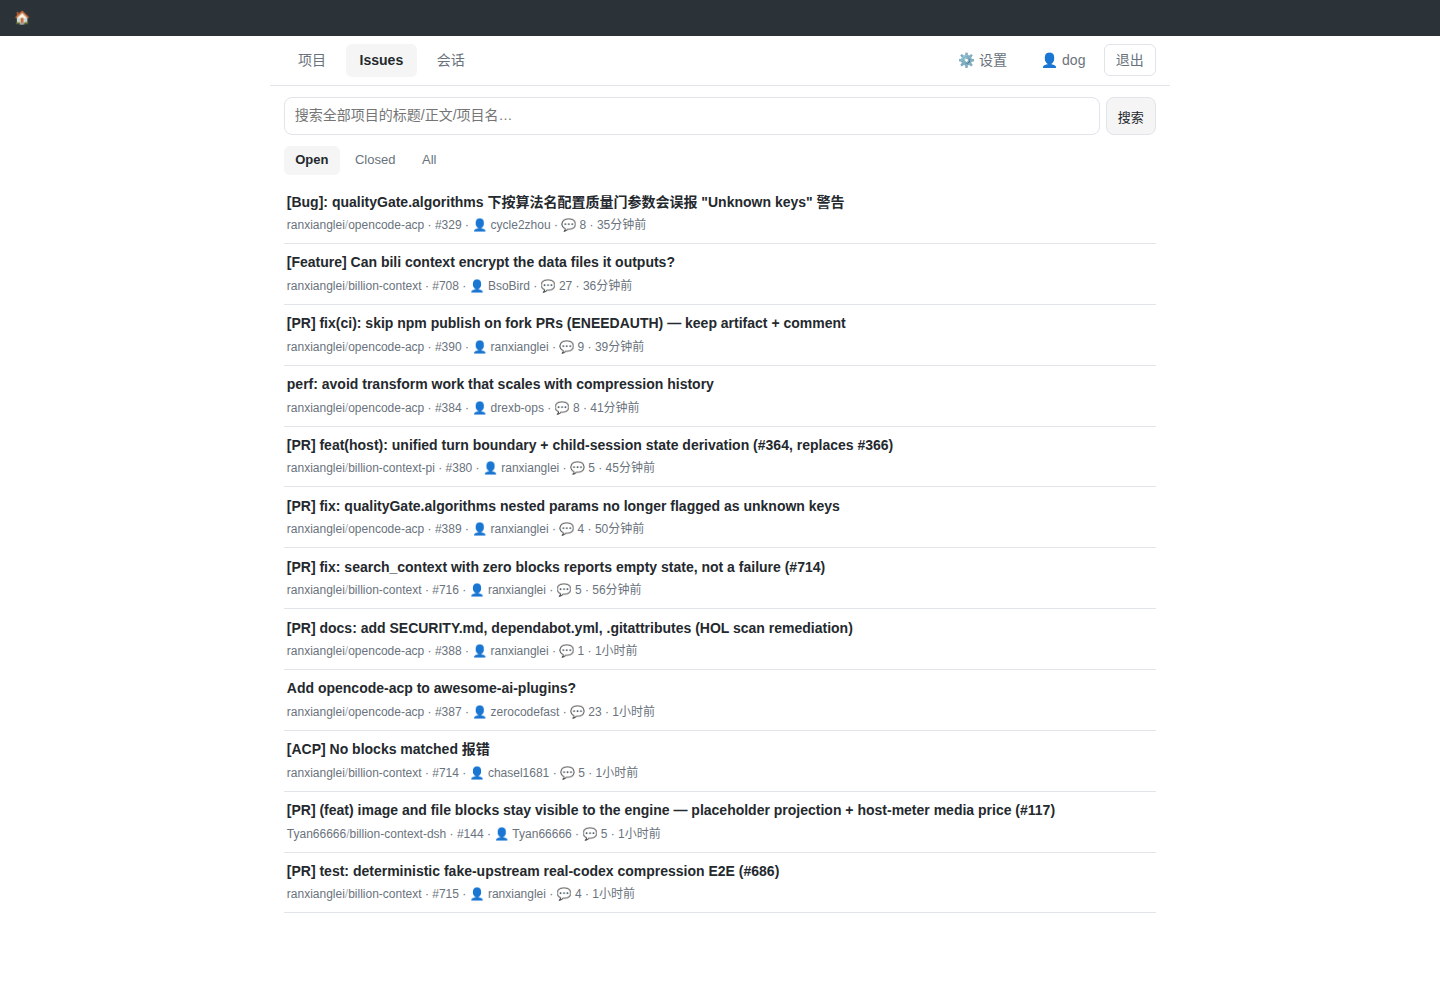
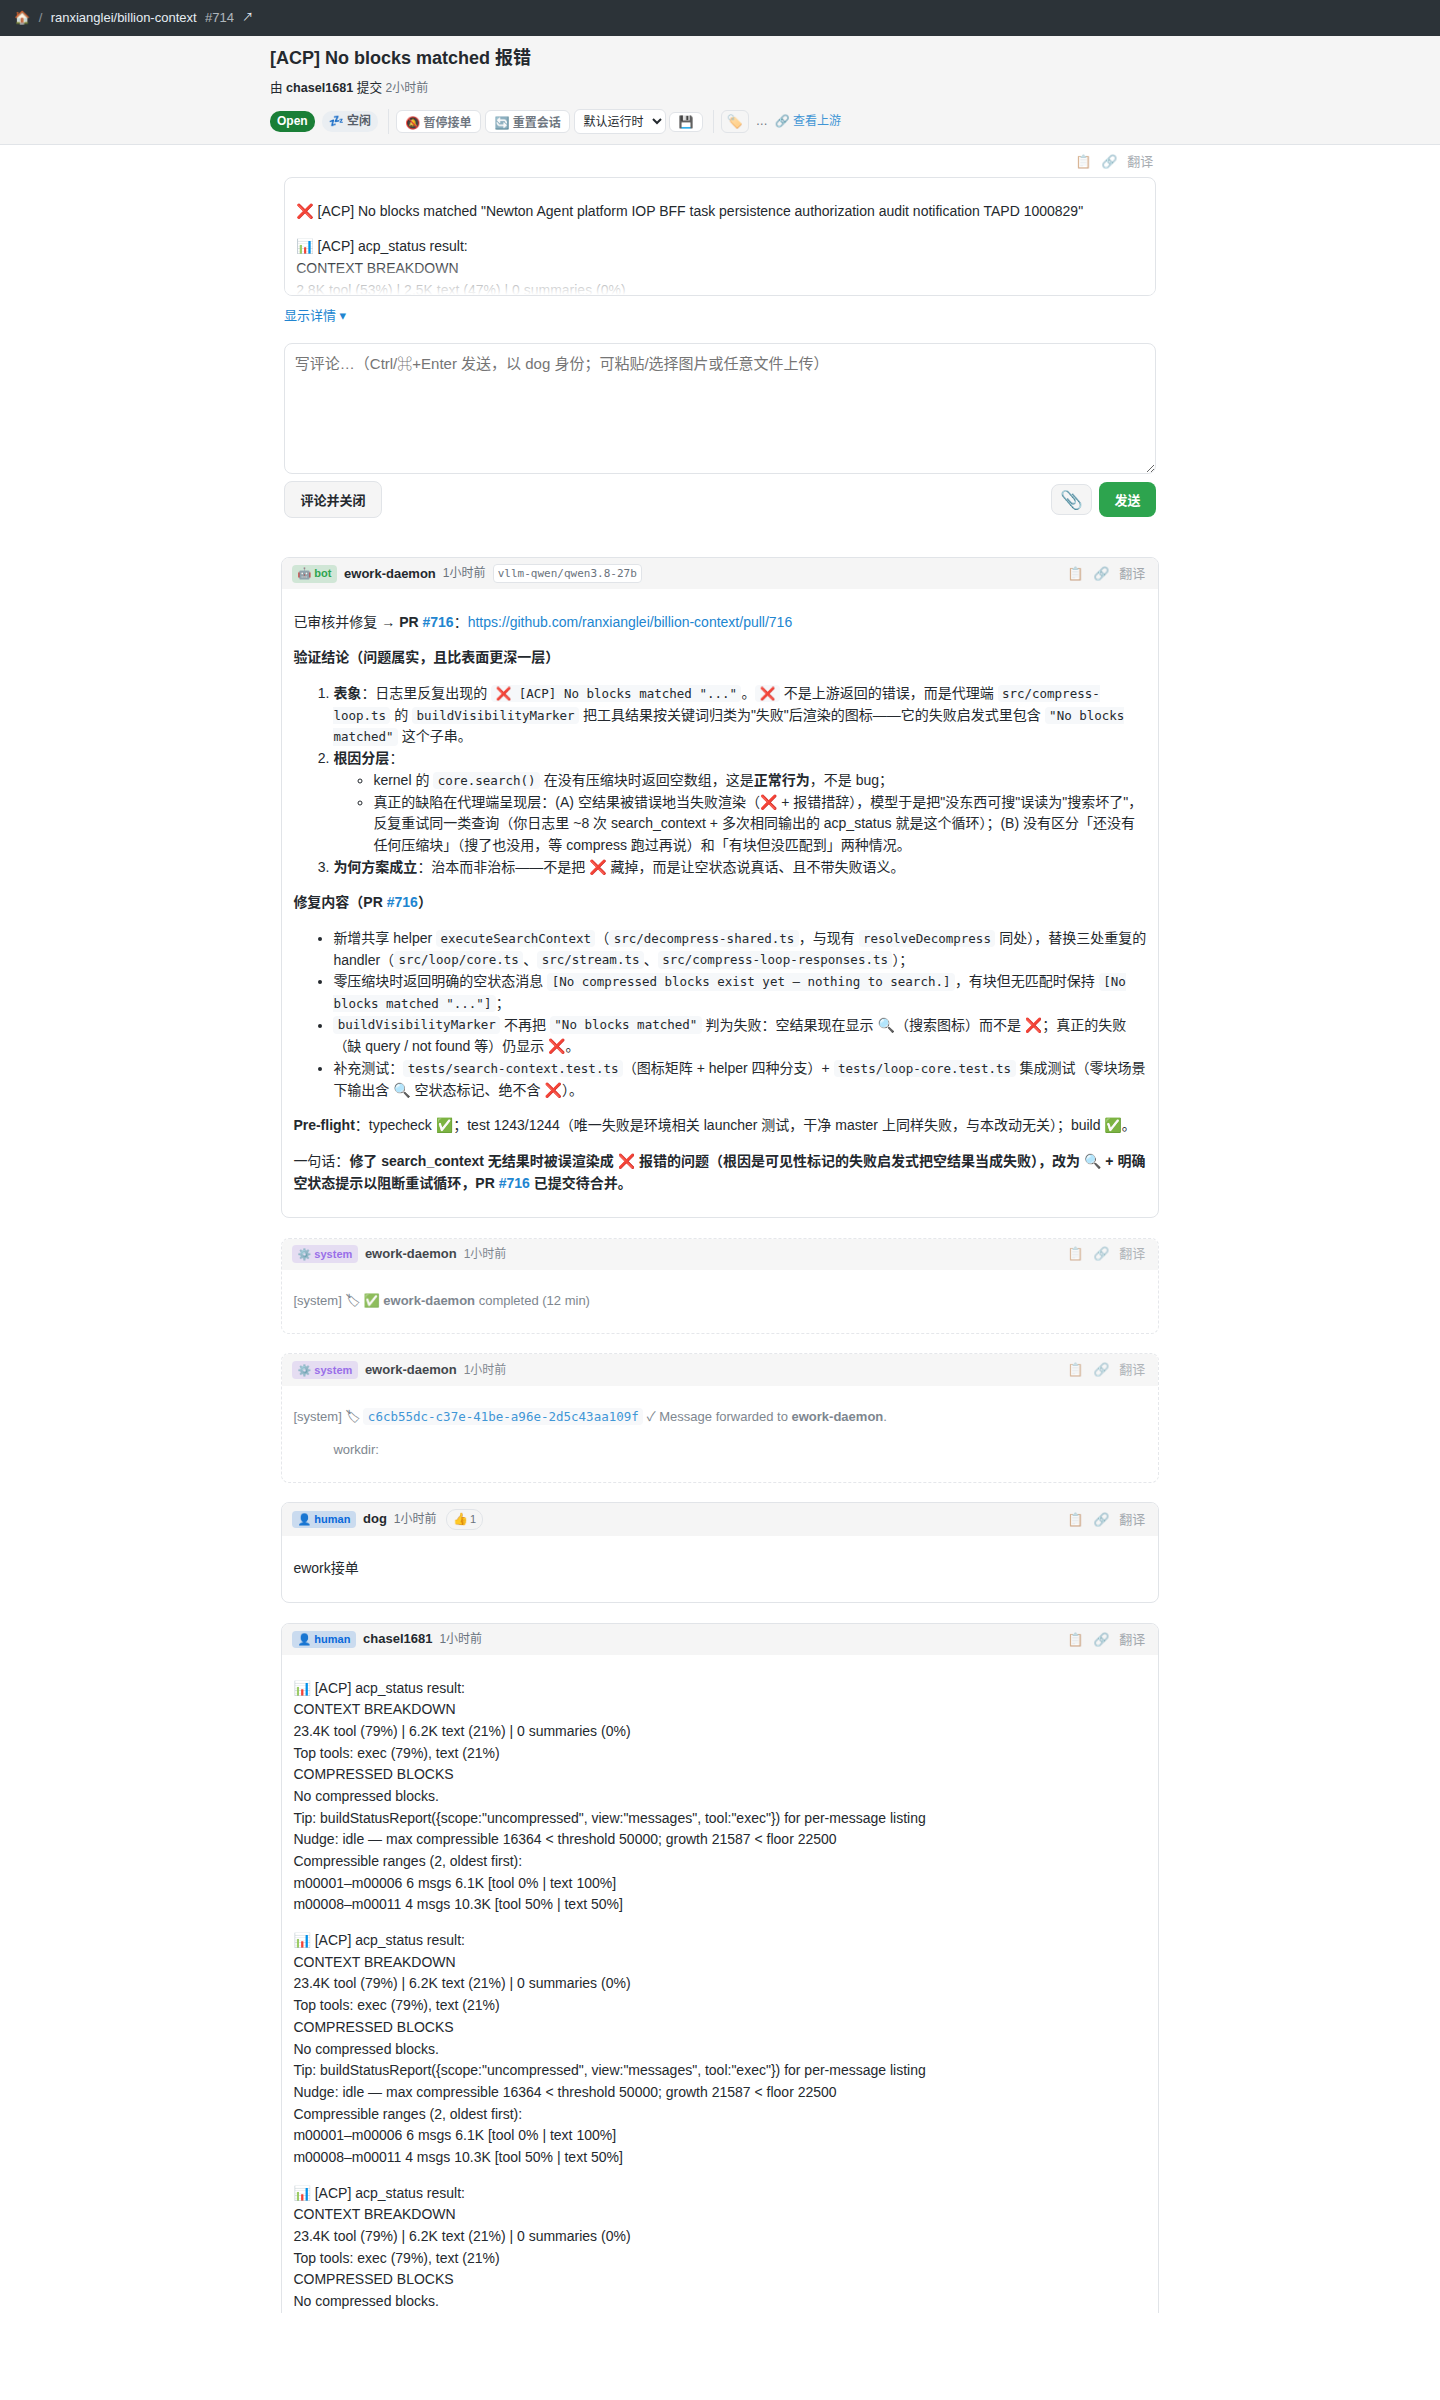
ework es una plataforma de auto-hospedaje diseñada para gestionar flotas de desarrollo impulsadas por inteligencia artificial. Los usuarios crean issues en GitHub o QQ, y los agentes de IA toman el trabajo en worktrees aislados, generando PRs y actualizando el estado del issue con comentarios detallados. La arquitectura permite control total sobre quién activa la flota, qué modelos se utilizan y las políticas de concurrencia.
La plataforma consta de varios componentes: ework-web para el tablero de issues, ework-daemon como motor principal que gestiona agentes por issue, ework-router para distribución entre múltiples daemons, ework-mirror para sincronización bidireccional con GitHub, y work-qq-bridge para integración con grupos QQ. Cada paquete se publica independientemente en npm y mantiene su propia versión.
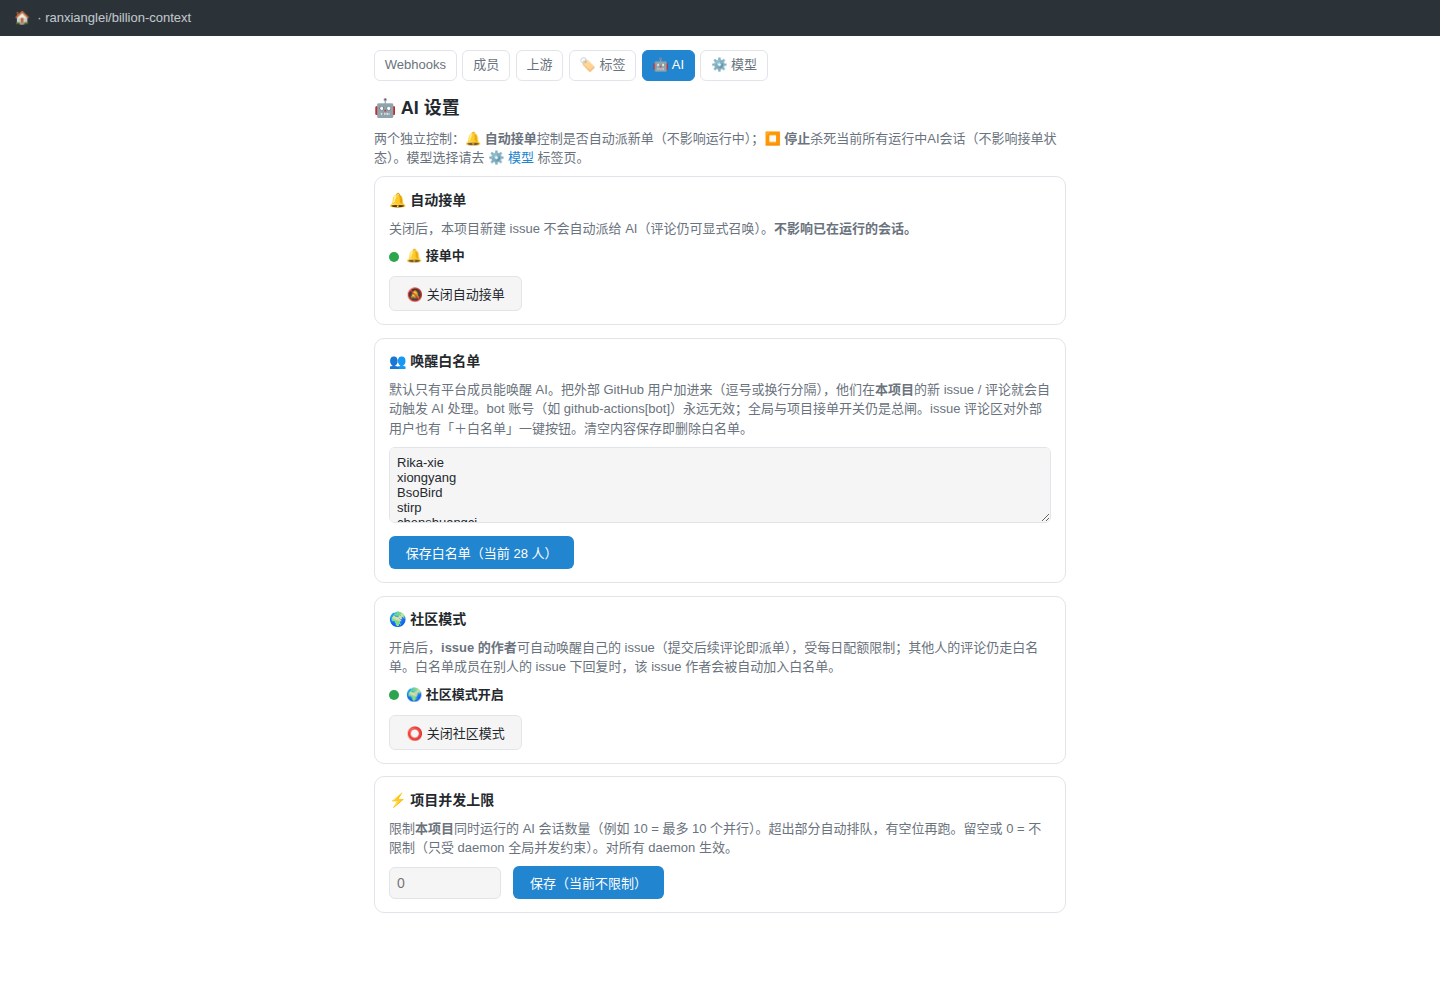
La configuración se maneja en tres capas: dinámica por proyecto (vía UI web), de entorno por servicio (archivos .env) y runtime del agente (opencode.json). El sistema incluye recuperación automática de trabajos interrumpidos, eliminación de directorios antiguos tras 7 días y soporte para múltiples modelos de IA con cuotas personalizables.
- Automatización de tareas de desarrollo mediante issues
- Gestión de flotas de agentes con políticas de activación granular
- Integración bidireccional con repositorios GitHub
- Comunicación entre grupos QQ y plataformas de desarrollo
- Despliegue en múltiples entornos (Docker, Linux nativo)
- Arquitectura monorepo con Bun para gestión de dependencias
- Recuperación automática de trabajos interrumpidos tras reinicios
- Configuración dinámica por proyecto sin reiniciar servicios
- Soporte para múltiples modelos de IA y plugins personalizados
- Aislamiento de worktrees por issue para evitar conflictos
- No soporta Windows nativo (requiere Docker Desktop o WSL2)
- Dependencia de Bun como runtime principal
- Configuración manual de tokens y endpoints del modelo
- Requiere gestión manual de versiones mediante lockfile en aio
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Para producción, usar Docker con docker compose up -d. Configurar .env.docker con secrets y endpoint del modelo. Para Linux nativo, instalar work-aio y usar systemd. Verificar que Bun esté instalado antes de ejecutar comandos npm.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.