
divetracx
Divetracx es un libro de buceo auto-alojado que centraliza registros desde Garmin, DiveMate y Subsurface en una base de datos PostgreSQL propia. Permite registro manual, exportación a múltiples formatos (UDDF, CSV, DDB) e integración con agentes de IA vía MCP.
Ficha actualizada 24 sept 2026, 8:04 · upstream 24 sept 2026, 7:58 · release sin release detectada
Qué es divetracx
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
Divetracx actúa como un repositorio único para gestionar registros de buceo propios, consolidando datos dispersos en diferentes esquemas y plataformas. El sistema importa historiales completos desde backups de DiveMate (.ddb), archivos FIT de Garmin Connect y exportaciones de Subsurface (.ssrf/.xml). Además, permite registrar inmersiones manualmente a través de la interfaz gráfica, capturando campos como grupos de presión y tiempos de seguridad sin necesidad de hardware externo.
La arquitectura se basa en Next.js, React y Node.js, ejecutándose sobre Bun 1.4 para optimización de rendimiento. Los datos residan en una instancia PostgreSQL local y los medios en almacenamiento S3 o MinIO. El sistema ofrece sincronización incremental segura que detecta cambios mediante hashes de contenido sin eliminar registros existentes, garantizando la integridad del historial a largo plazo.
Para interoperabilidad avanzada, expone un endpoint MCP (Model Context Protocol) protegido con OAuth, permitiendo a agentes de inteligencia artificial leer estadísticas, buscar inmersiones y consultar detalles bajo control estricto del propietario. La plataforma soporta despliegue mediante Docker Compose para servidores domésticos o Helm charts en clusters.
- Centralizar registros históricos desde múltiples computadoras de buceo (Garmin, DiveMate) en una base de datos única y canónica.
- Sincronización incremental segura que actualiza solo nuevos o modificados sin borrar datos previos importados.
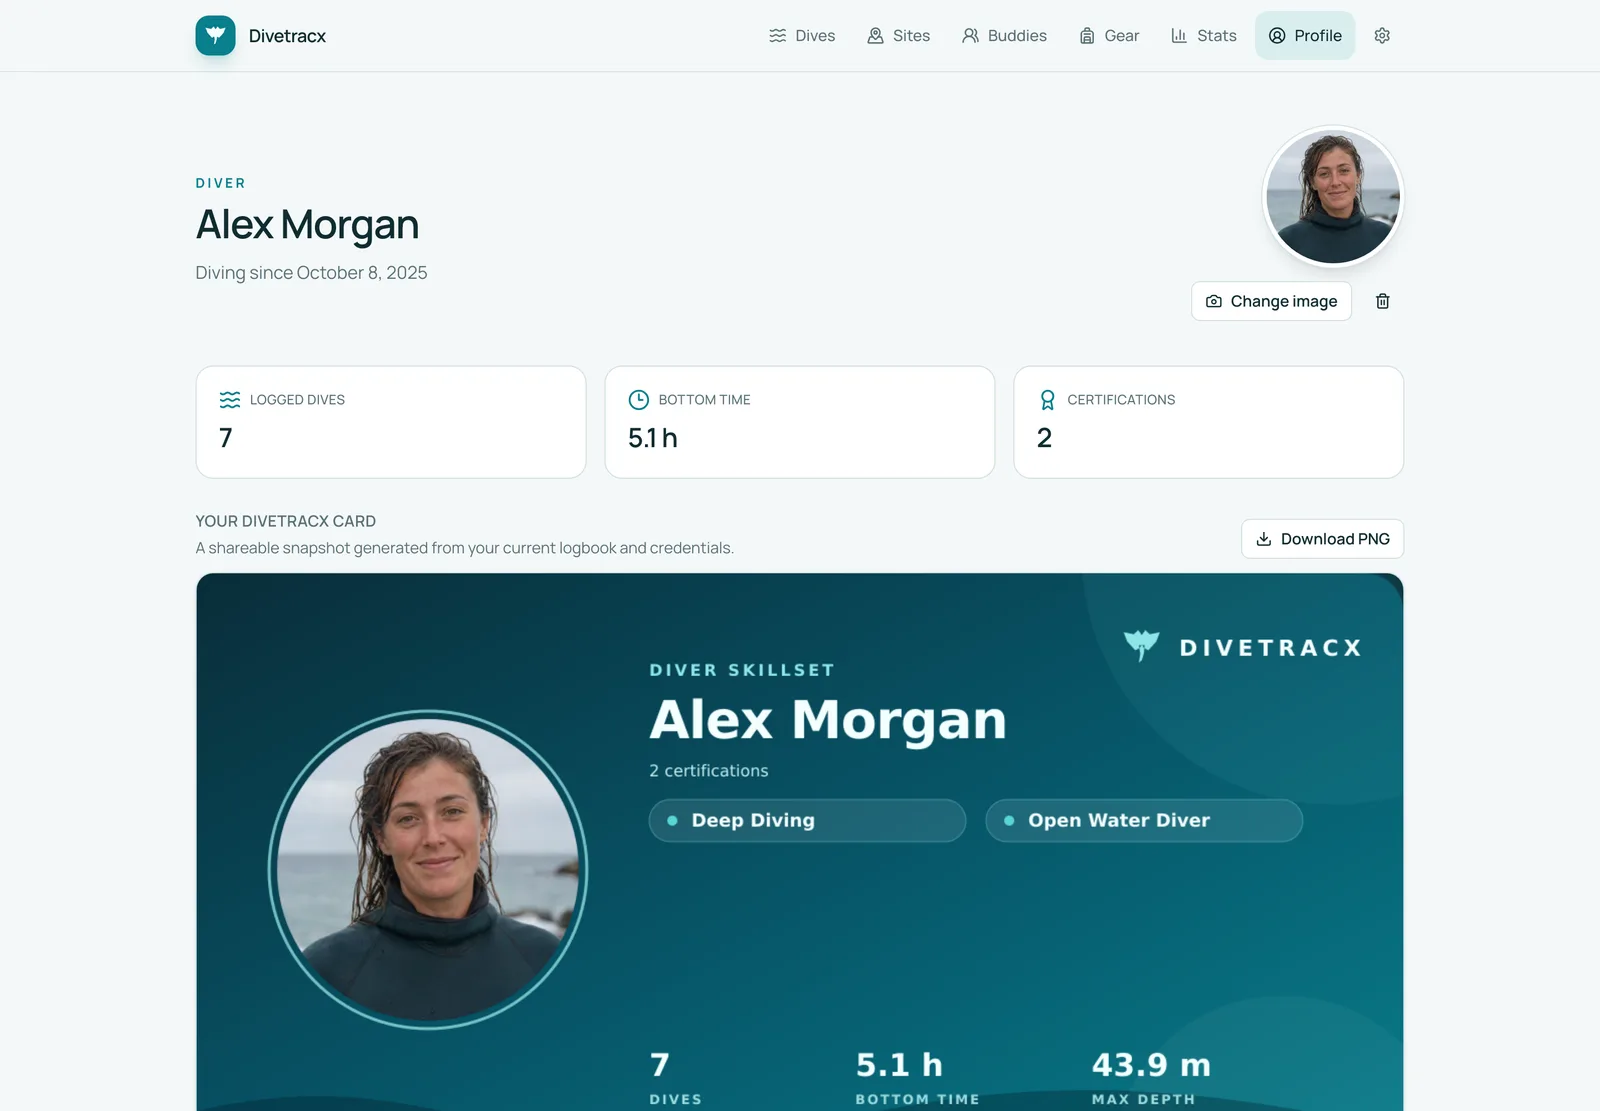
- Registro manual de inmersiones con edición completa de perfiles, equipos, gases y certificados mediante la interfaz web.
- Exportación portátil de datos a formatos estándar (UDDF 3.2.3, CSV, Subsurface) para migrar o respaldar el logbook.
- Integración con agentes de IA locales a través del endpoint MCP protegido para análisis de estadísticas y búsqueda de inmersiones.
- Base de datos PostgreSQL auto-alojada que garantiza la propiedad total de los datos sin telemetría externa.
- Soporte nativo para Bun 1.4, Next.js y React con despliegue simplificado vía Docker Compose o Helm.
- Sincronización incremental idempotente que preserva integridad mediante hashes de contenido y detección de cambios.
- Endpoint MCP opcional con servidor OAuth integrado para acceso seguro a herramientas de IA externas.
- Importación robusta desde Garmin (FIT SDK oficial) y DiveMate (.ddb) con soporte para fotos y tarjetas de certificación.
- La importación directa de formatos UDDF, CSV o JSON nativo de Divetracx no está soportada actualmente; se requiere exportar desde otra fuente como Subsurface.
- Dependencia de APIs no oficiales del servicio Garmin Dive para sincronización de equipo y certificados, lo que puede ser inestable ante cambios en la plataforma.
- Complejidad técnica HIGH con requisitos recomendados de 4 núcleos CPU y 4GB RAM para despliegues completos con PostgreSQL y almacenamiento S3.
- Configuración manual obligatoria de variables de entorno para autenticación Google Drive (DiveMate) y credenciales OAuth de Garmin.
- Los registros manuales no se importan automáticamente; deben crearse explícitamente o mediante sincronización de perfiles desde otras fuentes.
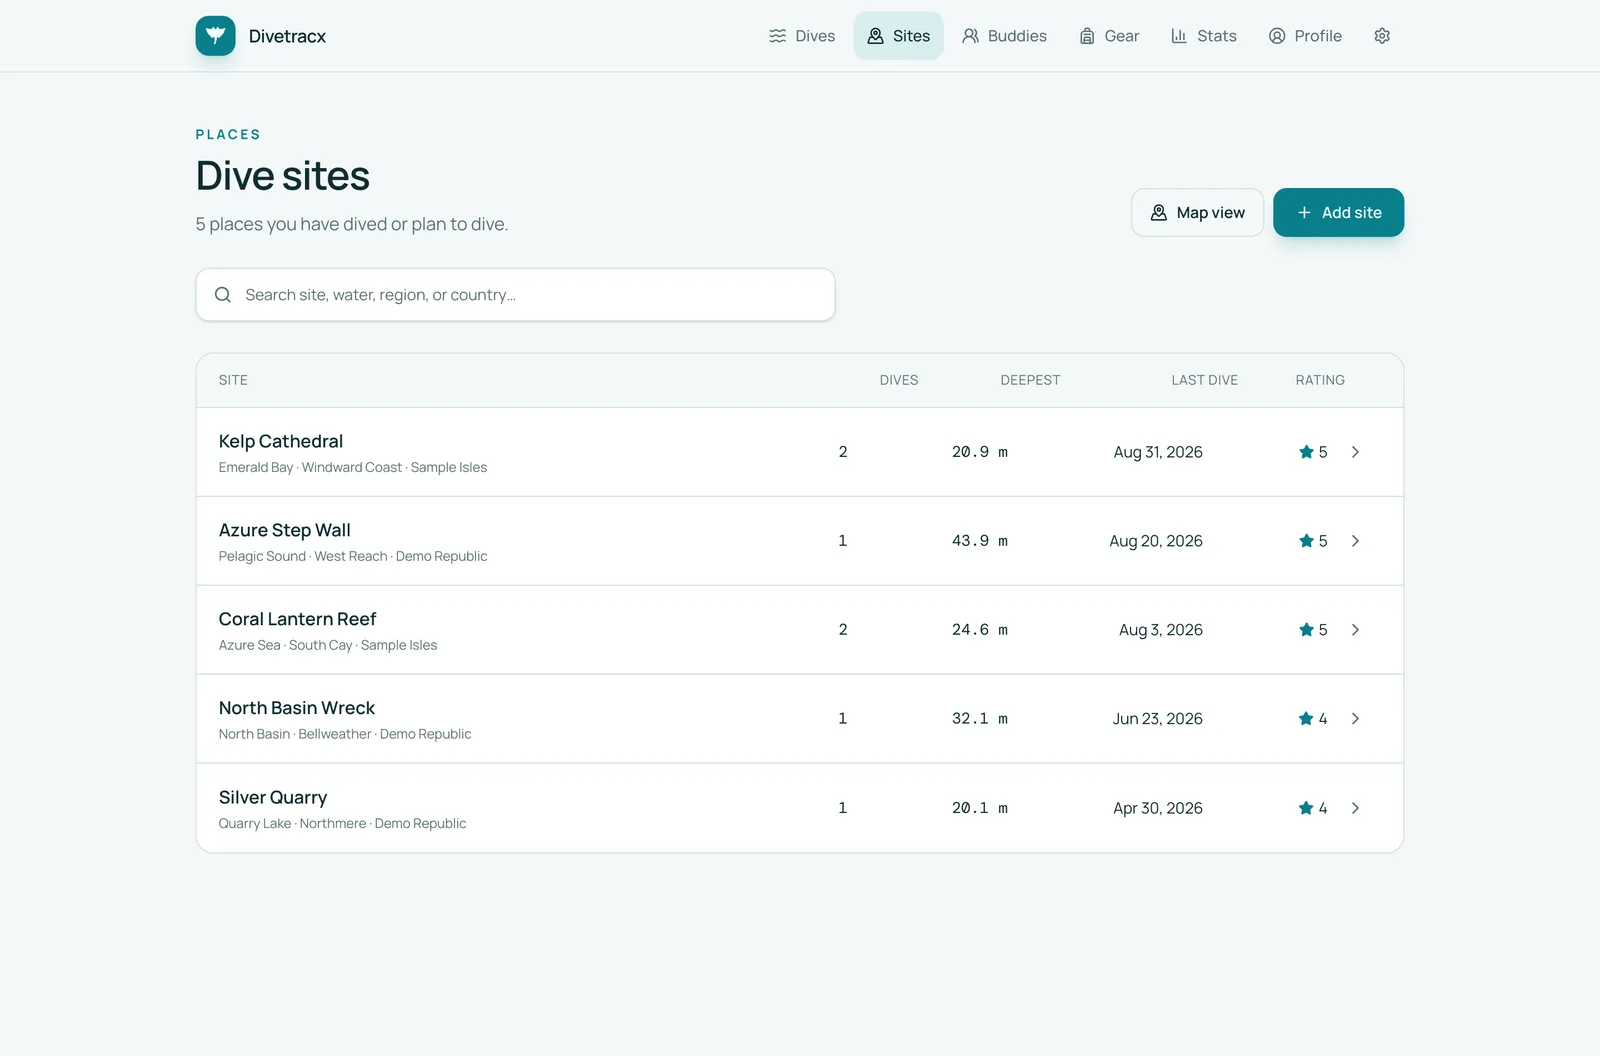
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
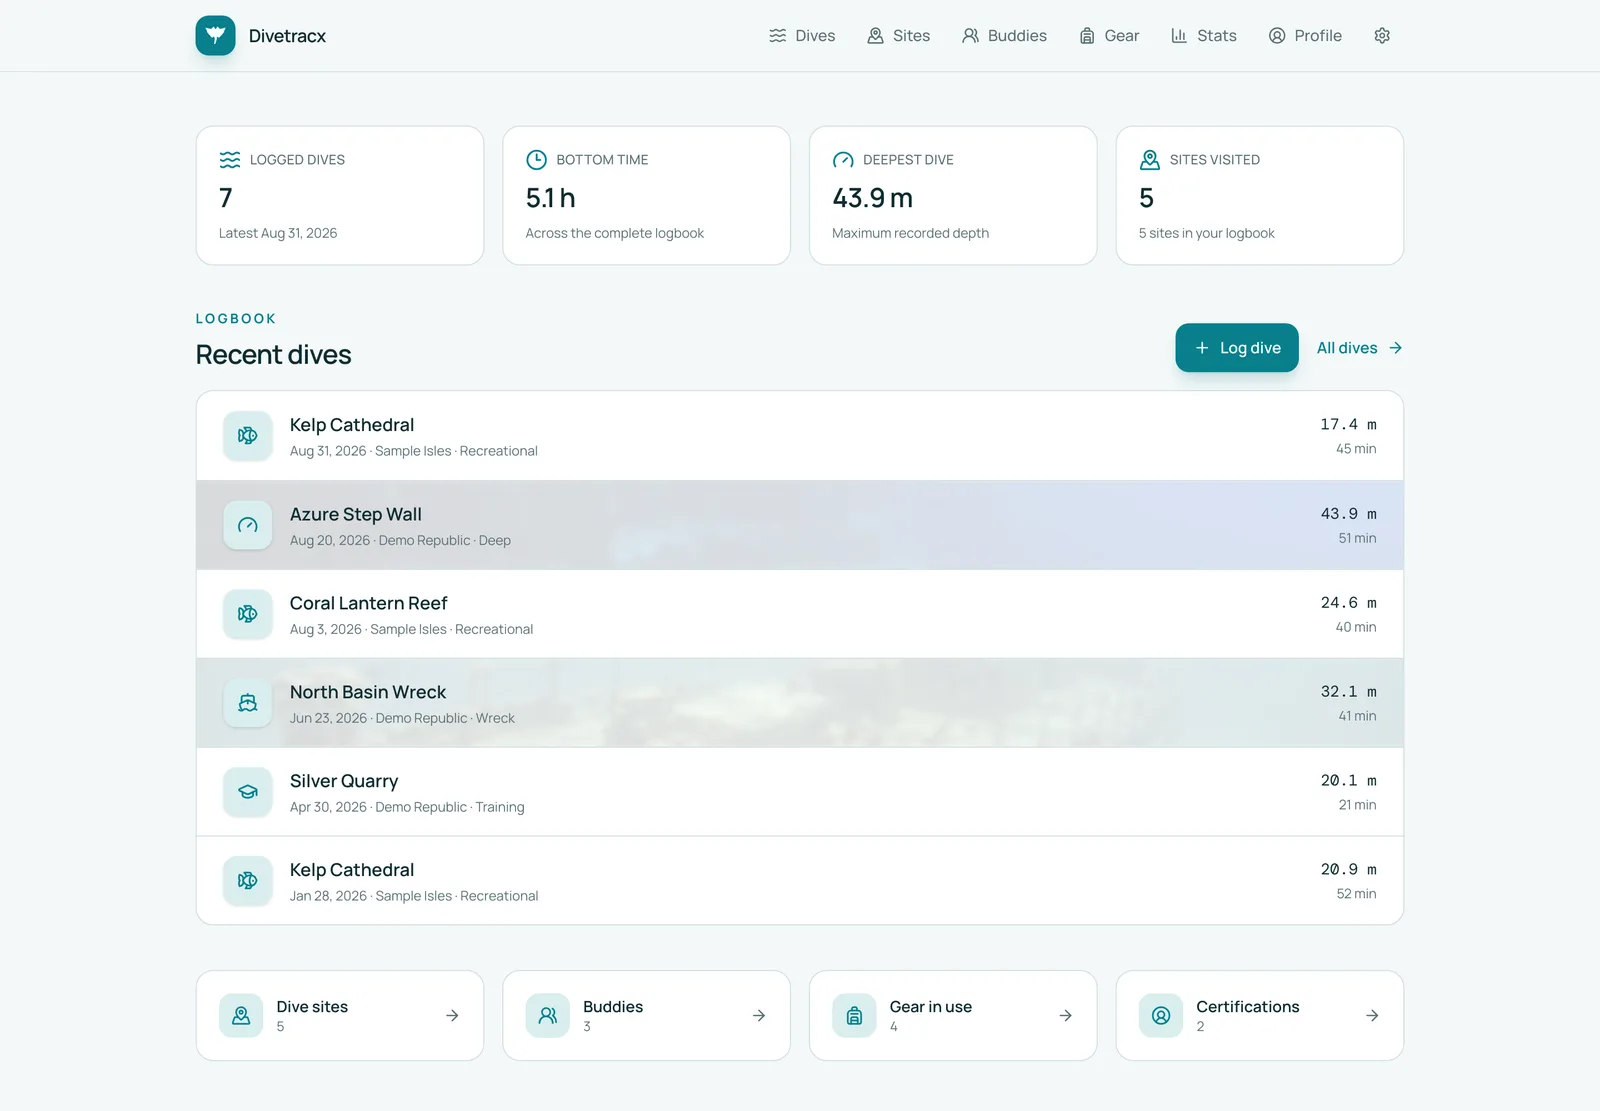

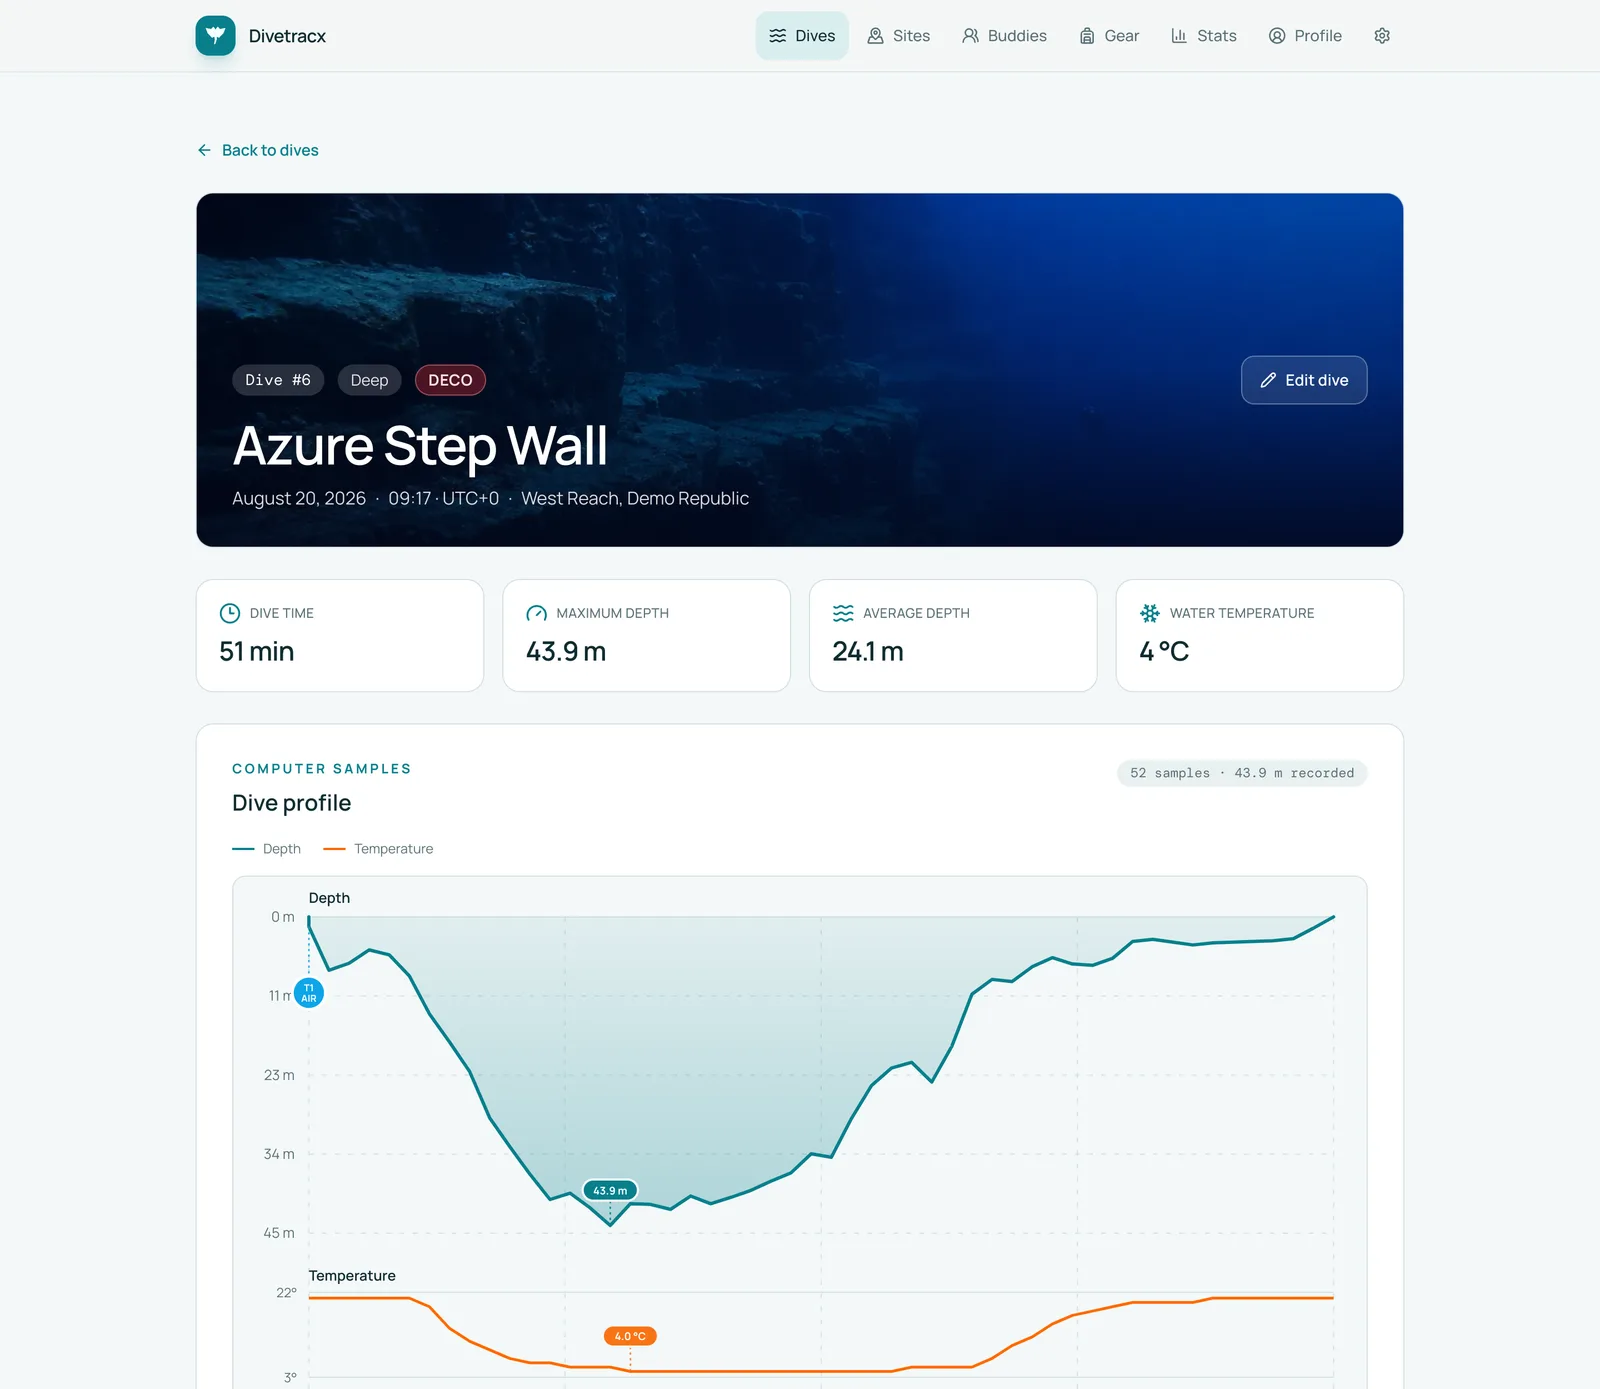
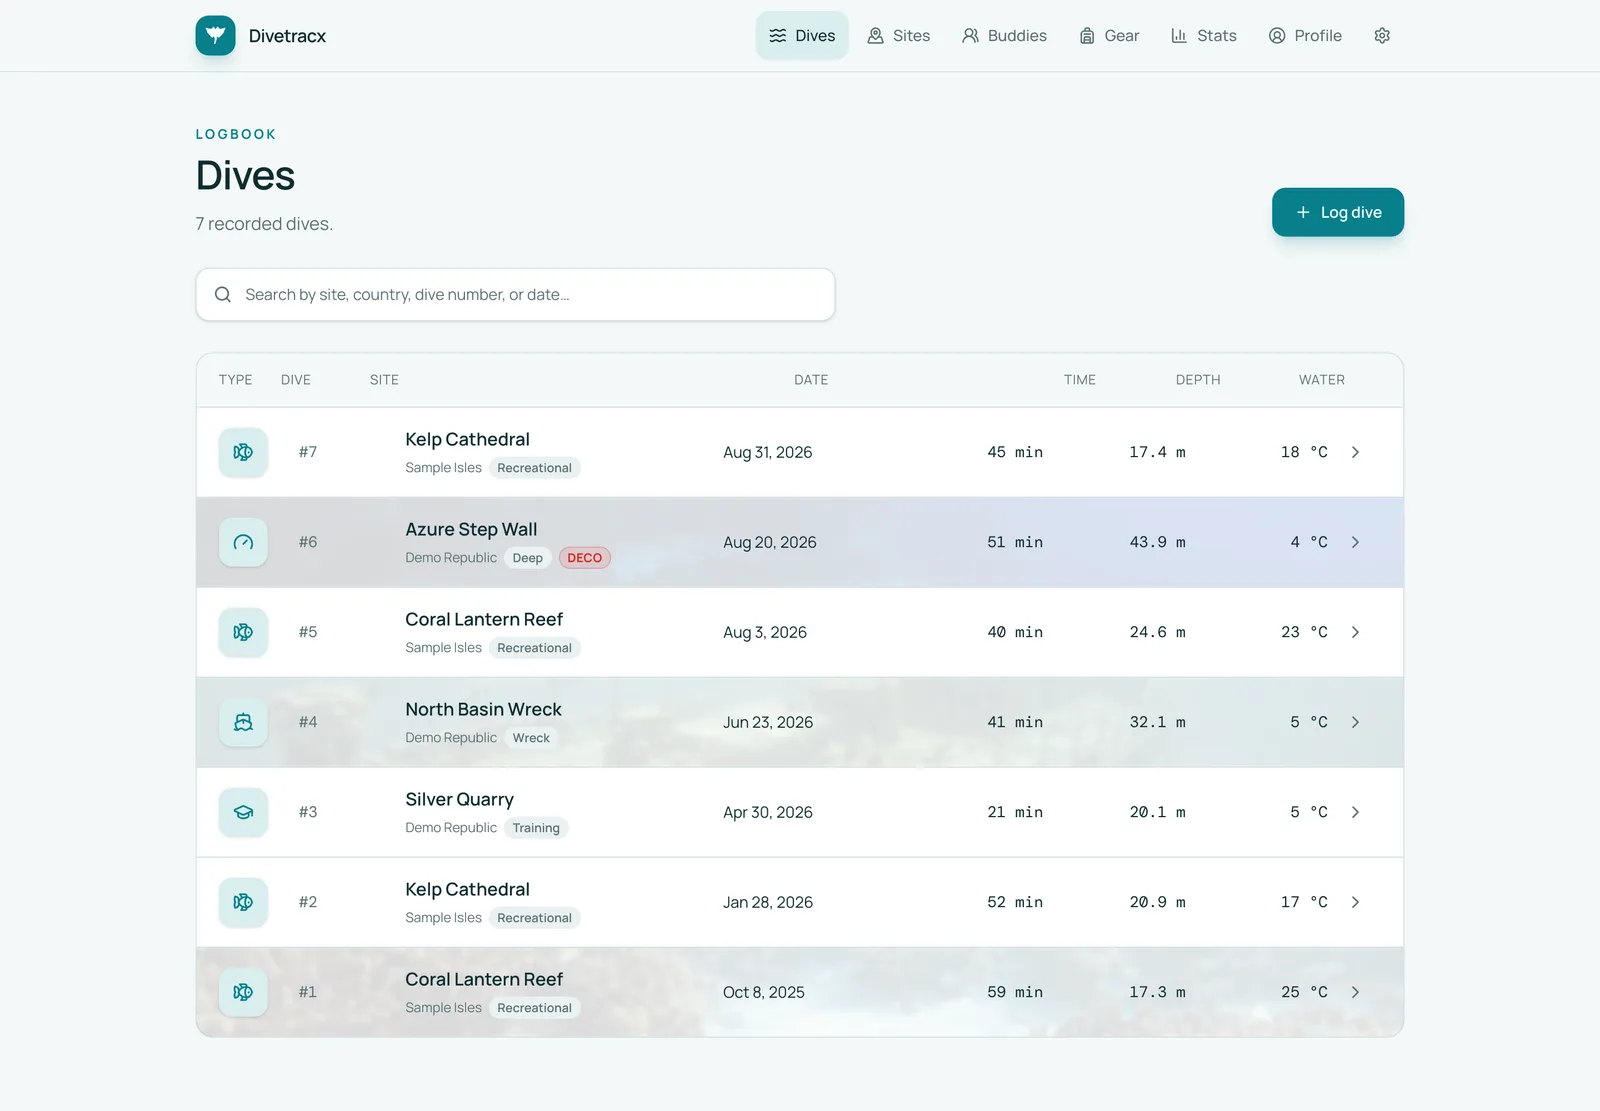
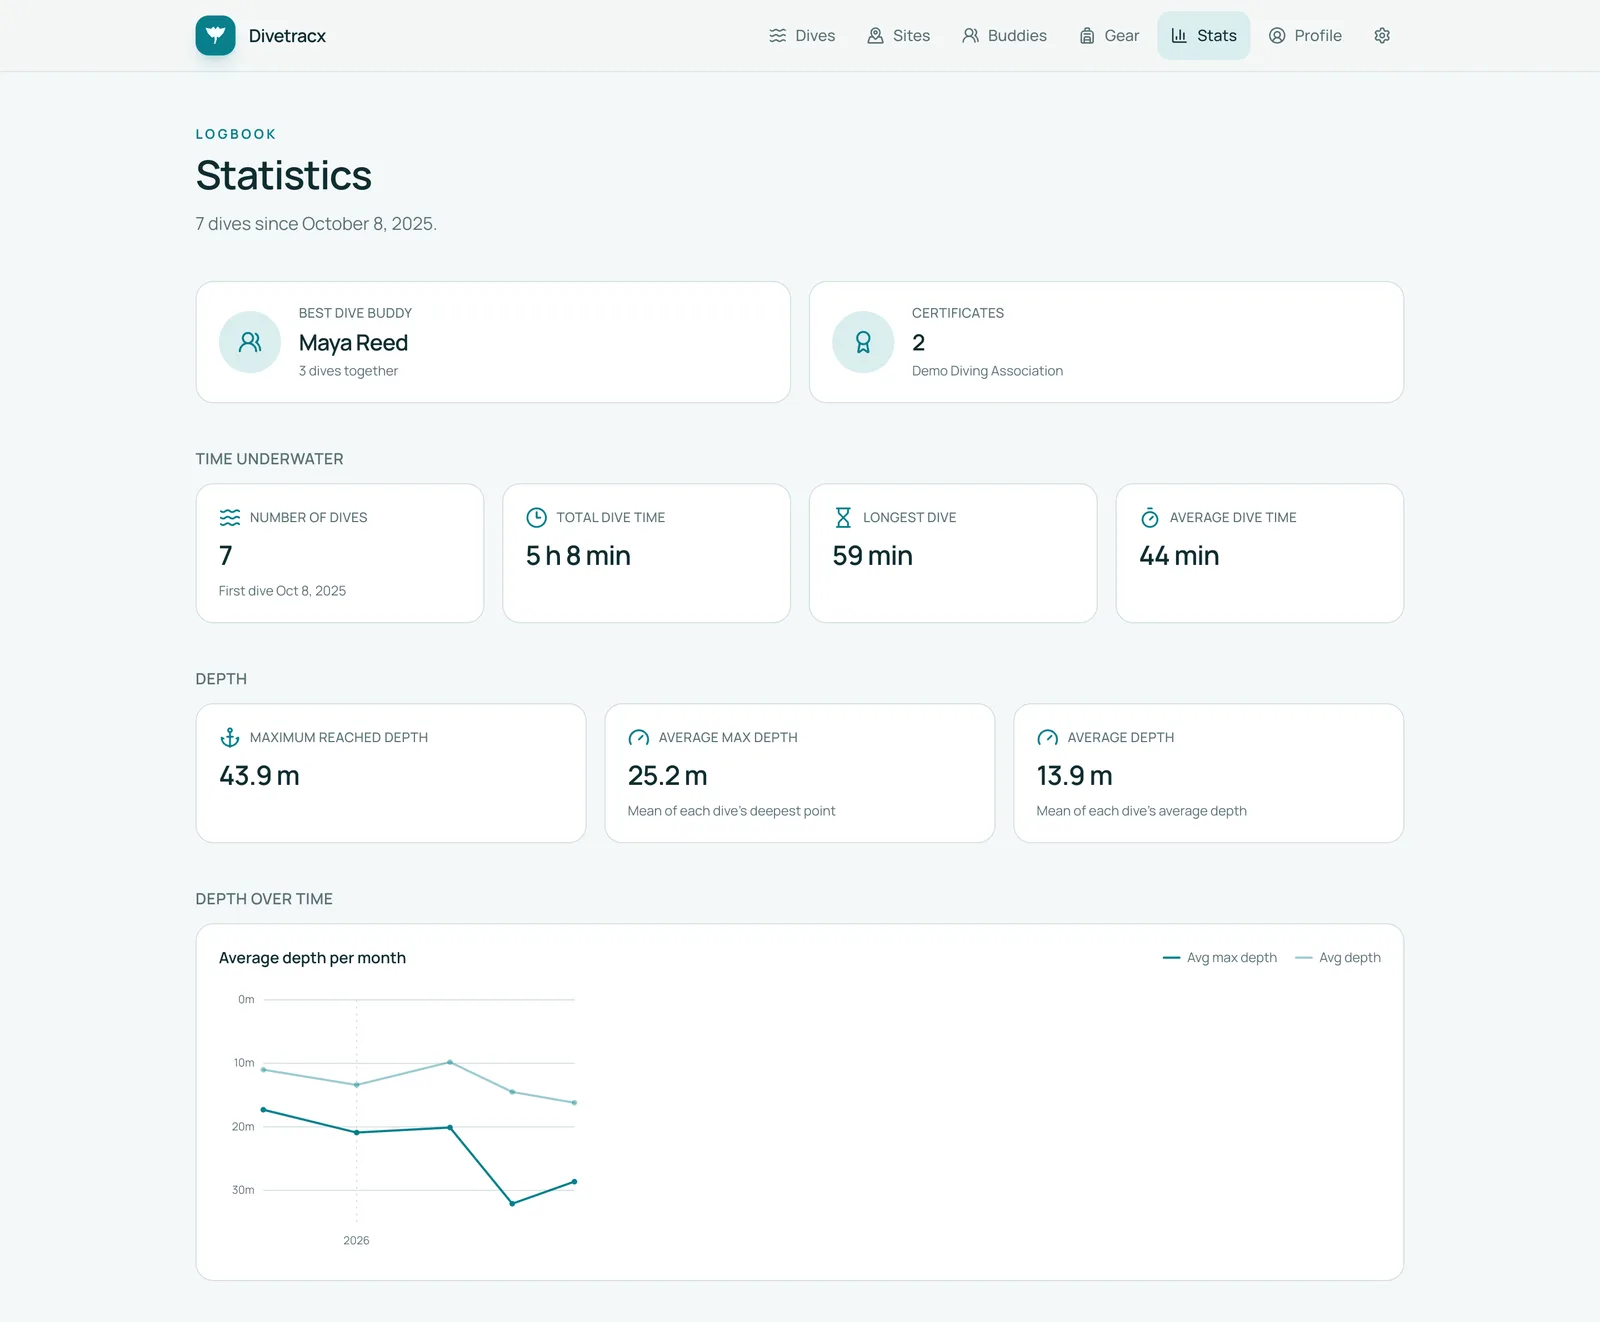
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Desplegar usando Docker Compose para entornos domésticos o Helm charts en clusters. Requiere contenedores PostgreSQL y almacenamiento S3/MinIO configurados previamente. Asegurar variables de entorno para autenticación OAuth (Garmin) y credenciales de servicio Google Drive (DiveMate). El análisis técnico indica un consumo recomendado de 4 núcleos CPU y 4096 MB RAM para operación estable con base de datos y servicios auxiliares.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.