
DeepAnalyze
DeepAnalyze es el primer LLM agéntico para ciencia de datos autónoma. Permite completar tareas de análisis de datos sin intervención humana, incluyendo preparación de datos, análisis, modelado, visualización y generación de informes.
Ficha actualizada 9 nov 2026, 21:45 · upstream 2 nov 2026, 13:47 · release sin release detectada
Qué es DeepAnalyze
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
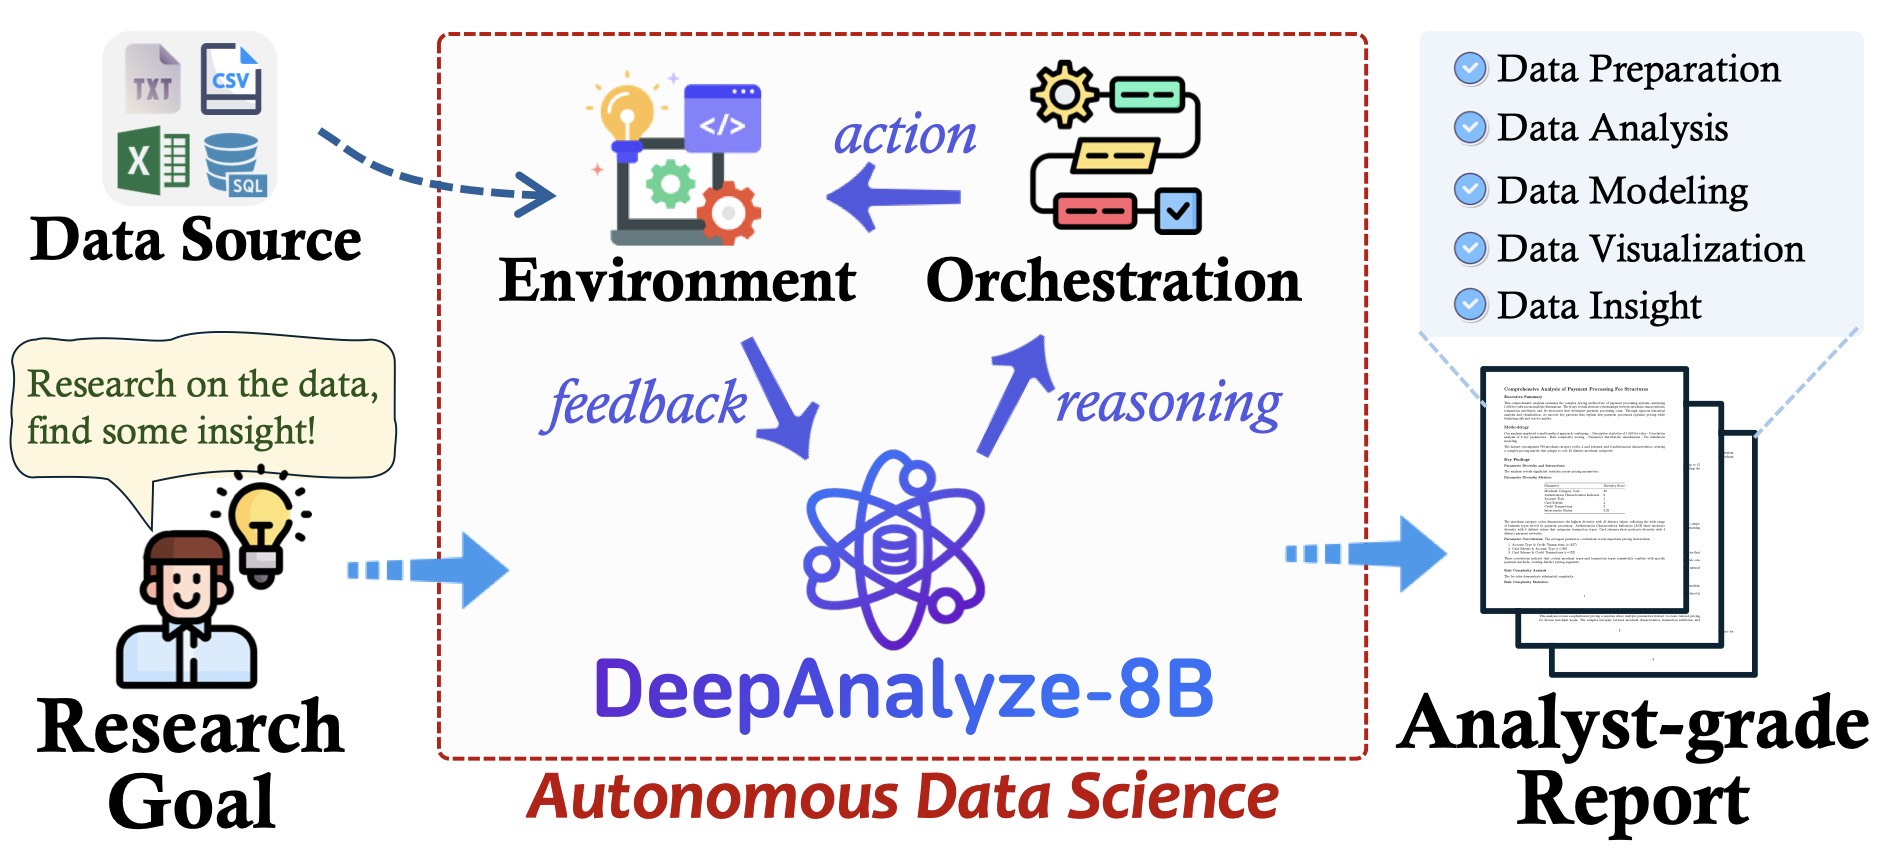
DeepAnalyze es un modelo de lenguaje basado en agentes diseñado para realizar análisis de datos de forma autónoma. Puede ejecutar todo el pipeline de ciencia de datos: desde la preparación de datos hasta la generación de reportes analíticos. El proyecto es completamente abierto, con código fuente, modelo y datos de entrenamiento disponibles públicamente. Se diferencia por su capacidad de investigación abierta sobre datos diversos (estructurados, semiestructurados e inestruccionales) y su enfoque en tareas orientadas a la ciencia de datos.
- Analizar grandes volúmenes de datos con un solo clic
- Realizar investigación profunda sobre fuentes de datos diversas (bases de datos, CSV, JSON, texto)
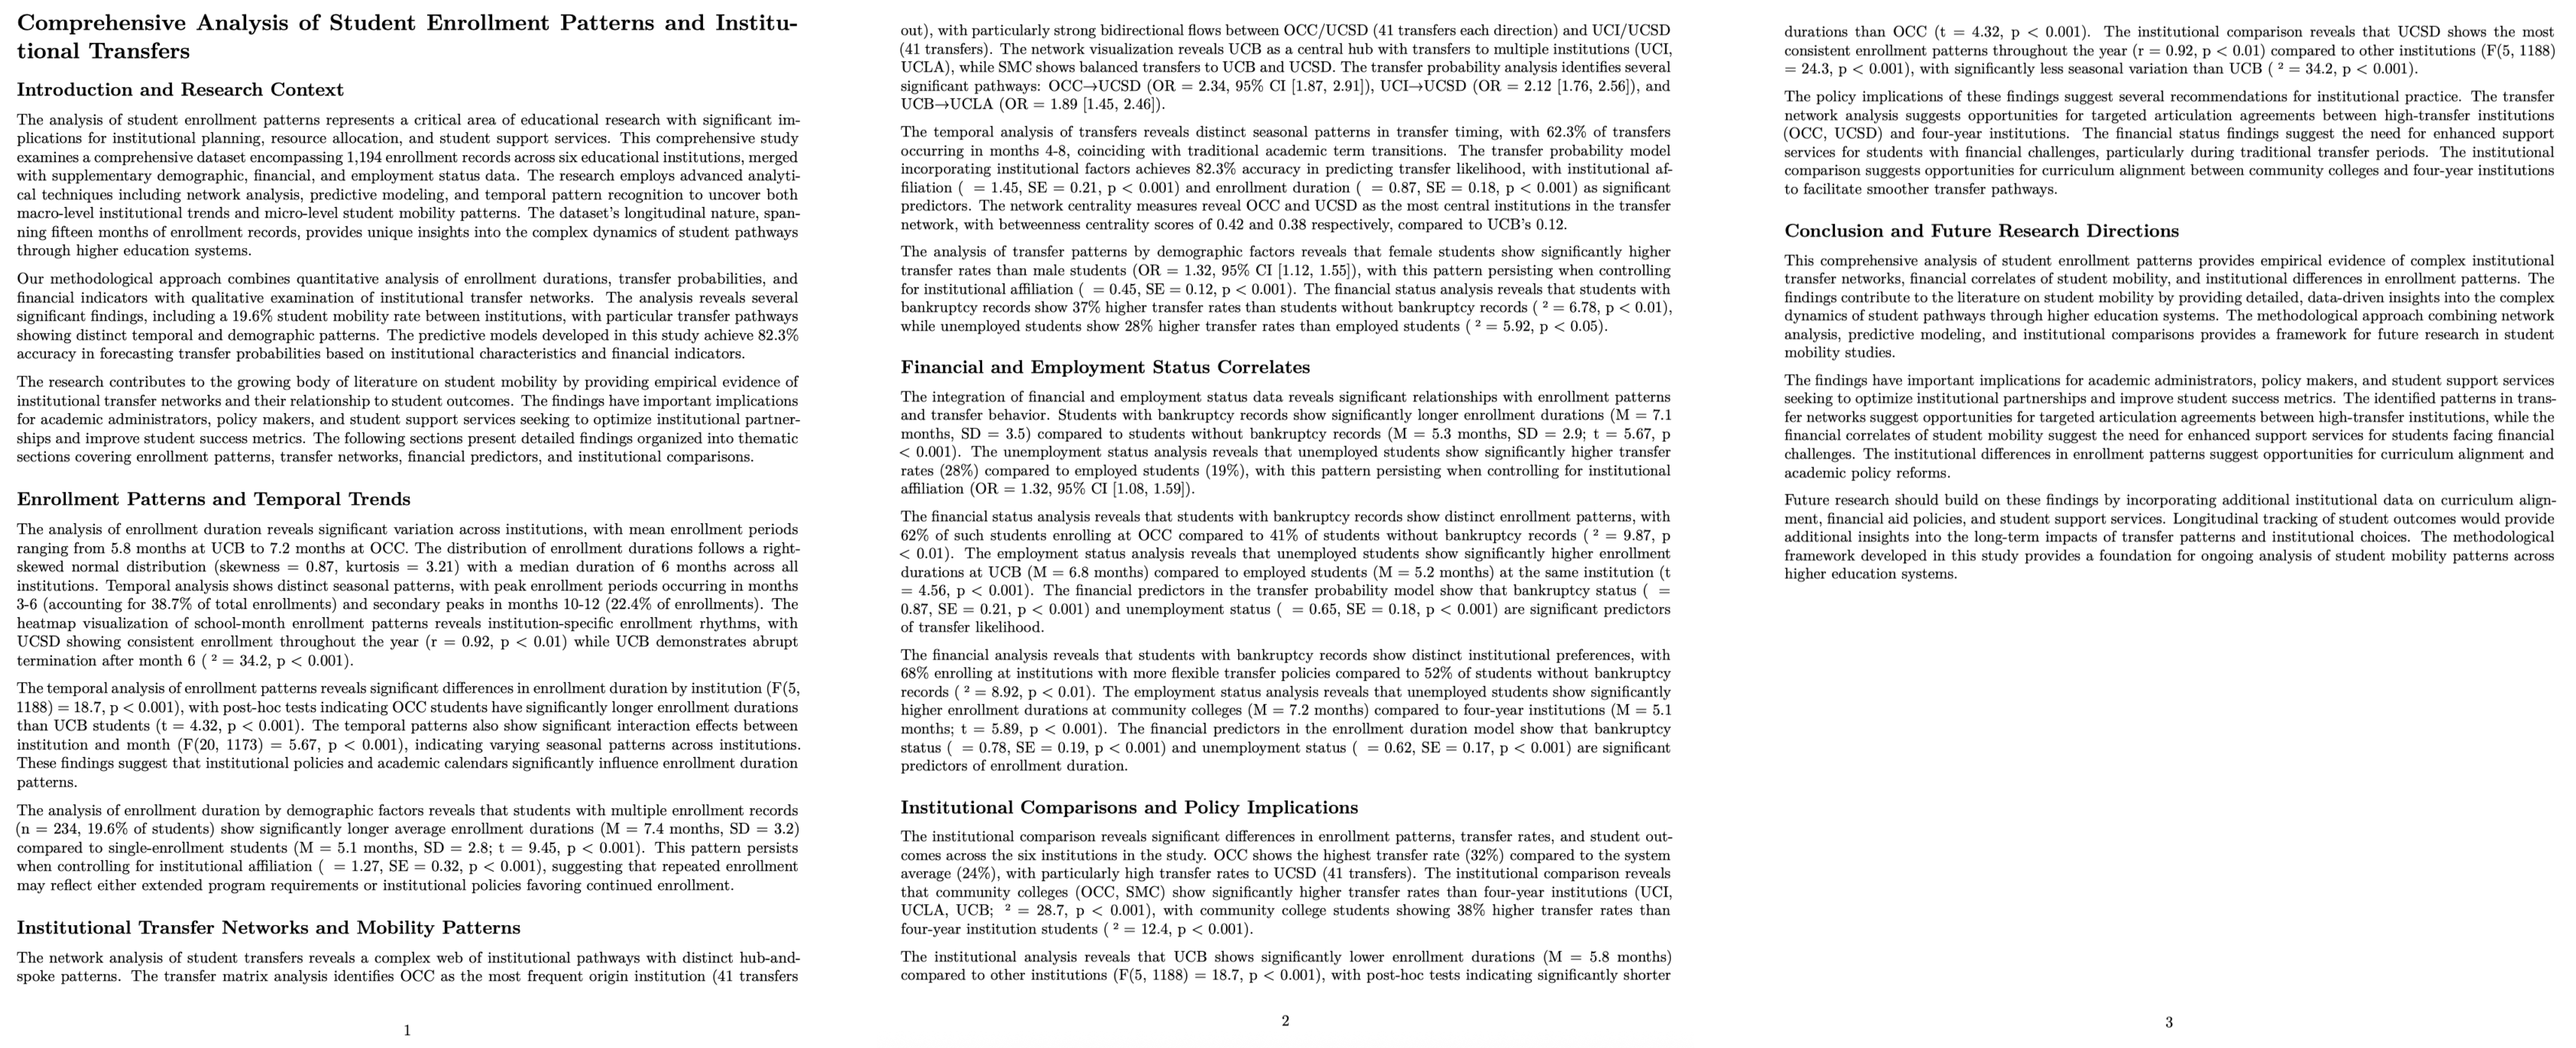
- Generar informes analíticos profesionales sin intervención humana
- Automatizar pipelines completos de ciencia de datos
- Investigar patrones y tendencias en datos estructurados e inestruccionales
- Crear dashboards interactivos con análisis predictivo
- Es el primer LLM agéntico dedicado a la ciencia de datos, capaz de completar todo el pipeline sin intervención humana.
- Soporta múltiples fuentes de datos: bases de datos estructuradas, archivos CSV/Excel, JSON/XML y documentos no estructurados como TXT o Markdown.
- El modelo DeepAnalyze-8B está disponible en HuggingFace con licencia MIT.
- Código fuente completo disponible en GitHub (https://github.com/ruc-datalab/DeepAnalyze).
- Soporta ejecución de código en entornos sandboxados vía Docker o vLLM.
- Compartido por la comunidad académica china y estadounidense, con contribuciones de múltiples autores.
- Depende de una conexión a internet para acceder a modelos externos como HuggingFace o APIs de terceros.
- La precisión del análisis depende de la calidad de los datos de entrenamiento (DataScience-Instruct-500K).
- No garantiza resultados exactos en todos los casos, especialmente con datos muy específicos o poco documentados.
- El modelo puede generar respuestas incorrectas si no se proporciona contexto suficiente sobre el dominio del problema.
- La ejecución de código requiere un entorno de ejecución adecuado (Docker, vLLM, etc.) y configuración adicional.
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.

Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Pendiente de la cola editorial R11-R6 con investigación verificable.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.