
crawlseo
CrawlSEO es una plataforma open-source para monitorización SEO auto-alojada que integra Google Search Console, crawler web, Core Web Vitals y servidor MCP para agentes AI. Ofrece análisis de palabras clave, backlinks, auditorías técnicas y alertas en un dashboard unificado con frontend Next.js y bac
Ficha actualizada 26 sept 2026, 23:22 · upstream 24 sept 2026, 14:25 · release v0.1.0
Qué es crawlseo
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
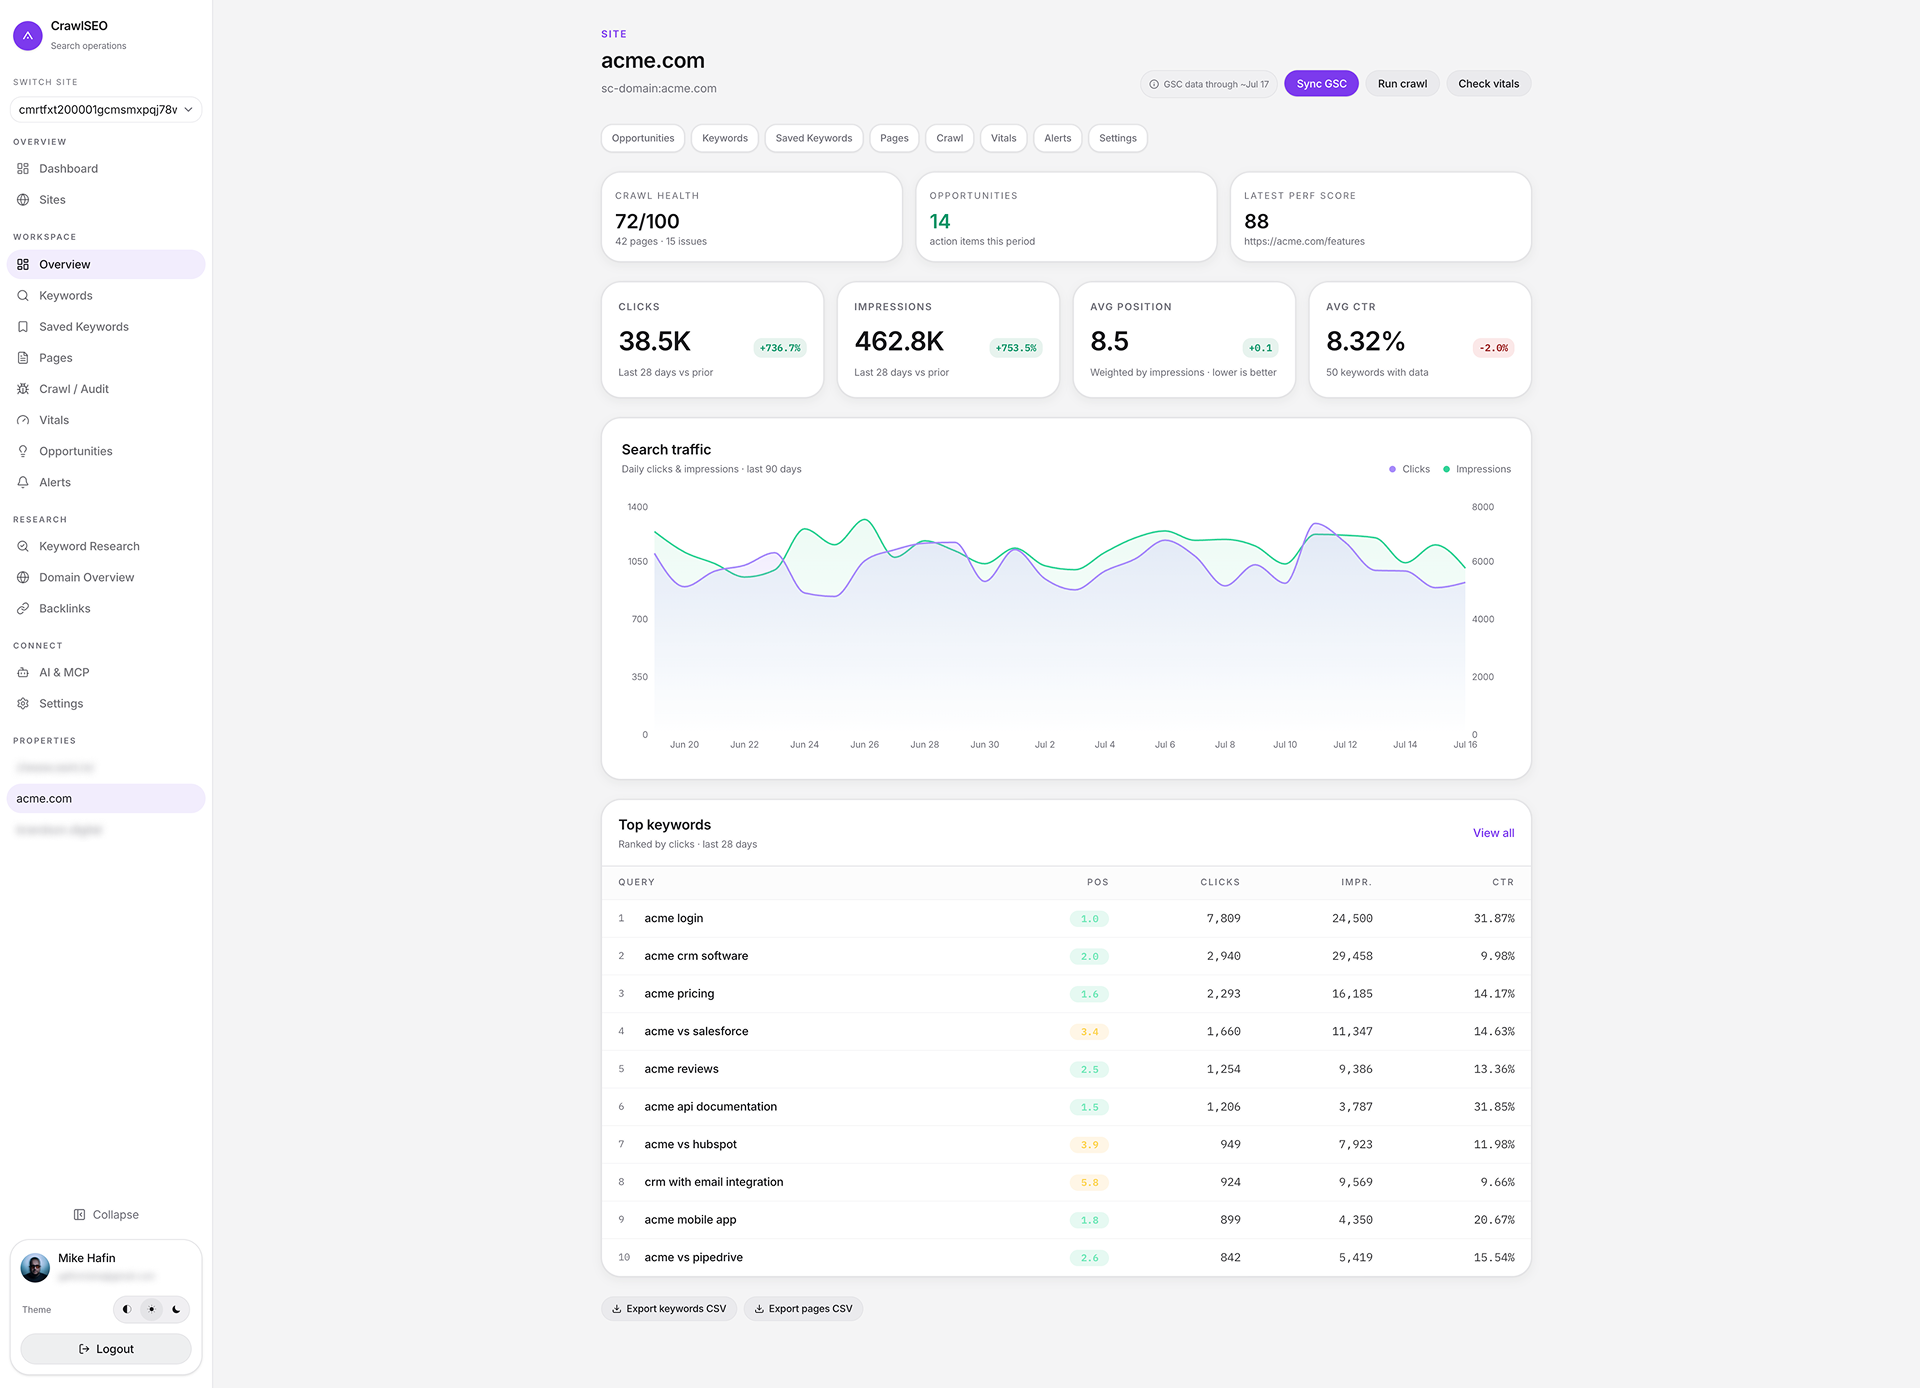
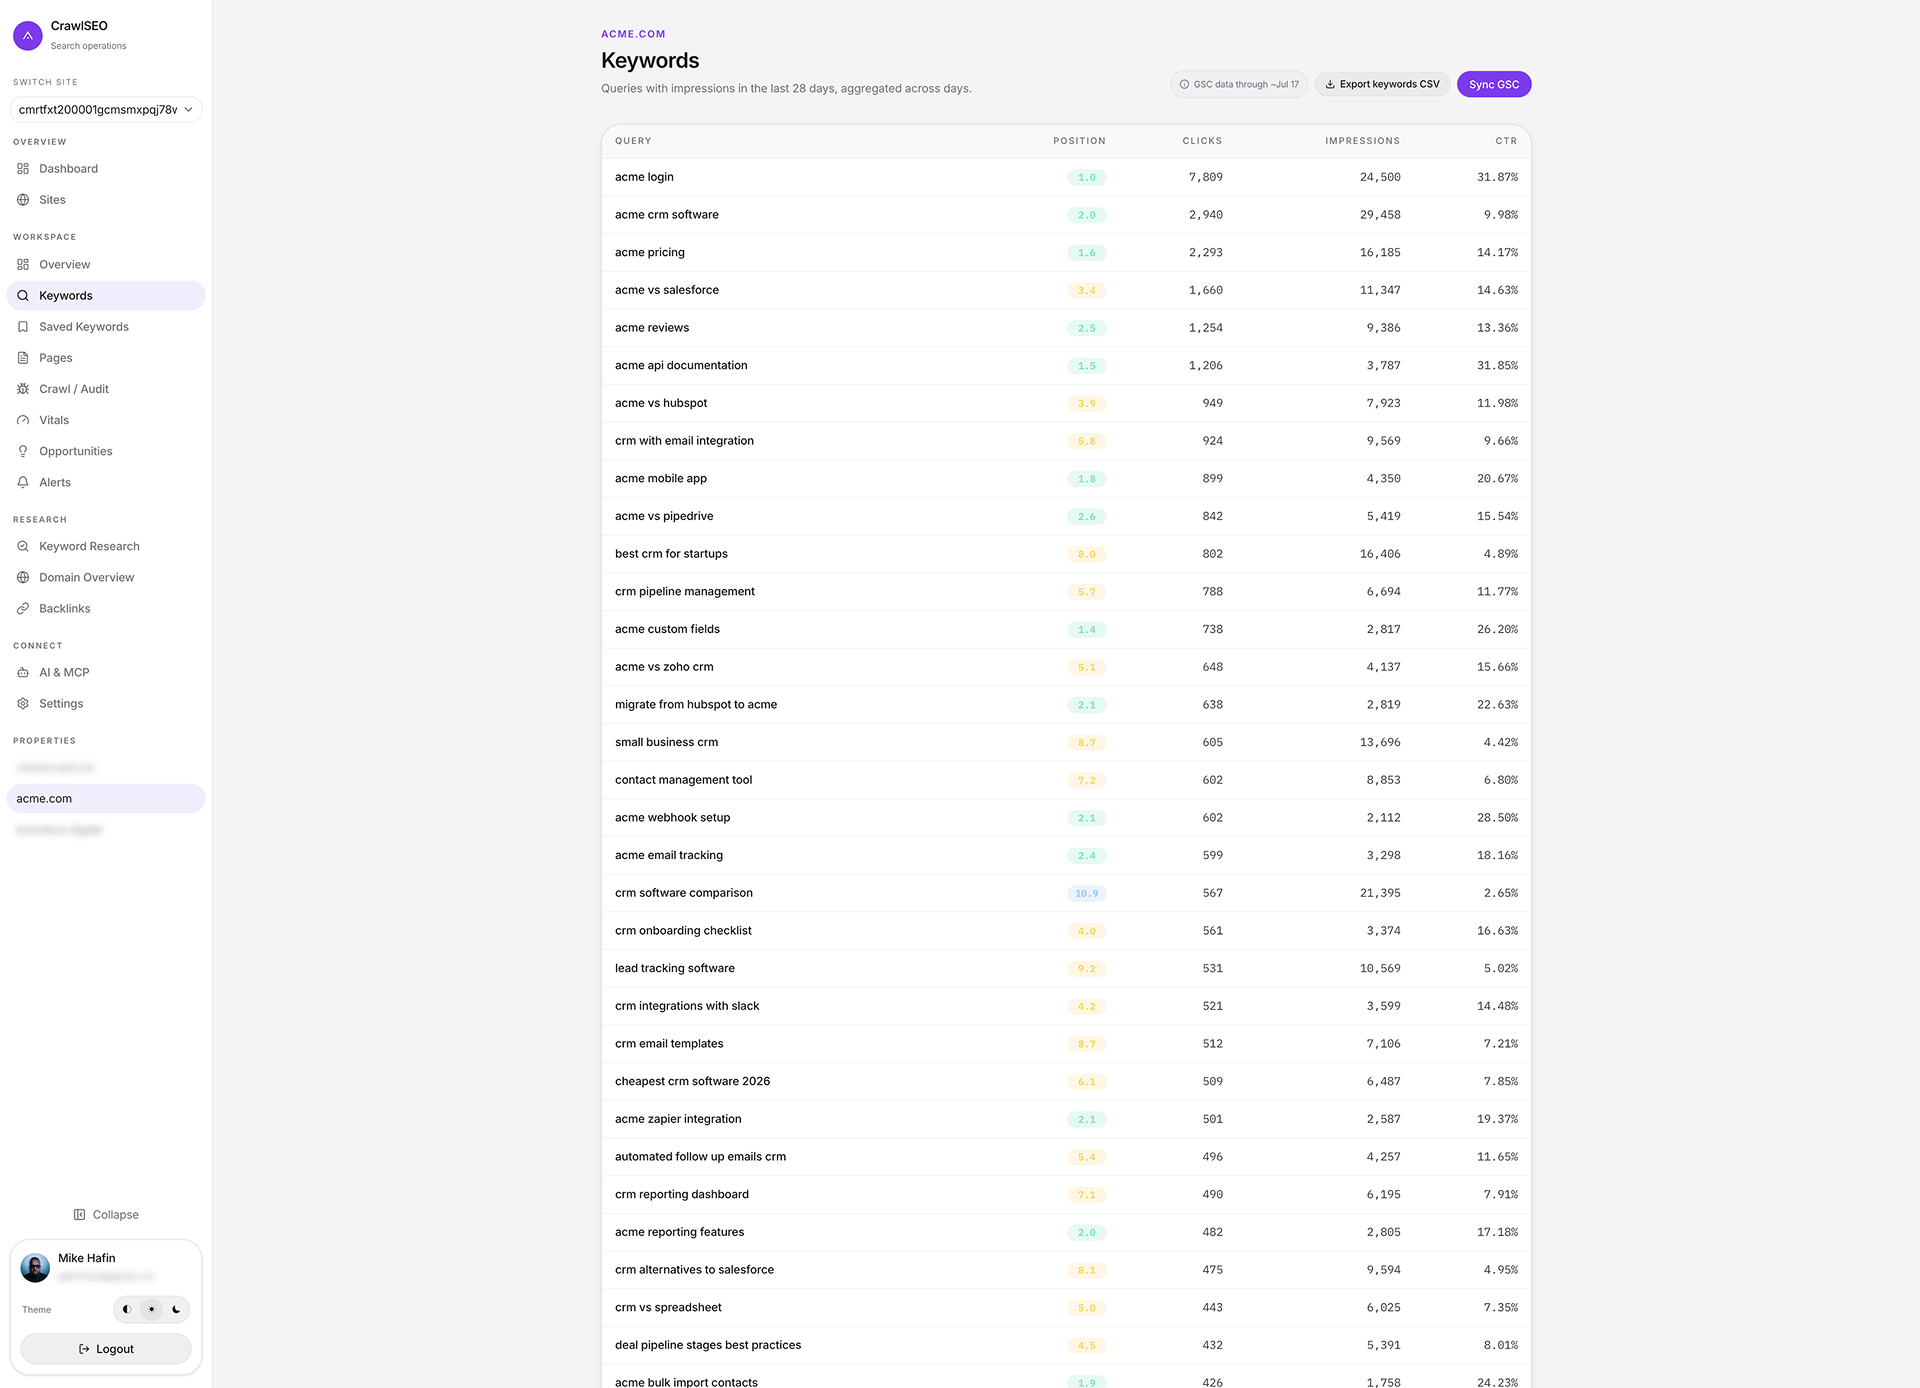
CrawlSEO es una solución open-source de monitorización SEO diseñada para fundadores y equipos técnicos que buscan alternativas a herramientas como Ahrefs o Semrush. Integra Google Search Console, un crawler web capaz de analizar hasta 2.000 páginas, métricas de Core Web Vitals (LCP, CLS, INP) y un servidor MCP para integración con agentes AI como Claude Code. La plataforma permite autenticación vía OAuth con Google, almacenamiento en PostgreSQL y ofrece exportación a CSV, alertas por email/Slack/Telegram y detección de oportunidades SEO como keywords de distancia o cannibalización.
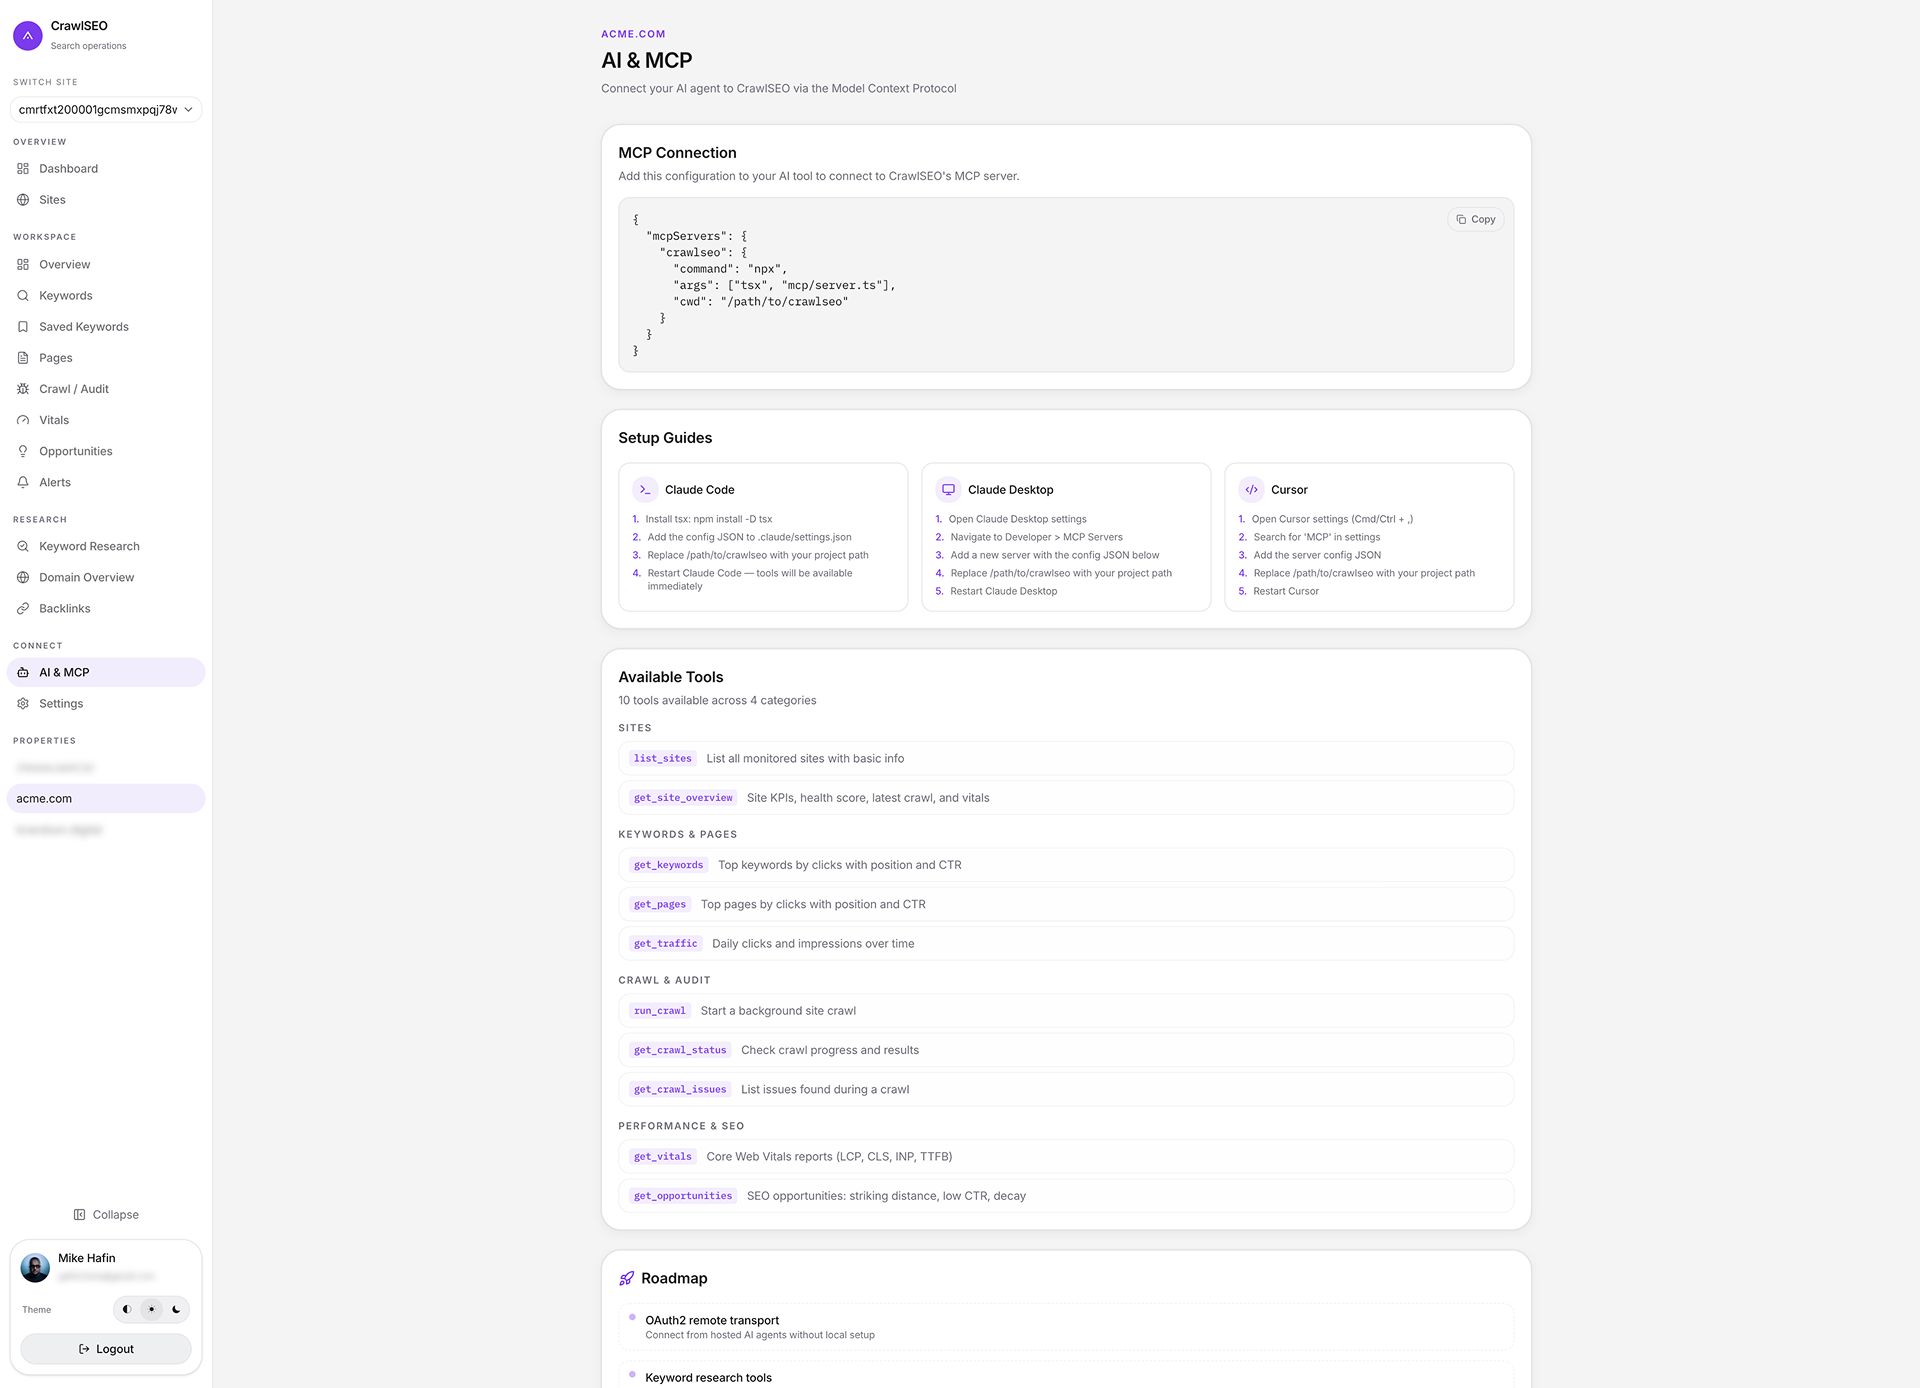
La arquitectura se basa en Next.js 16 con App Router, TypeScript, Prisma como ORM y Tailwind CSS para el frontend. Incluye componentes de visualización con Recharts e iconos Lucide React. El servidor MCP expone 10 herramientas para consultar datos SEO directamente desde la terminal sin salir del entorno de desarrollo. Soporta despliegue mediante Docker Compose con imágenes multi-architectura (amd64/arm64) y migraciones automáticas de base de datos al iniciar el contenedor.
Las funcionalidades clave incluyen seguimiento histórico de posiciones, análisis de backlinks con soporte BYOK (trae tus propias claves), investigación de palabras clave con DataForSEO opcional y fallback gratuito mediante Google Autocomplete. El sistema permite personalización de temas (claro/oscuro) y configuración de variables de entorno para autenticación, base de datos y URLs. La licencia MIT garantiza libertad de uso, modificación y distribución sin coste.
- Monitorización SEO auto-alojada para empresas que requieren privacidad de datos y control total sobre su información
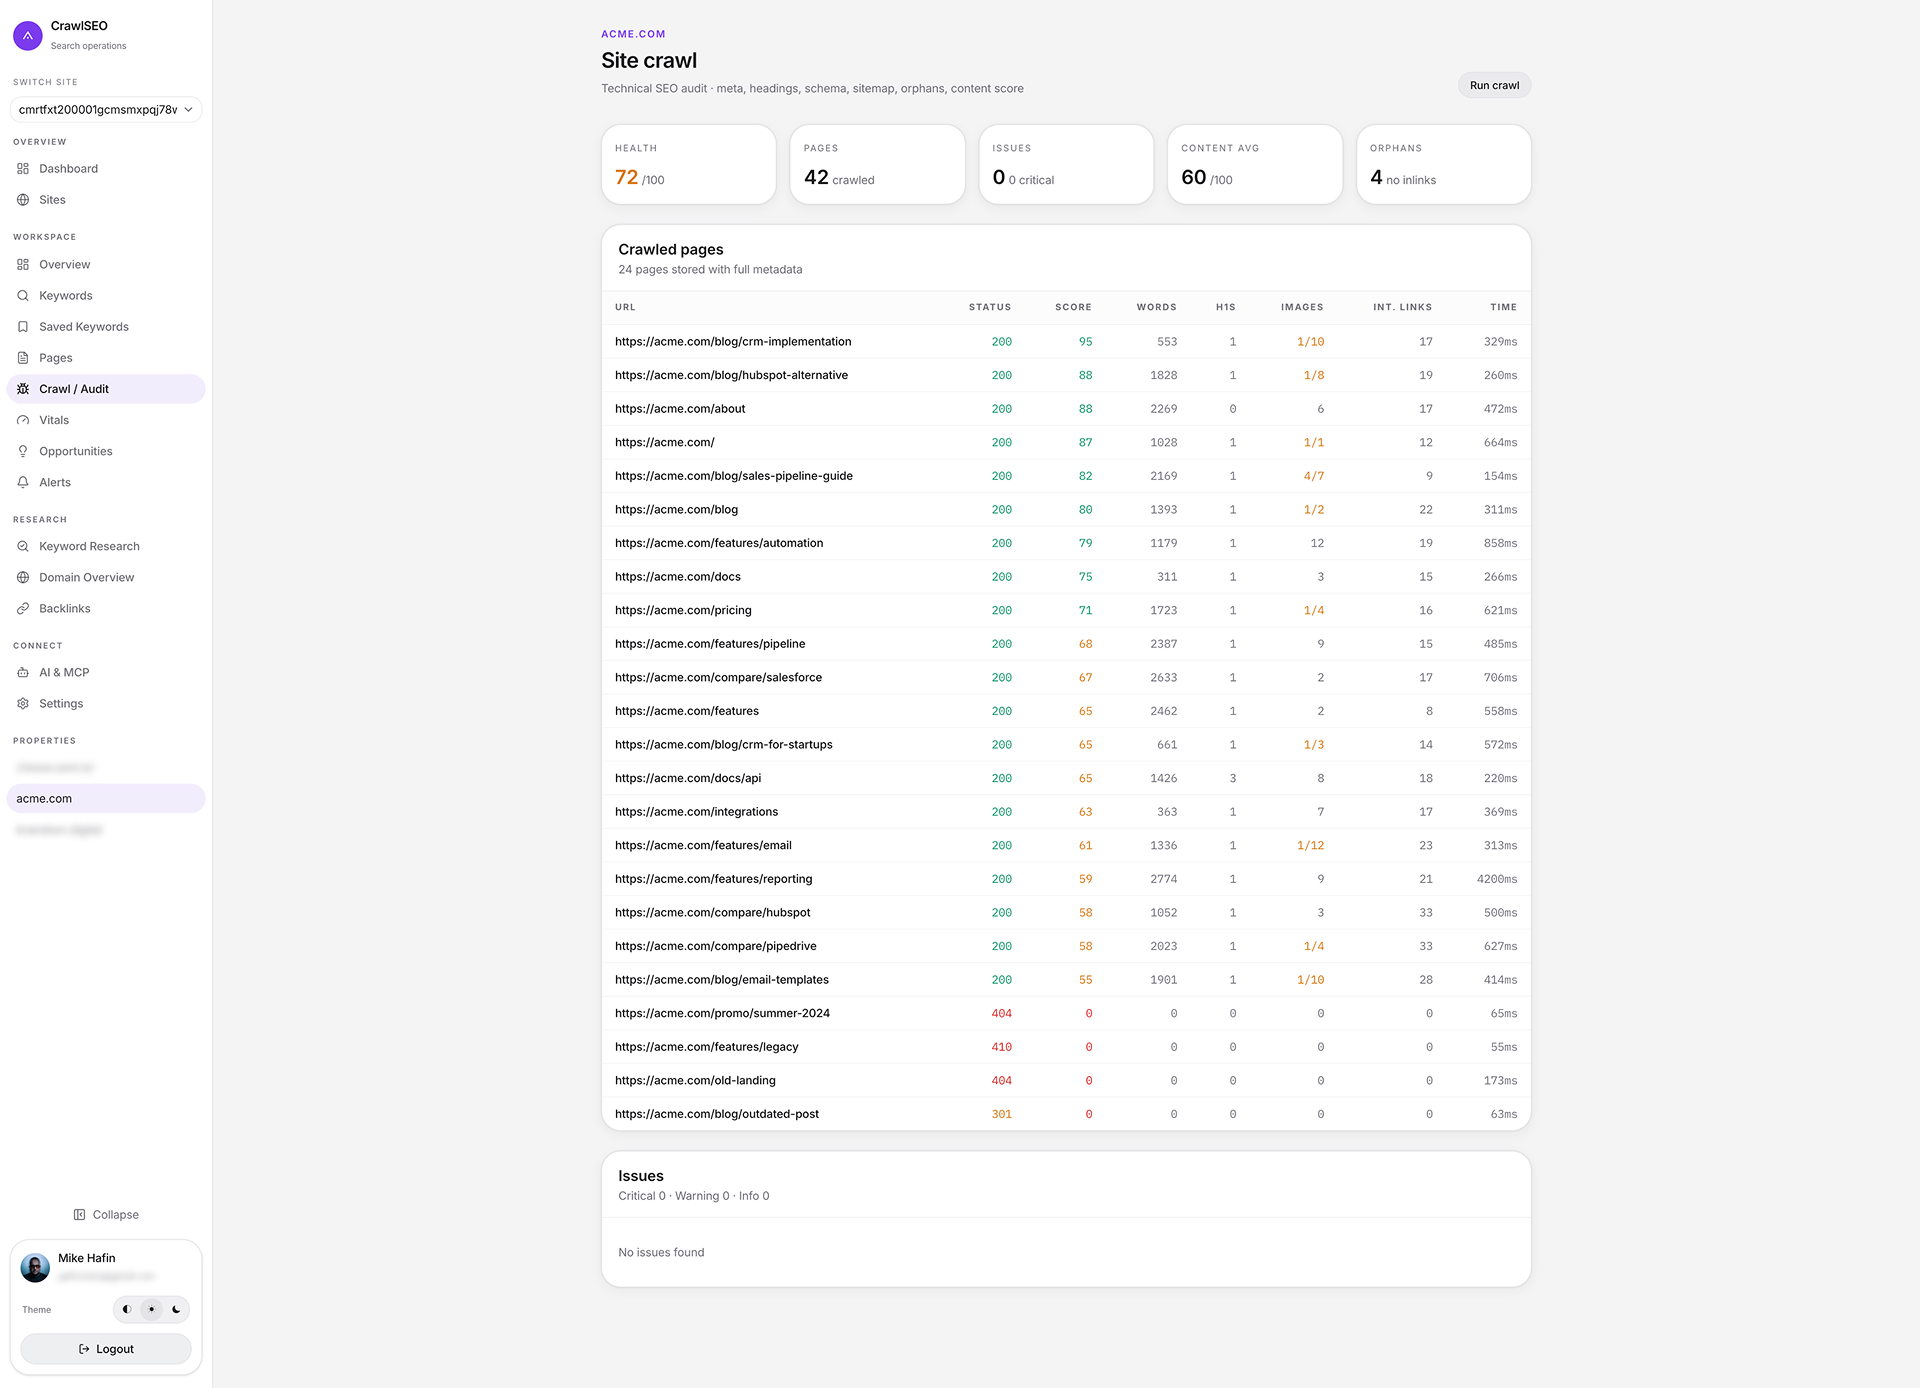
- Auditoría técnica de sitios web con detección de errores, puntuación de salud y recomendaciones de remediación
- Integración con agentes AI mediante servidor MCP para consultas SEO desde Claude Code, Cursor o herramientas similares
- Seguimiento de Core Web Vitals en móviles y escritorio con comparación lado a lado y alertas de degradación
- Investigación de palabras clave y análisis de backlinks sin costes mensuales, usando claves propias o fallback gratuito
- Exportación de datos SEO a CSV para análisis offline o integración con herramientas externas de reporting
- Integración nativa con Google Search Console vía OAuth 2.0 con scopes específicos para lectura de datos de webmasters
- Crawler web que analiza hasta 2.000 páginas concurrentemente con detección de 16 tipos de errores y puntuación de salud
- Servidor MCP con 10 herramientas documentadas para integración directa con agentes AI sin intermediarios
- Arquitectura Docker Compose con soporte multi-architectura (linux/amd64, linux/arm64) y migraciones automáticas de Prisma
- Licencia MIT que garantiza uso gratuito, modificación del código y distribución sin restricciones comerciales
- Sistema de alertas configurable por email, Slack, Telegram o webhook para notificaciones de tráfico, posiciones o errores 404
- Requiere configuración manual de credenciales OAuth de Google Cloud Console antes del despliegue inicial
- La investigación avanzada de palabras clave depende opcionalmente de DataForSEO; el fallback gratuito tiene límites implícitos
- El crawler web está limitado a 2.000 páginas por ejecución según la documentación proporcionada
- Necesita Node.js 20+ y PostgreSQL para despliegue manual sin contenedores preconfigurados
- La autenticación requiere configuración de variables de entorno específicas (DATABASE_URL, NEXTAUTH_SECRET, etc.)
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.

Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Recomendado usar Docker Compose con imagen ghcr.io/crawlseo/crawlseo:latest. Configurar .env.local con credenciales OAuth de Google antes de iniciar. Para despliegue manual, instalar Node.js 20+, PostgreSQL y ejecutar migraciones Prisma. Soporta imágenes multi-architectura (amd64/arm64). Usar etiquetas inmutables para versiones específicas. Asegurar que NEXTAUTH_SECRET esté cifrado con openssl. Variables obligatorias: DATABASE_URL, GOOGLE_CLIENT_ID, GOOGLE_CLIENT_SECRET.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.