
audio-intel
Estación de trabajo offline-first para reconocimiento y síntesis de voz basada en Qwen3, con interfaz web bilingüe, APIs OpenAI-compatible y gestión local de modelos en Linux/Windows.
Ficha actualizada 28 sept 2026, 4:12 · upstream 28 sept 2026, 4:11 · release v0.1.19
Qué es audio-intel
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
audio-intel es una estación de trabajo privada para reconocimiento automático del habla (ASR) y síntesis de voz (TTS), impulsada por los modelos Qwen3. Opera en un enfoque offline-first: tras la configuración inicial, las inferencias se ejecutan localmente sin conexión a internet, manteniendo todos los datos de entrada, salida, voces y registros en directorios controlados por el proyecto. El sistema soporta tanto entornos con aceleración GPU NVIDIA como perfiles CPU-only para reducir la huella de dependencias.
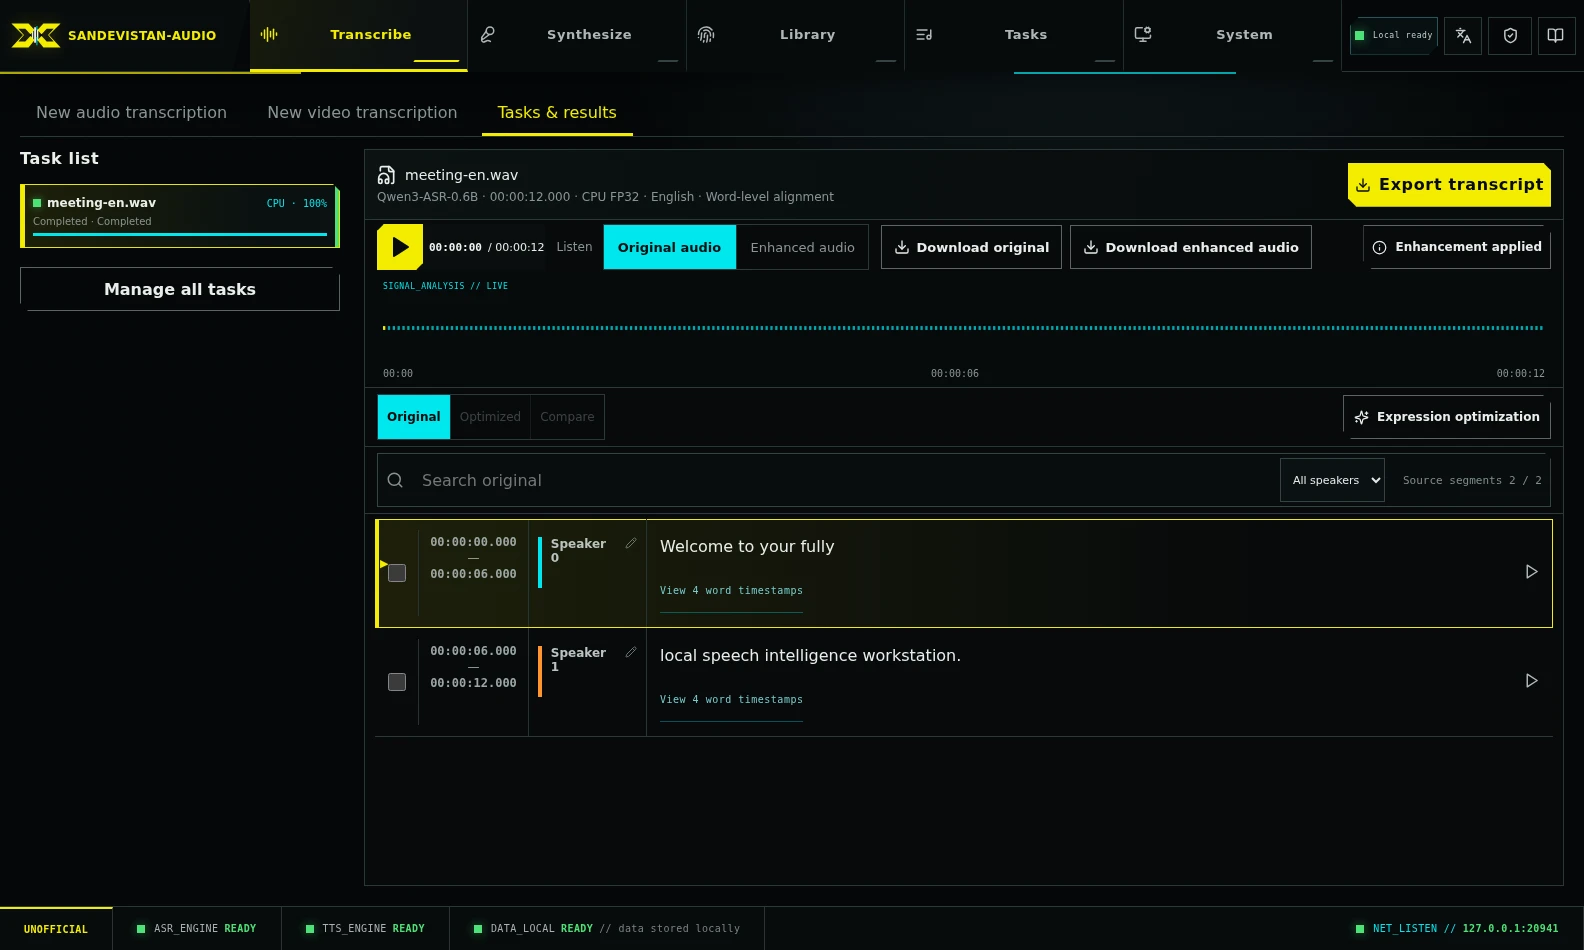
- Transcribir reuniones multi-orador con diarización, timestamps a nivel de palabra y exportación a JSON/SRT/VTT/TXT
- Crear un estudio de voz local privado con clonación de voz, voces predefinidas y diseño de voz mediante el modelo VoiceDesign 1.7B
- Integrar un backend de habla duradero en herramientas locales mediante APIs asíncronas o compatibles con OpenAI
- Generar documentos sintéticos (EPUB, PDF, DOCX) a partir de texto con recuperación de puntos de control y descargas por álbum
- Ejecución offline tras configuración inicial con modelos Qwen3-ASR/TTS fijados en revisiones específicas
- Aislamiento cuidadoso de procesos: entornos Python separados para ASR y TTS debido a versiones incompatibles de Transformers
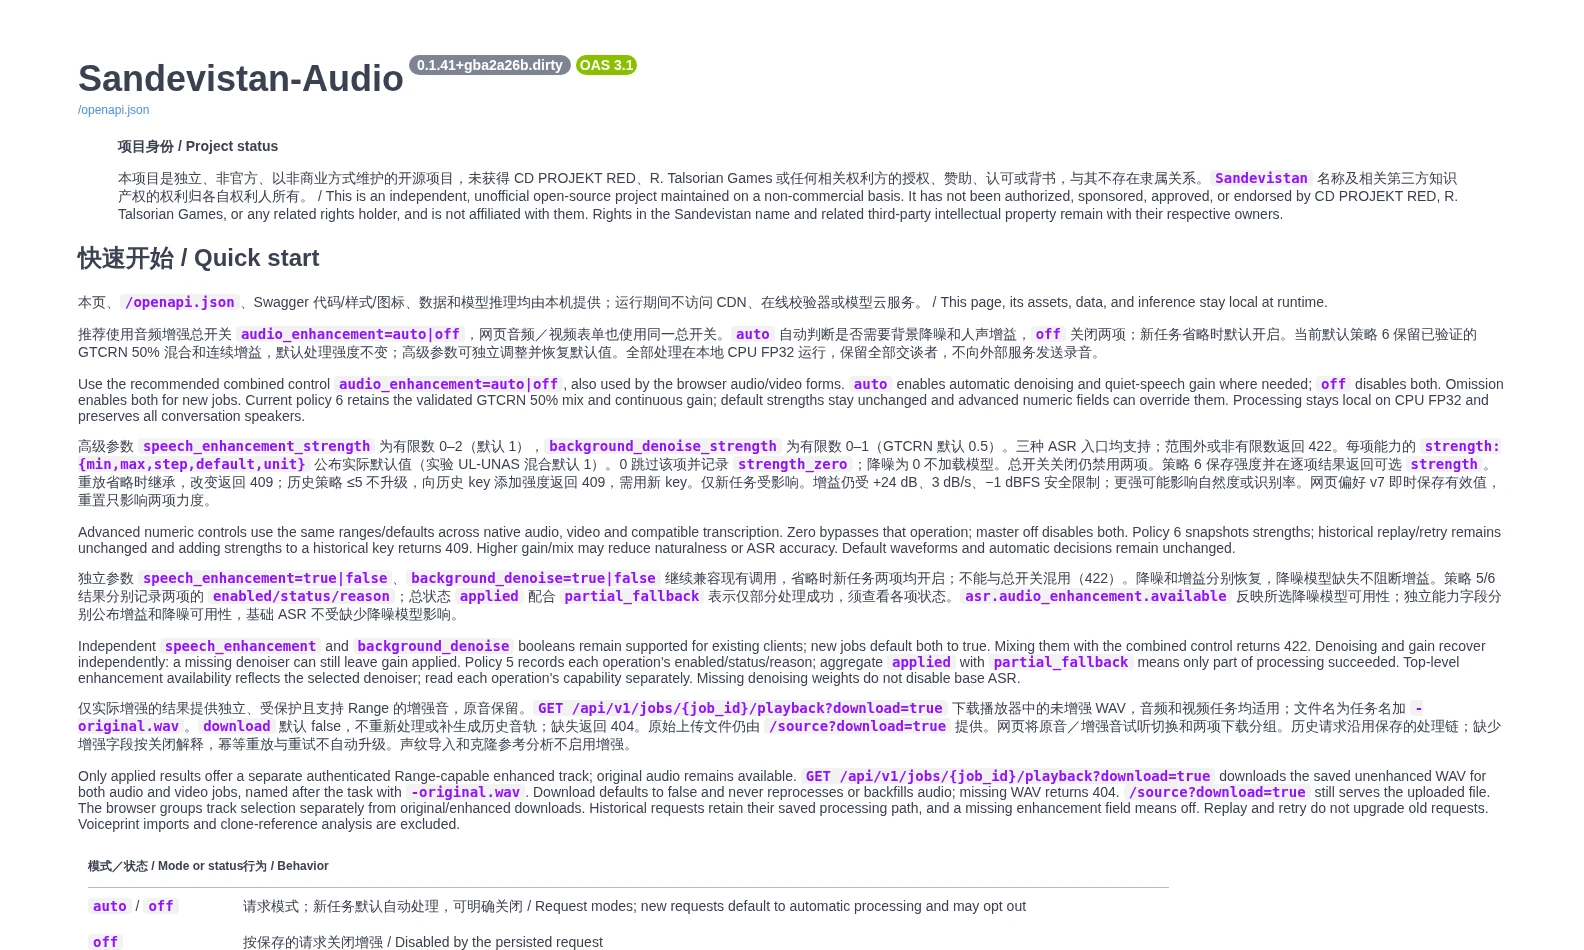
- Interfaz web bilingüe (inglés/chino simplificado) con guía Swagger local y endpoints OpenAI-compatible
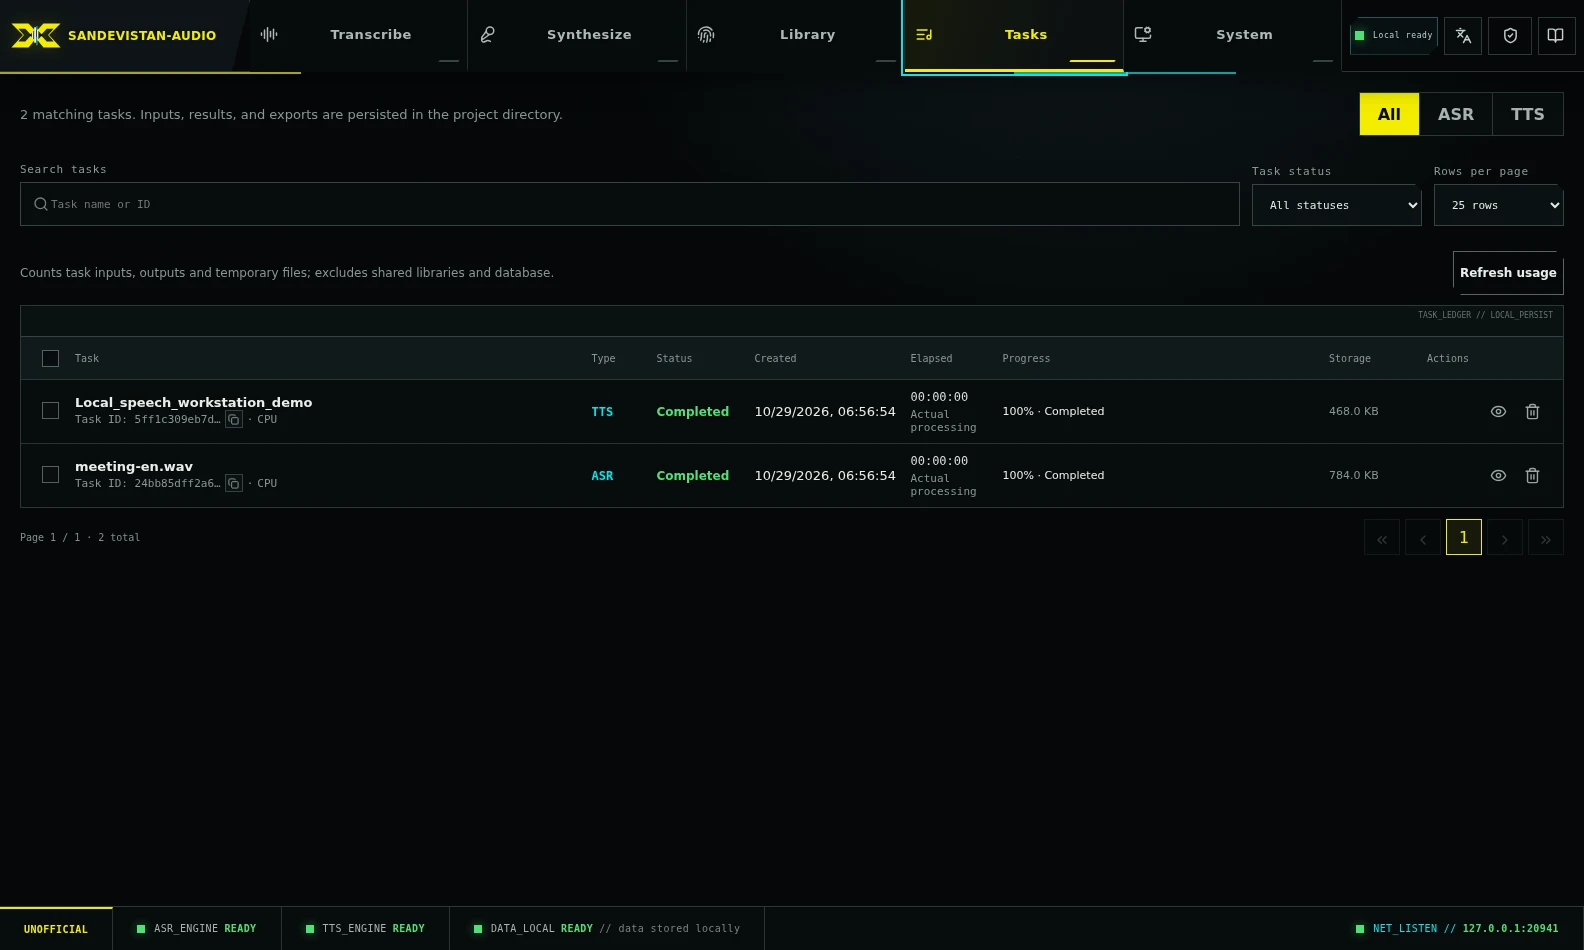
- Gestión persistente de tareas mediante colas SQLite WAL con historial, reintentos y cancelación segura
- Soporte nativo para Linux Ubuntu 22.04/24.04 y Windows 11 x64 con perfiles Full (GPU) y CPU-only
- macOS y arquitecturas ARM no están validados oficialmente
- No existe una imagen de contenedor oficial; el usuario debe construir runtimes y modelos manualmente si se usa OCI
- La inferencia GPU en Windows nativo con modelos reales aún no ha sido validada por CI
- Los perfiles CPU-only aceptan inferencias sustancialmente más lentas a cambio de una huella de dependencias reducida
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Recomendado: Full profile (43 GiB disco, 16 GB RAM mínimo). Para GPU: VRAM total ≥3840 MiB (0.6B) o ≥7936 MiB (1.7B). Copiar .env.example a .env antes de iniciar. Comandos clave: ./service.sh setup all y ./service.sh start all. Verificar salud con curl http://127.0.0.1:20810/api/v1/health. Para CPU-only: añadir --profile cpu en setup.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.