
asrserve
Servicio autoalojado de reconocimiento de voz en tiempo real y offline con modelos SOTA, diarización de hablantes y API compatible con OpenAI. Soporta GPU NVIDIA, CPU Linux y Apple Silicon nativo.
Ficha actualizada 27 sept 2026, 8:35 · upstream 27 sept 2026, 8:16 · release v1.0.4
Qué es asrserve
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
AsrServe es una plataforma de reconocimiento automático del habla (ASR) diseñada para ejecutarse localmente sin depender de servicios en la nube. Integra modelos de vanguardia como Confucius4-R2T2 para transcripción y Nemotron-3-Diarization para identificar hablantes, ofreciendo precisión superior en entornos controlados.
El servicio opera mediante una arquitectura unificada que comparte pesos del modelo entre modos offline y en tiempo real, optimizando el uso de recursos. Dispone de una API compatible con OpenAI en el puerto 17003, permitiendo integración sencilla con aplicaciones existentes, además de un endpoint WebSocket para streaming continuo.
Soporta despliegue flexible mediante contenedores Docker (GPU/CPU/Ascend) o ejecución nativa en macOS Apple Silicon sin necesidad de GPU. Incluye soporte para timestamps de palabras y segmentación por actividad vocal mediante Nemotron, facilitando el análisis detallado del contenido transcribido.
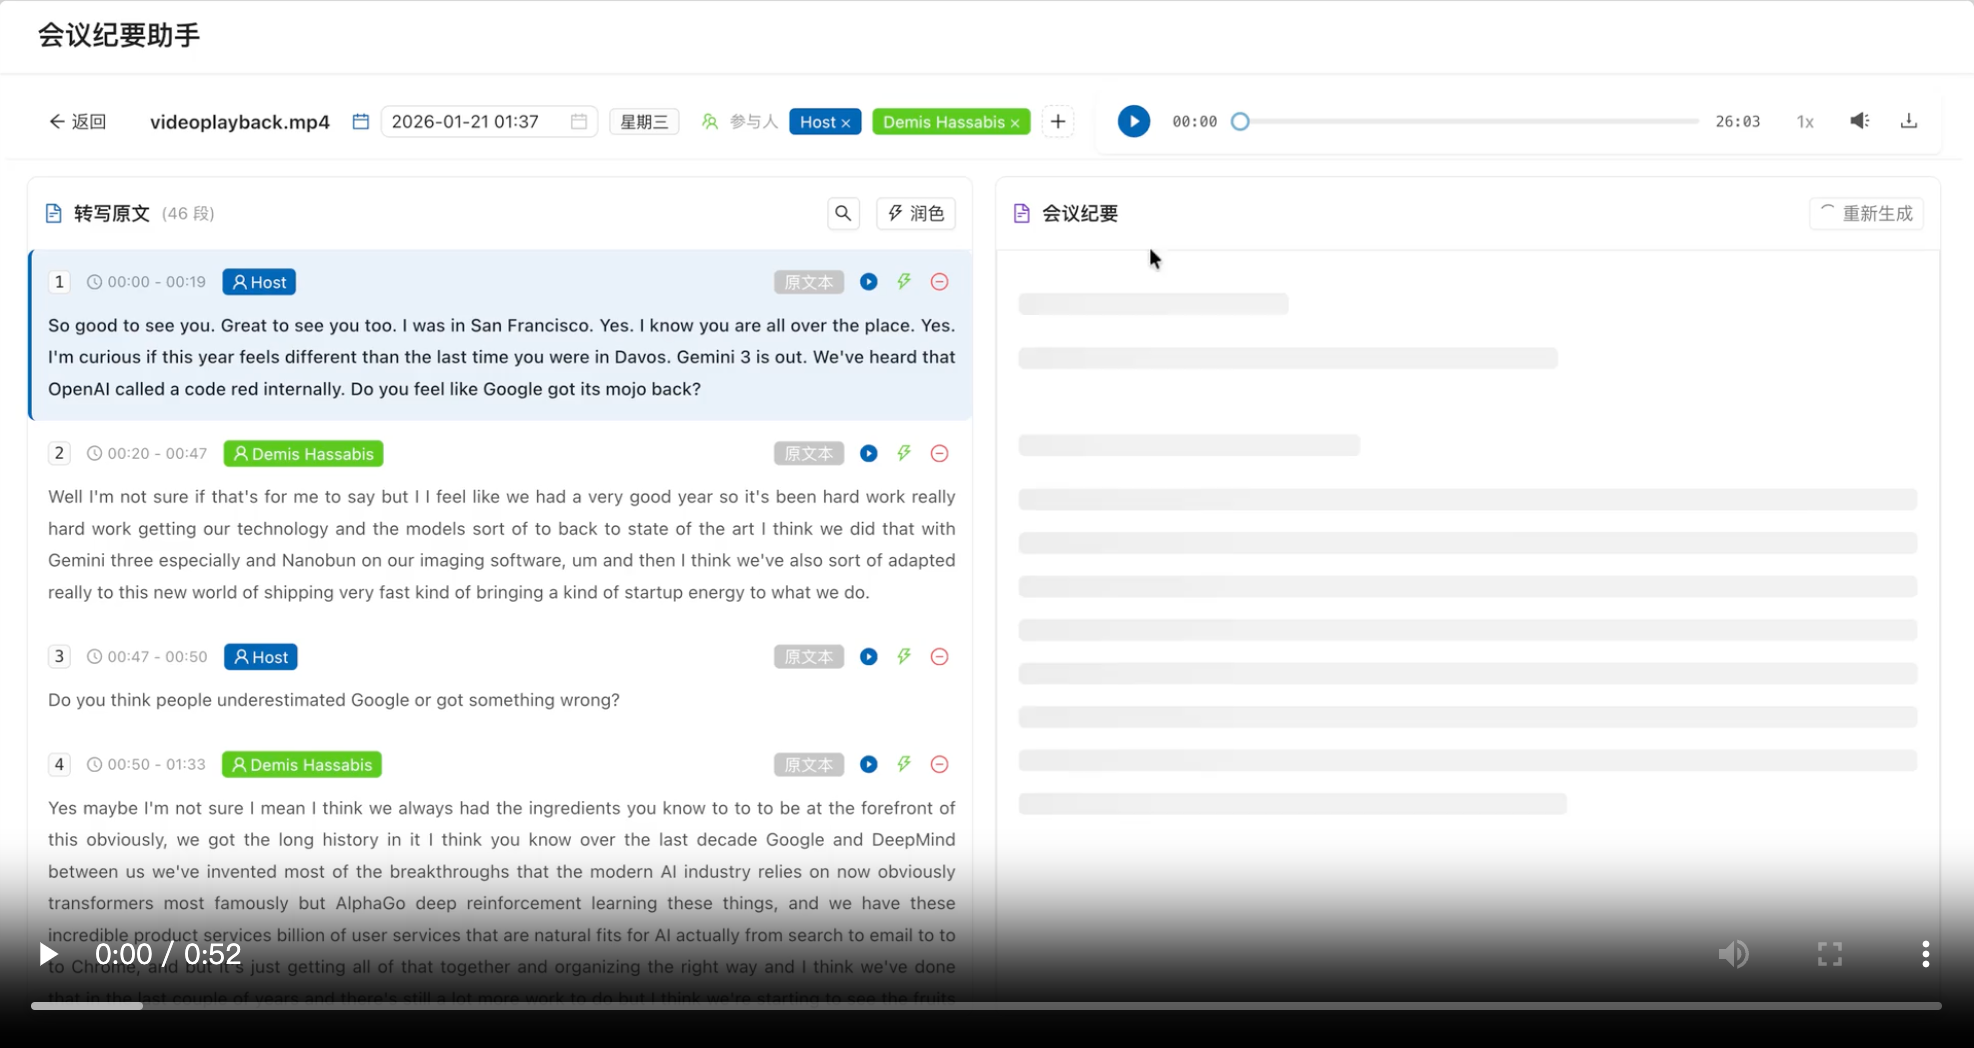
- Transcripción automática de archivos de audio (WAV/MP3) con diarización de hablantes y timestamps de palabras
- API compatible con OpenAI para integración en aplicaciones de terceros mediante SDK estándar
- Streaming en tiempo real de conversaciones vía WebSocket con etiquetas de hablante por frase
- Procesamiento offline en servidores Linux CPU o GPU NVIDIA con modelos pre-descargados
- Soporte nativo para Apple Silicon mediante backend Rust empaquetado, sin Docker ni GPU requeridas
- Modelos Confucius4-R2T2 y Nemotron-3-Diarization de Hugging Face con revisiones fijadas
- API OpenAI compatible en /v1/audio/transcriptions con soporte para diarización y timestamps
- Gestión unificada de modelos offline/realtime reduciendo redundancia computacional
- Requiere CUDA 13.0 para imágenes GPU; no compatible con versiones anteriores de drivers NVIDIA
- API REST compatible con Alibaba Cloud eliminada en la versión 1.0.4
- Dependencia de vLLM 0.30 que puede requerir actualizaciones de librerías CUDA específicas
- Modelos almacenados localmente en ./models consumen espacio significativo (10GB mínimo recomendado)
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Usar docker compose up -d para GPU o compose.cpu.yml para CPU. Montar directorio ./models con modelos pre-descargados o ejecutar prepare-models.sh offline. En macOS usar uv sync y start.py en puerto 8000 nativo. Verificar compatibilidad CUDA 13.0 antes de desplegar imágenes GPU.
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.