
Anonify2.0
Anonify2.0 es una herramienta de redacción asistida por IA que permite eliminar información sensible en documentos digitales como PDFs, Excel, Word y correos electrónicos.
Ficha actualizada 23 sept 2026, 13:37 · upstream 23 sept 2026, 13:12 · release v1.3.0
Qué es Anonify2.0
Descripción editorial construida a partir del repositorio, su documentación y sus señales de mantenimiento.
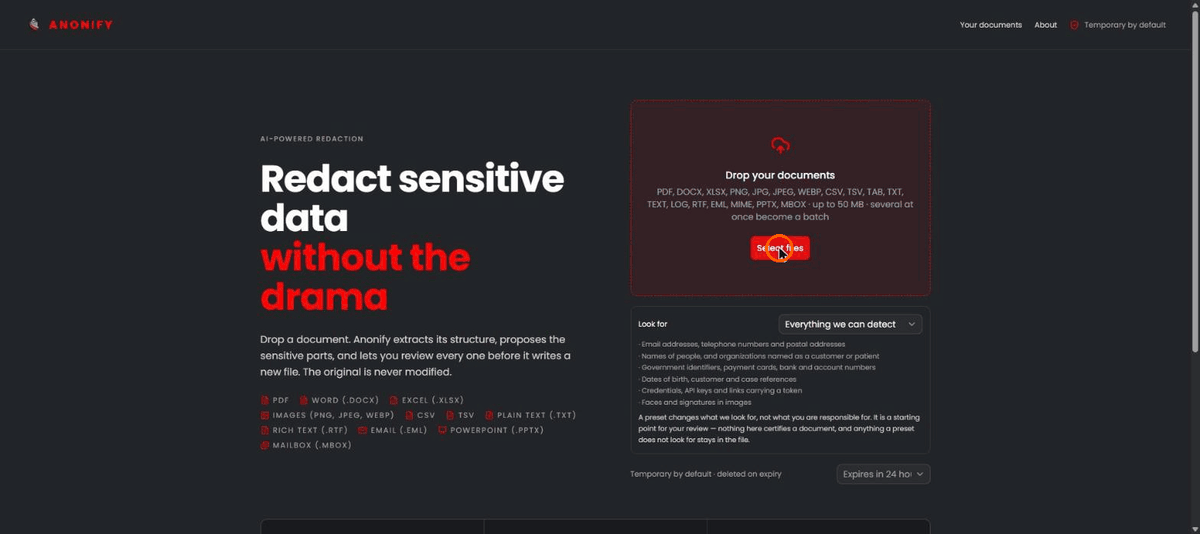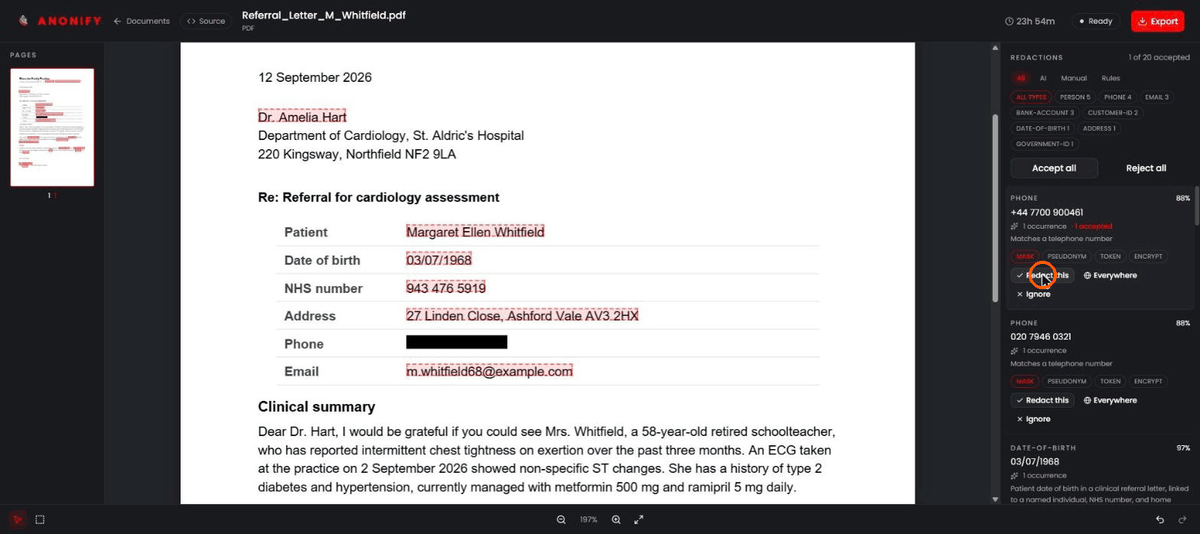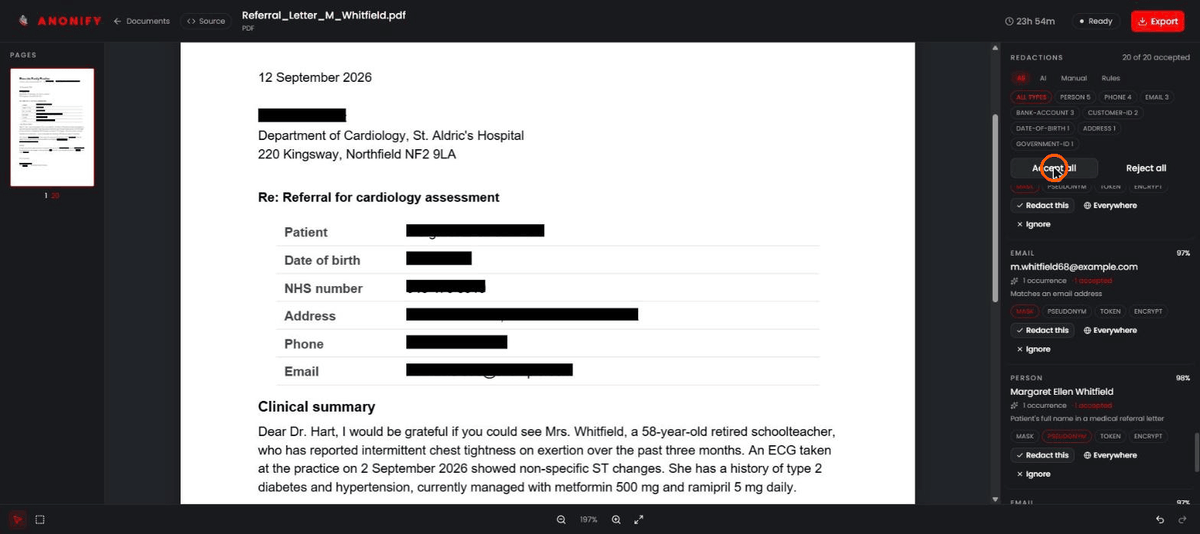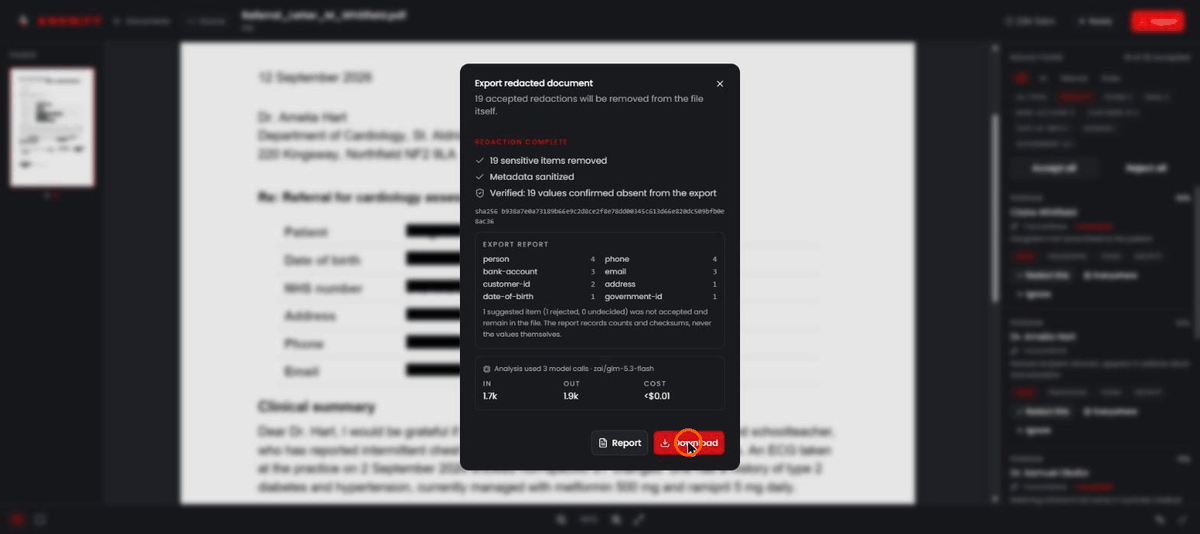
Anonify2.0 es un sistema de eliminación de datos sensibles asistido por inteligencia artificial para documentos digitales. El usuario sube archivos (PDF, Word, Excel, PowerPoint, correo electrónico, CSV, texto o imágenes) y el sistema propone qué información podría ser sensible. El usuario decide qué eliminar. La regla fundamental es que la IA propone, la aplicación aplica y solo lo que un humano aceptó se elimina.
El sistema opera en cuatro capas separadas: fuente (el archivo original nunca se modifica), normalización (estructura del documento), redacciones (registro de qué debe eliminarse) y salida (documento nuevo generado). Esto garantiza que el documento original se mantenga intacto, permitiendo verificación posterior.
Cada formato tiene pipelines especializados: PDF usa rasterización con cajas negras; Word edita en lugar de sustituir texto para preservar estilos; Excel reescribe celdas y filtra fórmulas que refieran valores eliminados; PowerPoint aplica la misma lógica a diapositivas, notas del presentador y masters. Correo electrónico se procesa como árbol donde cada mensaje es un documento independiente con todos sus encabezados revisables.
La seguridad se basa en verificación de exportación: cada archivo exportado se lee como lo haría un adversario para verificar que no sobrevive ningún dato sensible aceptado por el usuario. Esto convierte la herramienta de una simple redacción automática en un sistema de auditoría verificable.
- Eliminar datos personales (nombre, dirección, teléfono) de documentos confidenciales antes de compartirlos con terceros
- Proteger información financiera como tarjetas de crédito o números de cuenta en correos electrónicos compartidos
- Remover identificadores únicos (SSN, fechas de nacimiento, referencias a casos) de documentos legales y administrativos
- Eliminar credenciales de acceso (API keys, tokens, contraseñas) antes de publicar código o documentación pública
- Proteger información médica en correos electrónicos médicos o informes clínicos compartidos
- La regla fundamental es que la IA solo propone y el usuario decide: ningún dato se elimina sin aceptación explícita por un humano
- Cada formato tiene pipelines especializados diseñados para preservar información no sensible mientras eliminan lo relevante (por ejemplo, Word edita en lugar de sustituir texto)
- La verificación como gate: cada exportación se lee como si fuera una auditoría adversaria para asegurar que ningún dato aceptado sobreviva
- Los archivos originales nunca se modifican; solo se generan nuevos documentos con los datos eliminados, permitiendo trazabilidad completa
- El sistema soporta múltiples formatos simultáneamente en un solo flujo de trabajo, desde correo electrónico hasta imágenes
- La IA puede cometer errores y no siempre detecta correctamente información sensible, lo que requiere intervención humana para corregir
- Los documentos con texto muy similar (como correos electrónicos) pueden generar sugerencias falsas que requieren revisión manual
- No se puede redactar contenido que no exista en el documento original, por ejemplo, datos de páginas ocultas o archivos adjuntos desconocidos
- La verificación posterior requiere acceso al archivo original, lo cual puede ser problemático en entornos sin almacenamiento persistente
- El sistema no puede eliminar información sensible que no esté explícitamente detectada por sus pipelines actuales
Capturas del proyecto
Imágenes reales detectadas en la documentación del repositorio.
Perfil de infraestructura
Estimación inicial derivada del repositorio y de los servicios detectados.
Despliegue detectado
Qué señales reales de instalación hemos encontrado.
Se despliega con Docker usando un contenedor Node.js basado en Next.js y React, con PostgreSQL como base de datos principal y S3/MinIO para almacenamiento,Para producción se recomienda desplegar en Vercel con el plan Hobby (10GB RAM) o un plan empresarial con más recursos,Se debe configurar un límite de tiempo por archivo para evitar costos excesivos, especialmente en entornos de producción,Es necesario implementar autenticación robusta y cifrado en repositorio para proteger los datos sensibles del usuario,La arquitectura permite escalabilidad horizontal mediante contenedores independientes por formato (PDF, Excel, correo),Se recomienda mantener un registro de auditoría de cada exportación para cumplir con requisitos regulatorios
Stack y dependencias
Componentes inferidos a partir de manifests, configuración y documentación.
Puede sustituir a
Relaciones detectadas por el análisis del repositorio y su categoría.
Experiencia real de la comunidad
Ayuda a contrastar la estimación automática con instalaciones reales.
Todavía no hay datos comunitarios para este proyecto.